StandardScaler × PCA × LogisticRegression:
一條 Pipeline 與交叉驗證的 17 行程式
這段程式做的事是:拿乳癌資料,先標準化、再降維、最後分類,然後用 5 折交叉驗證評分。它藏了一個最容易被扣分的觀念——為什麼前處理一定要放進 Pipeline,而不能先對整份資料做。
00題目
使用 scikit-learn 的 Breast Cancer 資料集評估 StandardScaler、PCA 與 LogisticRegression 的組合。下列寫法將前處理放入 Pipeline,再交由交叉驗證執行:相較於先在完整 X 上執行 scaler.fit_transform(X) 與 pca.fit_transform(X),上述 Pipeline 在交叉驗證中最重要的優點為何?
 1  from sklearn.datasets import load_breast_cancer                       # 從 sklearn 的 datasets 模組,把「載入乳癌資料集」的函式拿到手上
 2  from sklearn.decomposition import PCA                                 # 拿 PCA(主成分分析),之後用來降維
 3  from sklearn.linear_model import LogisticRegression                   # 拿邏輯迴歸——名字是迴歸,工作是分類
 4  from sklearn.model_selection import StratifiedKFold, cross_val_score  # 一次拿兩樣:分層切折的規則+跑交叉驗證的執行者
 5  from sklearn.pipeline import Pipeline                                 # 拿 Pipeline——把多個步驟串成一條生產線
 6  from sklearn.preprocessing import StandardScaler                      # 拿標準化工具——把每欄變成平均 0、標準差 1
 7
 8  X, y = load_breast_cancer(return_X_y=True)                            # 真正載入資料:特徵表裝進 X、答案裝進 y
 9
10  pipe = Pipeline([                                                     # 開始組生產線,存進 pipe(( 是呼叫、[ 是開清單)
11      ("scale", StandardScaler()),                                      # 第 1 站:標準化("scale" 是自己取的名字)
12      ("pca", PCA(n_components=10)),                                    # 第 2 站:降到 10 維
13      ("clf", LogisticRegression(max_iter=2000))                        # 第 3 站:分類模型(行尾沒有逗號)
14  ])                                                                    # ] 關清單、) 關呼叫,生產線組完
15
16  cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)       # 切 5 折、切前先洗牌、亂數固定成 42
17  scores = cross_val_score(pipe, X, y, cv=cv, scoring="roc_auc")        # 跑 5 輪交叉驗證,得到 5 個 ROC-AUC 分數
—先說 scikit-learn 是什麼
整段程式的六個 import 全部來自同一個地方:scikit-learn——Python 上最主流的傳統機器學習工具箱。它不是 Python 內建的,要另外安裝。
它管什麼、不管什麼
| 做什麼 | 常見工具 | |
|---|---|---|
| 它擅長 | 表格型資料的傳統機器學習:分類、迴歸、分群、降維、前處理、模型評估與驗證 | scikit-learn |
| 它不做 | 深度學習(影像辨識、大型語言模型) | PyTorch、TensorFlow |
| 它不做 | 資料清洗與表格操作 | pandas |
| 它不做 | 底層數值運算(但它整個建立在這之上) | NumPy |
iPAS 中級的程式題幾乎都落在 scikit-learn 的守備範圍,所以把它的模組分區和三個動詞記熟,讀題速度會差很多。
本題用到的六個模組
scikit-learn 像一座圖書館,工具按用途分書架。這六個就是第 1–6 行分別去拿東西的地方:
| 模組(書架) | 放什麼 | 本題拿了什麼 |
|---|---|---|
datasets | 內建示範資料集 | load_breast_cancer |
preprocessing | 進模型前的加工 | StandardScaler |
decomposition | 矩陣分解與降維 | PCA |
linear_model | 線性模型族 | LogisticRegression |
model_selection | 切資料、驗證、調參 | StratifiedKFold、cross_val_score |
pipeline | 把步驟串成一條流程 | Pipeline |
為什麼它特別好學
因為所有工具長得一模一樣:不管是標準化、降維還是分類,動作都只有 fit()、transform()、predict() 這三個。學會一個就等於會全部,而這也正是 Pipeline 能把三個步驟焊成一條流程的原因。
pip install scikit-learn。注意安裝時叫 scikit-learn,程式裡卻寫成 sklearn,這兩個名字不一樣是歷史因素,初學者很常在這裡卡住。本頁所有分數是用 scikit-learn 1.8.0 實際跑出來的。—不熟 AI 專有名詞?你需要先認識下列名詞
點擊後出現漸進式說明:白話說明 → 說清楚一點 → 常見錯誤與考點。
—不熟 Python?你需要先認識下列名詞
點擊後出現漸進式說明。
01逐行拆解:第 1 行到第 17 行
17 行,前 6 行是把工具拿進來,第 8 行載入資料,第 10–14 行組裝流程,第 16 行定義切法,第 17 行才真的開始跑。
先認識一個符號:點 .
這是物件導向的寫法。scikit-learn 整套都建立在它上面——先做出一台機器,再叫這台機器做事,而「叫它做事」就是靠這個點。
sklearn.datasets   點的左邊是模組 唸「裡面的」
scaler.fit(X)      點的左邊是物件 唸「它的」

scaler.fit(X)      有括號 = 方法,叫它做一件事
X.shape            沒括號 = 屬性,看一格資料
第 1–6 行:匯入區
這六行的句型完全一樣:from 模組 import 名字,差別只在拿的是哪個東西。import 本身不執行任何運算,它只是把工具擺到桌上,讓你之後可以直接叫它的名字。
from sklearn.datasets import load_breast_cancer # 從 sklearn 的 datasets 模組,把「載入乳癌資料集」的函式拿到手上
sklearn.datasets 是 scikit-learn 收錄示範資料集的模組,裡面還有 load_iris(鳶尾花)、load_digits(手寫數字)、make_classification(自己生一份假資料)。這行只是把 load_breast_cancer 這個函式拿到手上,資料一筆都還沒讀進來——真正讀取是第 8 行。
名字全小寫加底線(load_breast_cancer)是 Python 對函式的命名慣例,看到這種長相就可以猜「它是一台做事的機器,加括號會吐東西出來」。
from sklearn.decomposition import PCA # 拿 PCA(主成分分析),之後用來降維
decomposition =分解。PCA 被放在這裡,是因為它的數學核心就是對資料的共變異矩陣做特徵分解,把矩陣拆成幾個主要方向。同一個模組裡還有 TruncatedSVD(適合稀疏矩陣)、NMF(非負矩陣分解)、FastICA。
PCA 是大寫開頭,代表它是一個類別,也就是「設計圖」,要加括號才會做出一台真的機器。這和第 1 行小寫的函式是兩種不同的東西。
from sklearn.linear_model import LogisticRegression # 拿邏輯迴歸——名字是迴歸,工作是分類
linear_model 收的是「輸出=輸入的線性組合」那一族:LinearRegression、Ridge、Lasso、ElasticNet、SGDClassifier。邏輯迴歸雖然是做分類,仍被歸在線性模型,因為它在套 Sigmoid 之前那一段確實是把特徵加權相加。
from sklearn.model_selection import StratifiedKFold, cross_val_score # 一次拿兩樣:分層切折的規則+跑交叉驗證的執行者
這是唯一一行拿兩樣東西的,用逗號分隔。兩者的分工要分清楚:
| 名字 | 角色 | 負責什麼 |
|---|---|---|
StratifiedKFold | 規則 | 資料怎麼切:切幾折、要不要洗牌、每折的類別比例怎麼維持。它自己不會訓練任何模型。 |
cross_val_score | 執行者 | 拿著上面那個規則,真的去跑:切折、訓練、預測、計分,最後回傳分數陣列。 |
model_selection 模組專門放「怎麼切資料、怎麼評估、怎麼調參」,常見的還有 train_test_split、GridSearchCV、cross_validate、KFold。
from sklearn.pipeline import Pipeline # 拿 Pipeline——把多個步驟串成一條生產線
用來把多個步驟串成一個整體。同模組還有 make_pipeline(不用自己取步驟名稱的簡寫版)與 FeatureUnion(把多組特徵並聯後接起來)。這行也只是把工具拿到手,還沒串任何東西。
from sklearn.preprocessing import StandardScaler # 拿標準化工具——把每欄變成平均 0、標準差 1
preprocessing =資料進模型之前的加工。這個模組是特徵工程的大本營:縮放、編碼、離散化都在這裡。這行拿的 StandardScaler 負責把每一欄變成「平均 0、標準差 1」,是最通用的縮放方式,也是 PCA 前面幾乎一定要接的一站。
| 工具 | 做什麼 | 什麼時候用它而不是 StandardScaler |
|---|---|---|
StandardScaler | 平均 0、標準差 1 | 本題用的,最通用 |
MinMaxScaler | 壓到 0~1 之間 | 需要固定值域時(例如餵給神經網路的影像) |
RobustScaler | 用中位數與四分位距 | 資料有明顯離群值,不想被極端值拉歪 |
OneHotEncoder | 類別欄位轉成 0/1 欄 | 處理的是文字類別而非數字 |
X, y = load_breast_cancer(return_X_y=True) # 真正載入資料:特徵表裝進 X、答案裝進 y
到這行資料才真的被讀進記憶體。拆成三塊看:
| 片段 | 意思 |
|---|---|
load_breast_cancer() | 括號就是啟動鈕——沒有括號只是「指那台機器」,加了括號它才會動。 |
return_X_y=True | 關鍵字參數:告訴它「我只要特徵和答案兩包,其他不用」。不加的話它會回傳一個大包裹,要自己拆 .data 和 .target。 |
X, y = | 多重指派:右邊一次吐出兩包,左邊兩個箱子分別接住。順序不能顛倒。 |
拿到的東西是:X = 569 筆 × 30 個特徵的表格,y = 569 個 0/1 答案。形狀分別寫成 (569, 30) 和 (569,)。
0 = 惡性 malignant、1 = 良性 benign——1 是好消息。scikit-learn 預設把標籤 1 當成正類,所以本題的 ROC-AUC 衡量的是「把良性排在惡性前面的能力」。它本質上仍是兩類的區分能力,數值不受影響。30 個特徵是 10 種測量 × 3 種統計:半徑、紋理、周長、面積、平滑度、緊密度、凹陷度、凹點數、對稱性、碎形維度,每種各取平均值、標準誤、最差值。為什麼要分成 X 和 y?
pipe = Pipeline([ # 開始組生產線,存進 pipe(( 是呼叫、[ 是開清單)
Pipeline 要收一個清單當參數,清單裡按順序放各個步驟。所以這行的結尾出現兩個括號連在一起:( 是呼叫 Pipeline、[ 是開一個 list 清單。這不是打錯字。
左邊的 pipe 是你自己取的變數名,換成 model、my_pipeline 都可以。
("scale", StandardScaler()), # 第 1 站:標準化("scale" 是自己取的名字)
每一站都寫成 ("步驟名稱", 工具物件) 這樣的一組,這種括起來的一組叫 tuple。
| 片段 | 是什麼 | 可以改嗎 |
|---|---|---|
"scale" | 你自己取的步驟名稱,加引號代表這是文字 | 可以。之後能用 pipe.named_steps["scale"] 把這一站抓出來檢查;做網格搜尋時寫成 scale__with_mean(兩個底線)指定這一站的參數。 |
StandardScaler() | 實際做出來的機器(注意有括號) | 括號裡可以放設定,例如 StandardScaler(with_mean=False)。這裡留空表示全用預設值。 |
結尾的逗號代表「還有下一站」。前面那四格縮排在括號內部只是為了好讀,怎麼排都不影響執行。
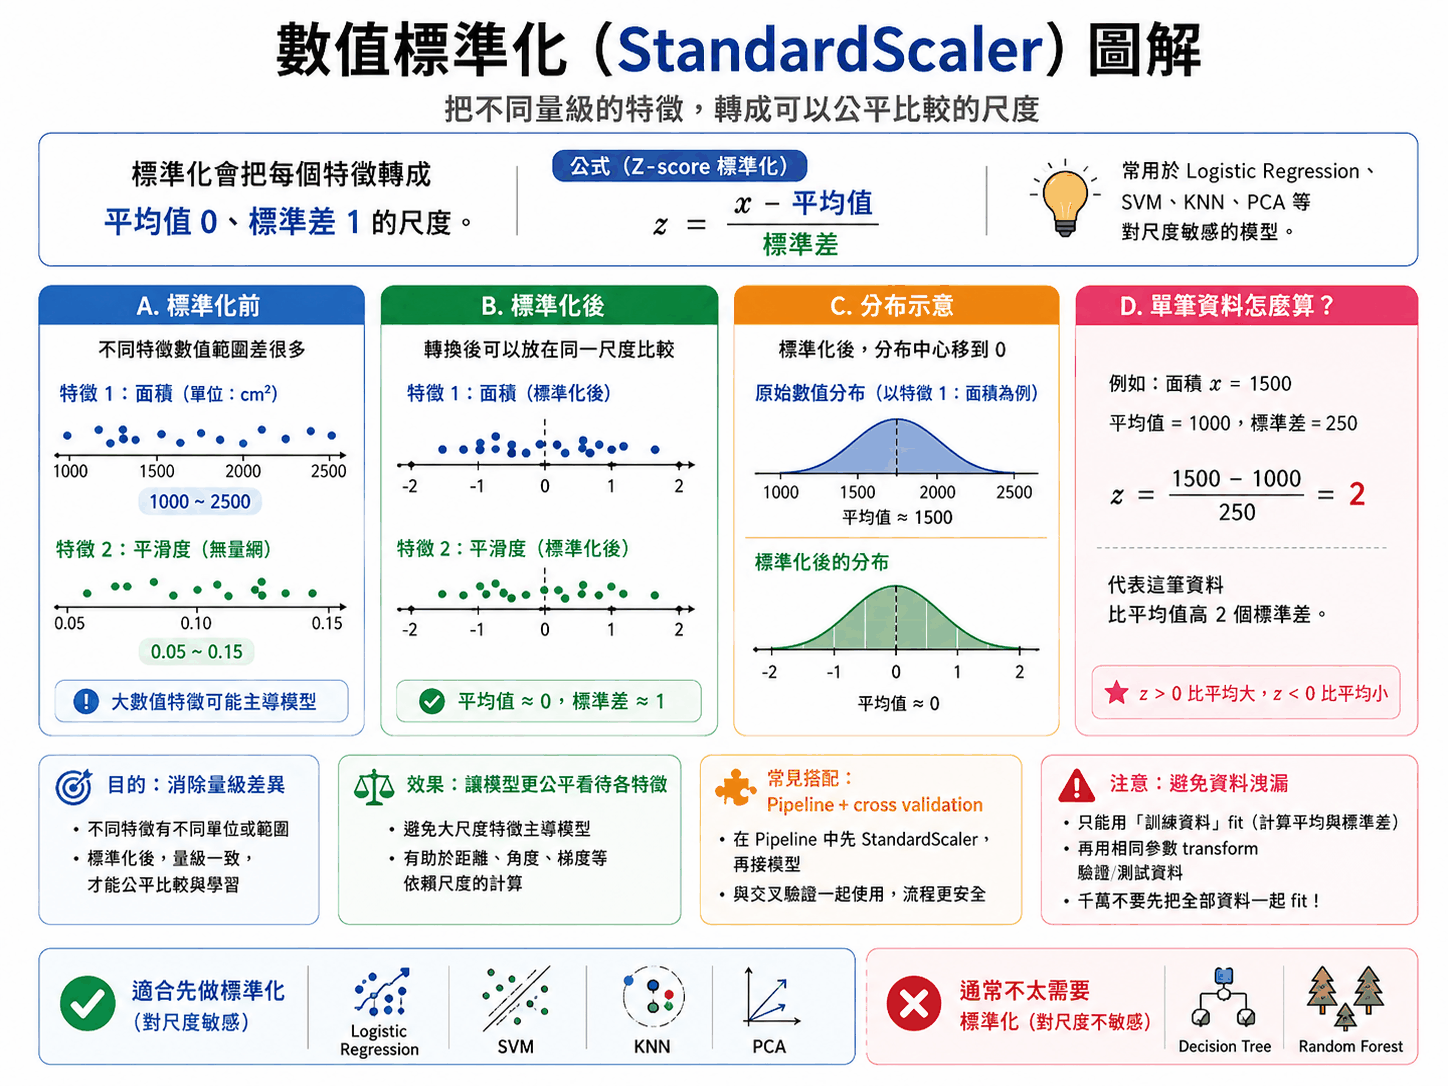
這一站在訓練時會做的事:從訓練資料算出每一欄的平均值與標準差並記住,然後把資料轉成 \(z=(x-\mu)/\sigma\)。詳細在 第 02 節。
("pca", PCA(n_components=10)), # 第 2 站:降到 10 維
n_components=10 表示最後保留 10 個主成分,所以資料形狀會從 (455, 30) 變成 (455, 10)(455 是一折的訓練筆數)。
10 是整數,不用加引號——加了就變成文字,會報錯。這個位置也可以填小數:PCA(n_components=0.95) 代表「自動選到累積解釋變異達 95% 為止」,這份資料剛好會選到 10 個。詳細在 第 03 節。
("clf", LogisticRegression(max_iter=2000)) # 第 3 站:分類模型(行尾沒有逗號)
"clf" 是 classifier(分類器)的慣用縮寫,跟 cv = cross-validation、pipe = pipeline 一樣純粹是取名。
這是 Pipeline 的最後一站。Pipeline 有個硬性規定:前面每一站都必須會 transform,只有最後一站可以是模型。
max_iter=2000 是最佳化的迭代次數上限,不是「一定要跑 2000 次」。詳細在 第 04 節。
注意這行結尾沒有逗號——因為它是清單的最後一項。(Python 其實允許最後一項後面也加逗號,加了不會錯。)
]) # ] 關清單、) 關呼叫,生產線組完] 關閉步驟清單、) 關閉 Pipeline 的呼叫,剛好跟第 10 行的 ([ 對稱。
pipe 代表整套處理流程——但一克原料都還沒送進去。這叫延遲執行:先把流程定義好,之後才餵資料。好處是同一條生產線可以重複用在不同資料上,也是交叉驗證能「每折重組一次」的前提。輸入原始 X
↓
① scale StandardScaler 每欄減平均、除標準差
↓
② pca PCA(10) 30 維 → 10 維
↓
③ clf LogisticRegression 輸出良性機率
↓
預測結果
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42) # 切 5 折、切前先洗牌、亂數固定成 42
三個關鍵字參數:
| 參數 | 意思 | 不設會怎樣 |
|---|---|---|
n_splits=5 | 切成 5 份 → 跑 5 輪,每筆資料被訓練 4 次、驗證 1 次 | 預設就是 5。切越多份越接近真實效能但越慢 |
shuffle=True | 切之前先洗牌 | 原始資料若有排序(前面都惡性、後面都良性),不洗牌會切出偏頗的折 |
random_state=42 | 固定亂數種子,每次執行結果一模一樣 | 因為有 shuffle,不固定的話每次跑分數都不同,沒辦法比較模型也沒辦法除錯。42 沒有統計意義,換成任何整數都行,重點是固定 |
Stratified(分層)是關鍵字:普通的 KFold 只管切成 5 等份,不管每份的類別比例;StratifiedKFold 會確保每一折的良性/惡性比例都跟整體一樣(62.7% 良性),避免切出「某一折幾乎全是良性」的荒謬結果。
跟第 10 行一樣,這行也只是定義規則,還沒真的去切。cv 這個名字是自己取的。
scores = cross_val_score(pipe, X, y, cv=cv, scoring="roc_auc") # 跑 5 輪交叉驗證,得到 5 個 ROC-AUC 分數
前三個是位置參數(照順序認人),後兩個是關鍵字參數:
| 參數 | 意思 |
|---|---|
pipe | 要評估的東西。注意這裡評估的不是單一模型,而是整條 Pipeline(標準化 → PCA → 邏輯迴歸)。 |
X | 輸入特徵,569 × 30 的原始資料——沒有先標準化、沒有先降維,全部交給 Pipeline 處理。 |
y | 每一筆的正確答案(0 惡性、1 良性)。 |
cv=cv | 左邊的 cv 是 sklearn 規定的參數名,右邊的 cv 是第 16 行建立的變數,兩者剛好同名而已。為什麼不是廢話? |
scoring="roc_auc" | 用 ROC-AUC 當評估指標。它需要連續的機率分數,所以 sklearn 會自動去呼叫 predict_proba 而不是 predict。詳細在 第 06 節。 |
它實際會做的事,是把下面這段跑 5 遍:
── 第 k 折 ────────────────────────────
  複製一套全新的 Pipeline(不沿用上一折學到的任何東西)

  【訓練折 455 筆】
    StandardScaler.fit        只從這 455 筆算平均值、標準差
    PCA.fit                   只從這 455 筆找 10 個主成分方向
    LogisticRegression.fit    用轉換後的資料訓練

  【驗證折 114 筆】
    StandardScaler.transform  用訓練折的平均值 / 標準差,不重學
    PCA.transform             用訓練折的主成分方向,不重學
    predict_proba → 計算這一折的 ROC-AUC
最後 scores 裡是 5 個數字。本題實跑結果:
array([0.99384, 0.99770, 0.98412, 1.00000, 0.99870])
        第1折     第2折     第3折     第4折    第5折

scores.mean()  → 0.9949    平均表現
scores.std()   → 0.0058    折與折之間的波動,越小越穩定
scores.mean() 這種寫法就是方法——scores 是一個 NumPy 陣列物件,mean() 是它自帶的功能,不用你自己寫迴圈加總再除以 5。
pipe。因為送進去的是整條 Pipeline 而不是「已經處理好的資料」,前處理才會被關在每一折裡面重新學一次——這就是本題答案 A 說的事。詳細在 第 05 節。02StandardScaler:把不同單位換成同一把尺
先講白話
一個人身高 175 公分、體重 70 公斤,哪個比較突出?直接比 175 和 70 完全沒有意義——它們單位不同、範圍不同。
要比較,你會問的是:「在同齡人裡,他的身高排第幾?體重排第幾?」——這才是公平的比法。標準化做的就是這件事。
本題資料的落差有多誇張
| 特徵 | 最小值 | 最大值 | 平均值 | 標準差 |
|---|---|---|---|---|
| mean area 面積 | 143.5 | 2501.0 | 654.89 | 351.60 |
| worst area 最差面積 | 185.2 | 4254.0 | 880.58 | 568.86 |
| mean perimeter 周長 | 43.79 | 188.5 | 91.97 | 24.28 |
| mean radius 半徑 | 6.981 | 28.11 | 14.13 | 3.52 |
| mean smoothness 平滑度 | 0.0526 | 0.1634 | 0.0964 | 0.0141 |
面積動輒上千,平滑度只有 0.1,差了將近兩萬倍。不處理的話會發生兩件事:
| 誰受害 | 怎麼受害 |
|---|---|
| PCA | 它找的是「變異最大的方向」,而面積的數字大到一個人就把方向決定了,平滑度再有用也被淹沒 |
| LogisticRegression | 梯度下降在尺度懸殊的空間裡走得歪七扭八,很難收斂 |
公式與單筆計算
\[ z = \frac{x - \mu}{\sigma} \qquad(\mu = \text{該欄平均值},\ \sigma = \text{該欄標準差}) \]
白話就是「你比平均高幾個標準差」。實際算一筆看看:
某筆資料的面積 x = 1500
這一欄的平均值 = 1000、標準差 = 250

z = (1500 − 1000) ÷ 250 = 2

→ 代表這筆資料的面積比平均高 2 個標準差
| z 的正負 | 意思 |
|---|---|
z > 0 | 比平均大 |
z = 0 | 剛好等於平均 |
z < 0 | 比平均小 |
整欄做完之後,這一欄的平均值會變成 0、標準差會變成 1。三十欄都做完,全部特徵就站在同一個量級上了。
互動實驗室:標準化前後對照真實資料 90 筆
誰需要、誰不需要
| 演算法 | 需要嗎 | 原因 |
|---|---|---|
| PCA | 強烈需要 | 直接找變異最大方向,數值大的欄位會通吃 |
| Logistic Regression | 需要 | 梯度下降收斂快很多;而且它預設帶 L2 正則化,會對所有係數一視同仁地懲罰 |
| KNN / SVM / K-means | 需要 | 都在算「距離」,尺度大的欄位主宰距離 |
| 決策樹 / 隨機森林 / XGBoost | 不需要 | 只比較「大於或小於某個門檻」,換刻度不影響切點 |
StandardScaler,還有兩個常見選擇:MinMaxScaler(壓到 0~1,需要固定值域時用)、RobustScaler(用中位數與四分位距,資料有明顯離群值時用)。ConvergenceWarning(迭代 2000 次還沒收斂)。加上 StandardScaler 後升到 0.9953,而且乖乖收斂。分數差距不大是因為這份資料本來就很好分,但「跑不收斂」本身就是尺度沒對齊的警訊。
fit,驗證/測試資料只能用同一組參數 transform。千萬不要先把全部資料一起 fit,那就是第 05 節要講的資料洩漏。03PCA 到底做了什麼
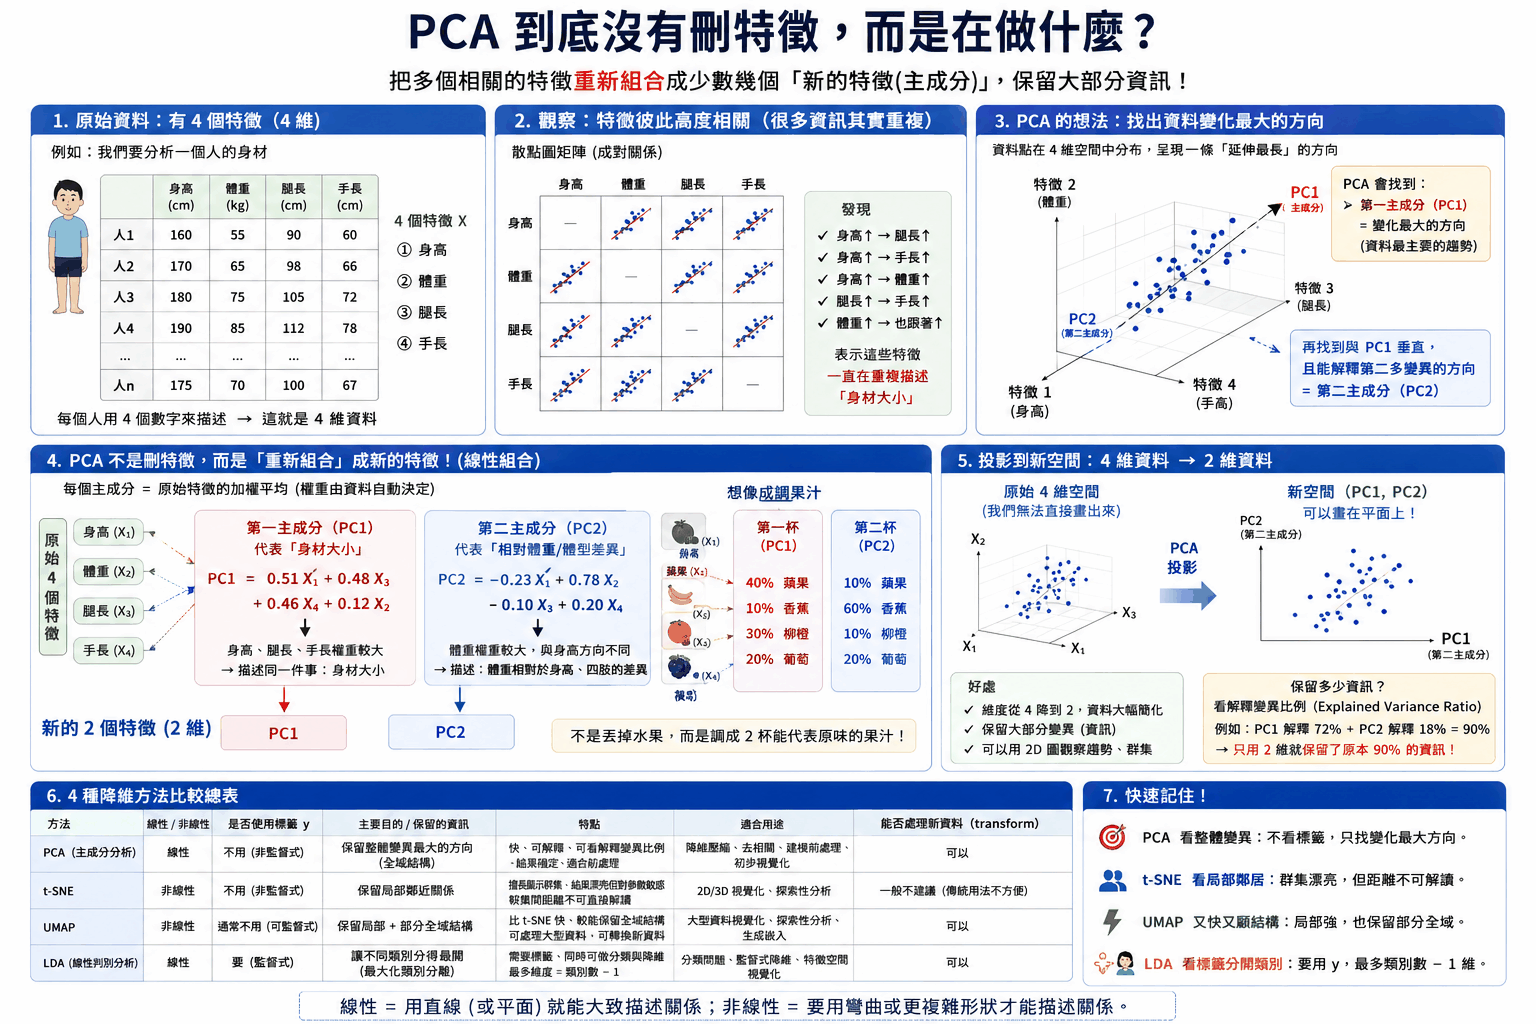
先講結論:PCA 沒有刪掉任何特徵
不是。PCA 是把很多特徵重新組合成少數幾個新的特徵。
用「身材」當例子
假設我們要分析一個人的身材,量了四個數字:
| 身高 (cm) | 體重 (kg) | 腿長 (cm) | 手長 (cm) | |
|---|---|---|---|---|
| 人 1 | 160 | 55 | 90 | 60 |
| 人 2 | 170 | 65 | 98 | 66 |
| 人 3 | 180 | 75 | 105 | 72 |
| 人 4 | 190 | 85 | 112 | 78 |
每個人用 4 個數字描述,這就是 4 維資料。但你應該已經發現了:
身高高 → 腿通常也長 → 手通常也長 → 體重通常也重
這四個特徵高度相關,一直在重複描述同一件事——身材大小。既然資訊重複,就有壓縮的空間。
它怎麼做:重新混合,不是挑選
PCA 不會說「腿長刪掉、手長刪掉」。它會造一個全新的欄位出來:
PC1 = 0.51 × 身高 + 0.48 × 腿長 + 0.46 × 手長 + 0.12 × 體重
      └─ 身高、腿長、手長權重較大 → 這一欄在描述「身材大小」

PC2 = 0.78 × 體重 − 0.23 × 身高 − 0.10 × 腿長 + 0.20 × 手長
      └─ 體重權重大、且與身高反向 → 這一欄在描述「相對胖瘦」
PC1 和 PC2 都不是原本任何一個欄位,而是四欄的加權組合,權重由資料自己決定。原本的四個特徵就這樣變成兩個新特徵。
想成調果汁
原本有蘋果、香蕉、柳橙、葡萄四種水果。PCA 不是說「柳橙不要、葡萄不要」,而是把它們調成兩杯果汁:
| 成分 | 第一杯(PC1) | 第二杯(PC2) |
|---|---|---|
| 蘋果 | 40% | 10% |
| 香蕉 | 10% | 60% |
| 柳橙 | 30% | 10% |
| 葡萄 | 20% | 20% |
換個場景:公司的營運資料
假設 ERP 系統裡有訂單數、出貨量、銷售金額、毛利四個欄位。它們的關係是:
訂單數↑ → 出貨量↑ → 銷售額↑
三個高度相關。PCA 跑完可能產生:
| 新特徵 | 實際上代表 | 由誰組成 |
|---|---|---|
PC1 | 公司營運規模 | 訂單數、出貨量、銷售額的加權和 |
PC2 | 獲利能力 | 毛利的權重最大 |
資料從 4 維變 2 維,但 PC1 已經包含了訂單、出貨、銷售額的資訊。
什麼時候壓不下來
PCA 能壓縮的前提是特徵之間有重複。如果四個特徵是這樣:
身高 英文成績 CPU 使用率 今天氣溫
彼此毫無關係,各講各的,那 PCA 就很難降維——因為沒有任何資訊是重複的,砍掉哪一維都會真的損失資訊。
為什麼叫「主成分」
因為它代表資料中最重要、最有代表性的方向。想像有 100 個人站在一起,幾乎排成一條斜線:
                    ●
                ●
            ●
        ●
    ●
PCA 會說:「與其記錄每個人的 X、Y 座標,不如直接記錄他在這條斜線上的位置。」
原本: (X, Y)  兩個數字
變成: PC1     一個數字,就描述了大部分資訊
它會把新造出來的軸由重要到不重要排序:第 1 主成分是資料變化最大的方向,第 2 主成分是跟第 1 垂直、變化次大的方向,以此類推。
保留了多少資訊:解釋變異數比例
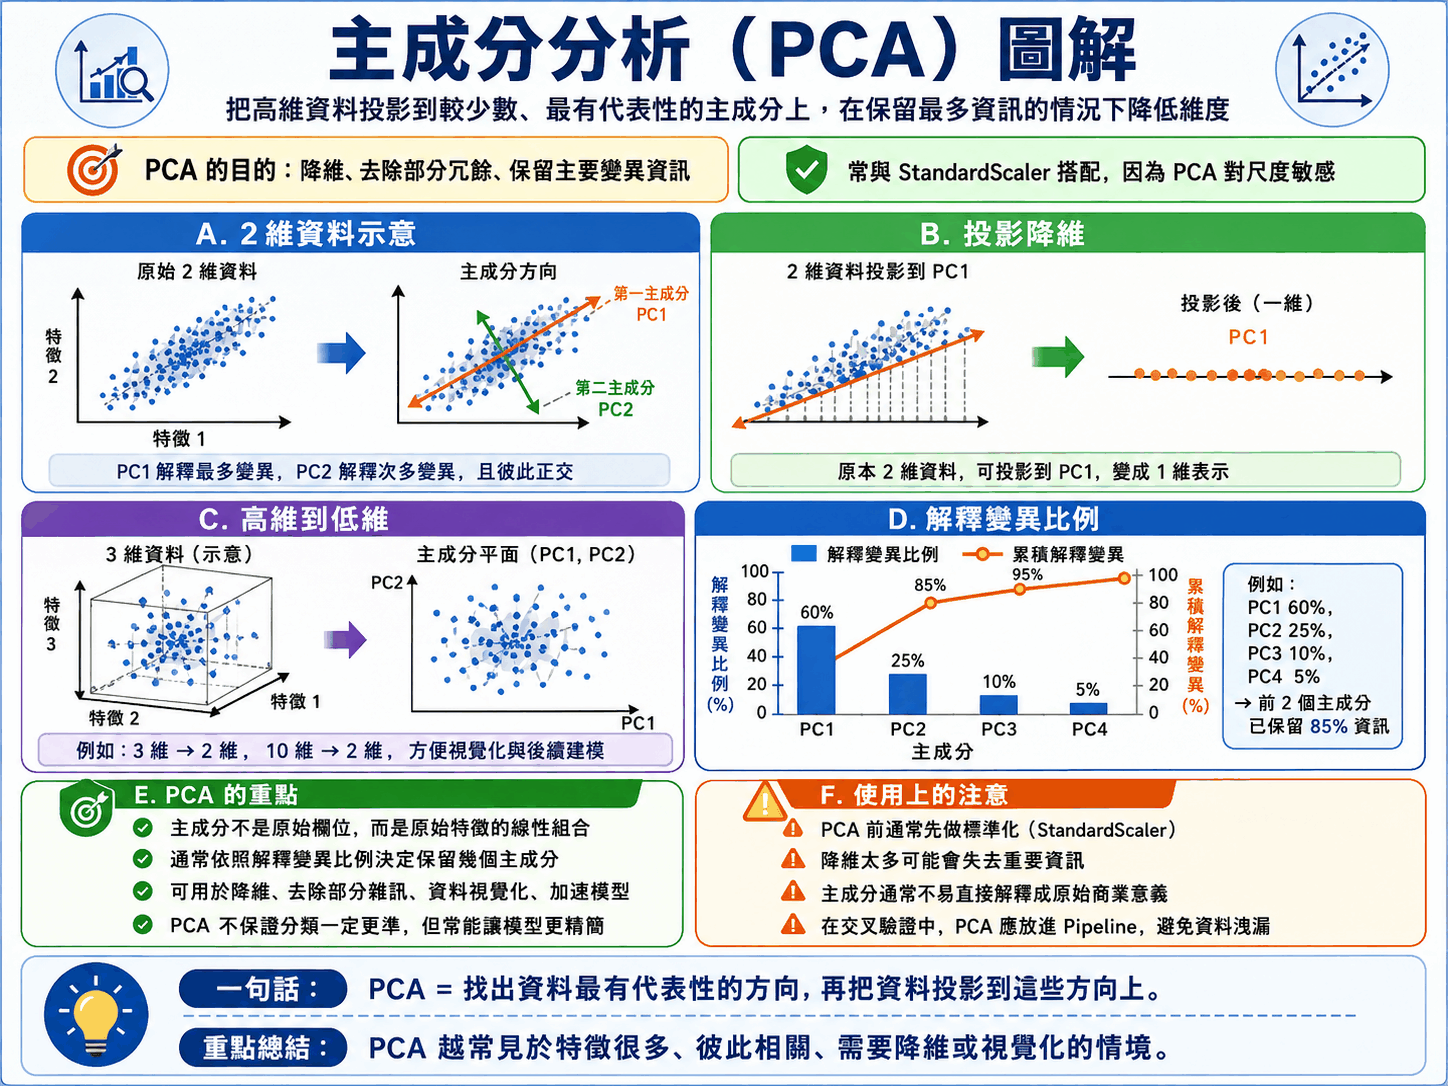
既然要丟掉一些軸,總得知道丟掉了多少。每個主成分能解釋多少比例的總變異,就叫 explained variance ratio。以本題標準化後的乳癌資料實跑:
前 10 個加起來是 95.16%——欄位砍掉三分之二,資訊只掉了不到 5%。這就是第 12 行選 10 的理由。
PCA(n_components=0.95) 代表「自動選到累積解釋變異達 95% 為止」——這份資料剛好會選到 10 個。互動實驗室:PCA 降維滑桿AUC 為實跑數據
「線性」是什麼意思
常常看到 PCA 被歸類成線性降維,這兩個字的意思其實很生活化:
非線性=要用彎線、曲線或更複雜的形狀才說得清楚。
線性:時薪固定 200 元
工作 1 小時 → 200 元
工作 2 小時 → 400 元
工作 3 小時 → 600 元

薪水
 ↑
 |          ●
 |       ●
 |    ●
 | ●
 +----------------→ 工時
每多工作 1 小時就固定多 200 元。輸入增加固定一點,輸出也增加固定的量——畫出來是一條直線。
非線性:車速與煞車距離
40 km/h  → 煞車距離 10 公尺
80 km/h  → 不只是 20 公尺,可能是 40 公尺
120 km/h → 可能增加到 90 公尺

煞車距離
 ↑
 |               ●
 |          ●
 |      ●
 |   ●
 | ●
 +----------------→ 車速
車速增加一倍,煞車距離增加不只一倍。輸入增加時,輸出的變化速度也一直在改變——畫出來是彎的。
放到資料分析裡
廣告費與銷量的關係,現實中通常是非線性的:剛開始投很有效,投到一定金額後效果變小,再繼續加銷量幾乎不再上升。
銷量
 ↑
 |             ● ● ●      ← 邊際效益遞減,直線描述不了
 |          ●
 |       ●
 |    ●
 | ●
 +----------------→ 廣告費
那降維方法的「線性」呢
在降維裡,線性/非線性可以想成:整理資料時,是不是只允許用「直線方向」。
PCA 只能找直的方向,它像拿一把直尺,找一條最能代表資料的方向再把點投影上去。所以:
| 資料長相 | PCA 適合嗎 |
|---|---|
| 像一條斜的直帶 | 很適合,一條直線就能代表 |
| 像彎曲的月牙 | 不適合,只能用直線壓縮,可能把原本離很遠的點疊在一起 |
遇到彎曲結構就要換 t-SNE 或 UMAP 這類非線性方法。
為什麼 PCA 不用標籤 y
先講「標籤」是什麼——每筆資料的正確答案,機器學習裡習慣用 y 表示。以乳癌資料為例:
半徑、面積、紋理、平滑度……   → 這些是輸入特徵,叫 X
這位病人真的是良性還是惡性     → 這是正確答案,叫 y
而 PCA 只想回答一個問題:這些特徵中,資料主要往哪些方向變化?它只看點的位置、距離與變異方向,完全不看哪個點是良性、哪個是惡性。所以它只需要:
pca.fit(X)          ← 只吃 X

不需要 pca.fit(X, y)  ← y 這個參數會被直接忽略
這也是本題選項 B 錯誤的根源——「PCA 會使用測試標籤 y 決定主成分」不可能發生。真的會用標籤決定投影方向的降維方法叫 LDA(線性判別分析),那才是監督式的。
四種降維方法比較
| 方法 | 線性? | 用標籤 y? | 保留什麼 | 適合用途 |
|---|---|---|---|---|
| PCA | 線性 | 不用(非監督) | 整體變異最大的方向(全域結構) | 降維壓縮、去相關、建模前處理 |
| t-SNE | 非線性 | 不用(非監督) | 局部鄰近關係 | 2D/3D 視覺化、探索性分析(群間距離不可解讀) |
| UMAP | 非線性 | 通常不用 | 局部+部分全域結構 | 大型資料視覺化,比 t-SNE 快 |
| LDA | 線性 | 要(監督式) | 讓不同類別分得最開 | 分類問題、監督式降維 |
優點、代價,與一個重要提醒
| 優點 | 代價 |
|---|---|
| 降低維度、減少計算量與過擬合風險 | 新特徵失去可解釋性(PC1 到底是什麼?很難用人話說清楚) |
| 去除特徵間的重複與共線性 | 可能丟掉變異小但對分類有用的資訊 |
| 壓到 2~3 維就能畫圖視覺化 | 對尺度極度敏感,沒先標準化等於白做 |
本題實跑:不降維(30 維)0.9953、降到 10 維 0.9949、降到 1 維掉到 0.9709。降維換到的是速度與簡潔,不是準確率。
fit 就是資料洩漏——這正是第 05 節的主題。04LogisticRegression:名字叫迴歸,工作是分類
先講白話:它其實做了三步
先把各個特徵加權打成一個總分 → 再把總分換算成 0~1 的機率 → 最後用門檻切成兩類。
像大學申請:各科成績乘上不同權重加起來得到總分,再對照落點分析表說「你這個分數大概有 85% 機會上」,最後才決定填不填。名字叫迴歸是因為前半段在算分數,工作是分類是因為後半段在判斷。
第一步:先做線性加權
\[ z = w_1x_1 + w_2x_2 + \dots + w_nx_n + b \]
假設要預測一位客戶會不會流失,模型看三個特徵:
| 特徵 | 權重 | 意思 |
|---|---|---|
年齡 x₁ | w₁ | 每個特徵都有自己的權重,權重越大影響越大。權重是模型訓練時自己學出來的,不是你設的。 |
消費金額 x₂ | w₂ | |
是否曾投訴 x₃ | w₃ |
把三項加權相加得到一個分數 z。這一段確實就是線性迴歸,所以它被歸在 linear_model 模組。
但 z 是個沒有上下限的數字(可能是 −8、也可能是 +23),沒辦法直接當機率用。
第二步:再經過 Sigmoid
\[ p = \frac{1}{1+e^{-z}} \]
Sigmoid 是一個 S 形的轉換器,負責把任意分數壓進 0~1 之間:
| 線性分數 z | 機率 p | 意思 |
|---|---|---|
| 很小的負數 | 接近 0 | 幾乎確定不是正類 |
| 剛好 0 | 剛好 0.5 | 完全說不準 |
| 很大的正數 | 接近 1 | 幾乎確定是正類 |
再怎麼有把握,機率也不可能超過 100%;再怎麼沒把握,也不會是負的——這個「封頂與封底」就是 Sigmoid 在做的事。
第三步:用門檻切成兩類
p = 0.82  →  判為 正類
p = 0.61  →  判為 正類
p = 0.32  →  判為 負類

常見門檻:0.5(可依需求調整)
因為 z = 0 時 p 剛好是 0.5,所以「門檻 0.5」其實就是「分數 0」那條界線。
算一筆給你看
假設某筆資料算出來 z = 1.5

p = 1 ÷ (1 + e^(−1.5)) ≈ 0.82

如果門檻 = 0.5,因為 0.82 ≥ 0.5 → 判定為正類
這也是為什麼本題能算 ROC-AUC——它需要的正是這種連續分數,所以 sklearn 會自動去呼叫
predict_proba 而不是 predict。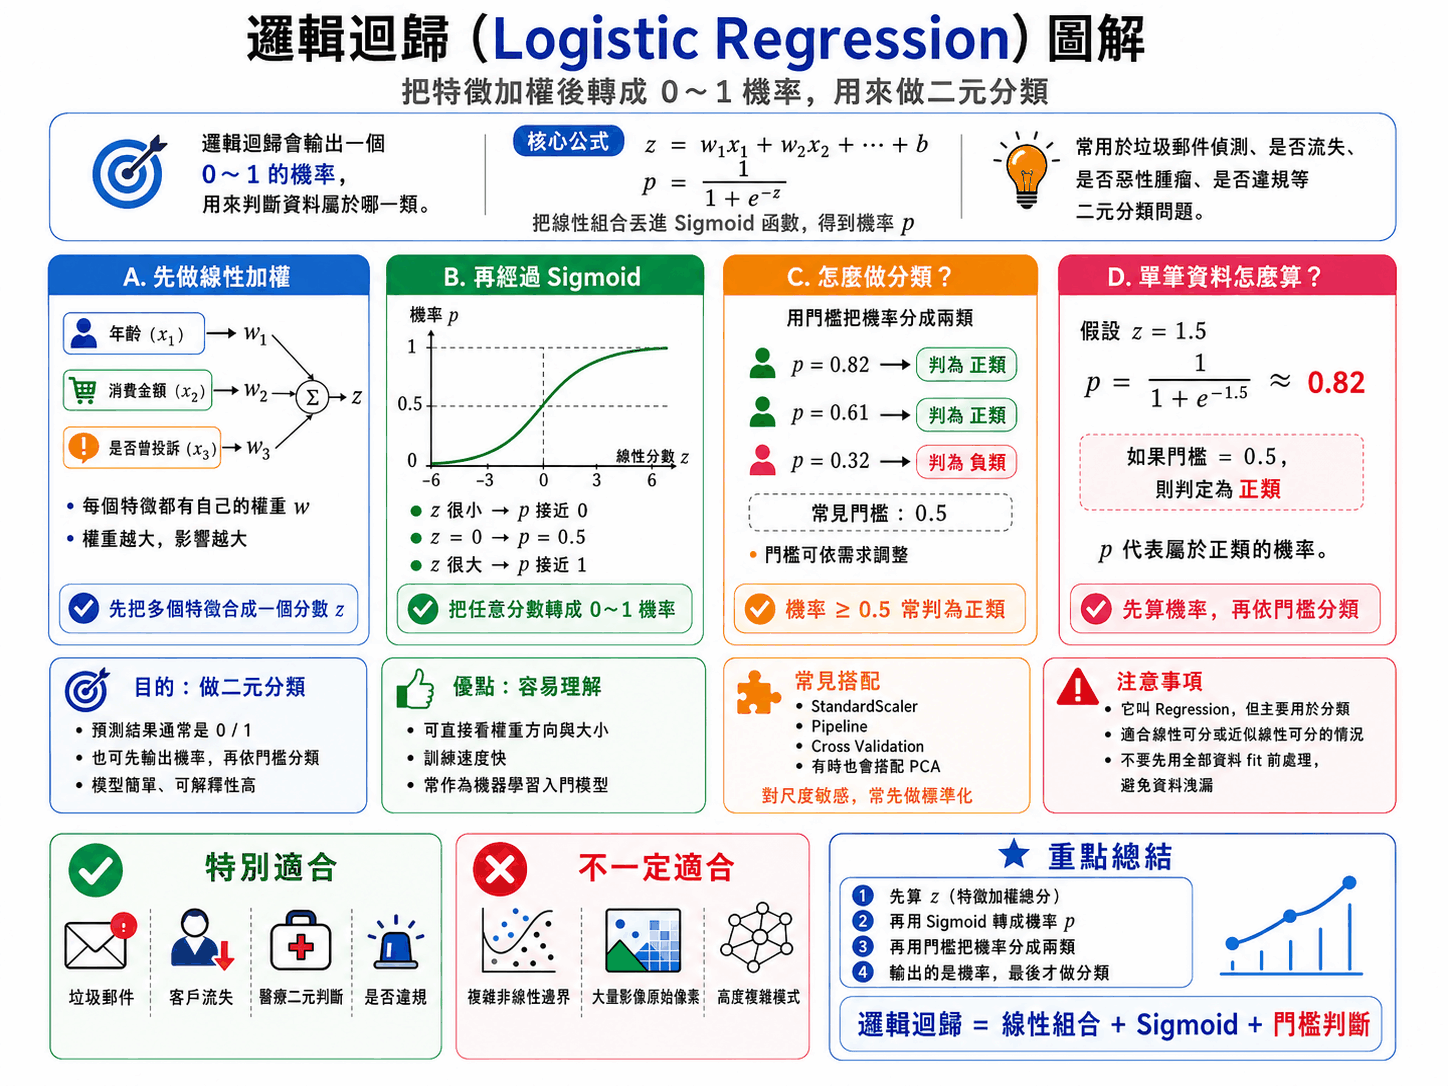
它適合什麼、不適合什麼
| 情境 | 原因 | |
|---|---|---|
| 特別適合 | 垃圾郵件偵測、客戶流失預測、醫療二元判斷、是否違規 | 二元分類、特徵有意義、需要看得懂模型在想什麼 |
| 不一定適合 | 複雜非線性邊界、大量影像原始像素、高度複雜的模式 | 它只能畫出一條直線(或平面)當分界,太彎曲的邊界畫不出來 |
max_iter=2000 在幹嘛
權重不是一次算出來的,是反覆微調出來的(預設用 lbfgs 演算法):調一次、看有沒有變好、再調,直到幾乎不再進步為止——這叫收斂。
就像調吉他弦,一邊轉一邊聽,調準了就停手;但你心裡也會有個底:「轉五十次還調不準,那大概是弦有問題,別再耗了」。max_iter 就是那個上限。
| 情況 | 會發生什麼 |
|---|---|
| 第 180 次就收斂 | 提早停止。max_iter 是上限,不是「一定要跑幾次」 |
| 2000 次還沒收斂 | 印出 ConvergenceWarning,用目前最好的權重交差,結果可能不是最佳解 |
max_iter=100 就足夠收斂;不標準化時,即使給到 2000 次也照樣噴警告。所以把 max_iter 調大只是止痛藥,把資料標準化才是治本——sklearn 的警告訊息本身就寫著「You might also want to scale the data」。
05核心考點:Pipeline 與資料洩漏
先看完整的錯誤版程式
很多人會這樣寫,因為看起來比較直覺:先把資料處理好,再拿去做交叉驗證。整段長這樣:
# 錯誤版
from sklearn.datasets import load_breast_cancer                       # 從 sklearn 的 datasets 模組,把「載入乳癌資料集」的函式拿到手上
from sklearn.decomposition import PCA                                 # 拿 PCA(主成分分析),之後用來降維
from sklearn.linear_model import LogisticRegression                   # 拿邏輯迴歸——名字是迴歸,工作是分類
from sklearn.model_selection import StratifiedKFold, cross_val_score  # 一次拿兩樣:分層切折的規則+跑交叉驗證的執行者
from sklearn.preprocessing import StandardScaler                      # 拿標準化工具——把每欄變成平均 0、標準差 1

X, y = load_breast_cancer(return_X_y=True)  # 真正載入資料:特徵表裝進 X、答案裝進 y

scaler = StandardScaler()                   # 做一台標準化機器
X_scaled = scaler.fit_transform(X)          # ← 用「全部 569 筆」算平均值與標準差

pca = PCA(n_components=10)                  # 做一台降維機器(保留 10 維)
X_pca = pca.fit_transform(X_scaled)         # ← 用「全部 569 筆」找主成分方向

clf = LogisticRegression(max_iter=2000)                          # 做一台分類模型
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)  # 切 5 折、切前先洗牌、亂數固定成 42

scores = cross_val_score(clf, X_pca, y, cv=cv, scoring="roc_auc")  # 拿「已經整份處理過」的資料去交叉驗證
                                # ↑ 到這裡才切折
這段程式跑得起來、不會報錯、分數還很漂亮——所以最危險。跟正確版對照,差別只有一個:前處理是在切折之前做,還是之後做。
| 順序 | 錯誤版 | Pipeline 版 |
|---|---|---|
| 第 1 步 | 算全部 569 筆的平均值與標準差 | 先切折 |
| 第 2 步 | 用全部 569 筆找主成分方向 | 只用訓練折 455 筆算平均值與標準差 |
| 第 3 步 | 切折 | 只用訓練折 455 筆找主成分方向 |
| 第 4 步 | 訓練、考試 | 訓練、考試 |
先澄清一個常見誤會:偷看到的不是「答案」
y,所以它們不可能偷看答案。洩漏的是另一種東西——驗證折的「數值」參與了轉換規則的制定。
| 兩種洩漏 | 偷看到什麼 | 本題屬於哪種 |
|---|---|---|
| 看到答案 | 前處理用到了 y,例如 SelectKBest 挑出「跟答案最相關」的欄位 | 不是這種 |
| 看到考卷 | 前處理只用 X,但驗證折的數值被拿去算平均值、標準差、主成分方向 | 就是這種 |
用考試比喻:不是把解答外流,而是老師先看過全班的答案卷(包括那 114 份),才據此訂出計分標準。答案沒外洩,但規則已經被那 114 份影響了——所以拿這個規則去評他們,評不出真實水準。
洩漏到底發生在哪一秒
關鍵在「平均值是怎麼算出來的」。攤開來看:
全部 569 筆的平均面積 = 654.9
                        ↑
   = (第 1 筆 + 第 2 筆 + 第 3 筆 + … + 第 569 筆) ÷ 569
                        ↑
        這個加總裡面,包含了之後要拿來當考卷的那 114 筆
等到後面把驗證折拿來標準化時,你是拿「一個已經含有它自己在內的平均值」去減它——這筆資料早就不是「模型從沒見過的新病人」了。
PCA 更誇張。它找的主成分方向,是看整批資料往哪邊散開算出來的——而這批資料裡就有那 114 筆。等於那些「未來的新病人」早就參與過投影方向的設計。
同一筆資料,兩種做法算出來不一樣
光講原理還是很抽象,直接算給你看。以 mean area(平均面積)這一欄、第 1 折為例(以下全是實跑數字):
用全部 569 筆算   平均 654.8891 標準差 351.6048   ← 錯誤版用這組
只用訓練折 455 筆算 平均 655.7248 標準差 364.2458   ← Pipeline 版用這組
                        ↑ 差 0.84        ↑ 差 12.64
兩組數字不一樣——因為前者多算進了 114 筆驗證資料。接著拿第 0 筆(它剛好是第 1 折的驗證資料,也就是「考卷」)來轉換:
第 0 筆的原始面積 = 1001.0

錯誤版:  z = (1001.0 − 654.8891) ÷ 351.6048 = +0.984375
正確版:  z = (1001.0 − 655.7248) ÷ 364.2458 = +0.947918
                        ↑
              同一筆資料,被轉換成兩個不同的數字
這筆資料的面積是 1001.0,它對「全部 569 筆平均值」的貢獻是
1001.0 ÷ 569 = 1.7592。也就是說,654.8891 這個數字裡,有 1.7592 是它自己貢獻的——它在拿「含有自己」的平均值來減自己。
正確版的 655.7248 完全不含它,才是乾淨的。
PCA 也一樣。用全部 569 筆算出的第一主成分方向,和只用訓練折 455 筆算出的方向,兩者夾角餘弦是 0.999530——非常接近但不相同。那 114 筆確實把方向拉動了一點點。
但差距小不代表做法對——換成樣本少的資料、或前處理用到
y,同樣的錯誤會造成災難級的落差。本節後面的「純亂數」實驗就是例子。換成考試來想
假設老師要評估自己的教學成效,於是說:「我從班上 569 人裡挑 114 人當作『沒教過的學生』來測驗。」
| 做了什麼 | 合理嗎 | |
|---|---|---|
| 錯誤版 | 先把全班 569 人的答案卷收來算出平均分數與標準差,訂出計分標準;然後才宣布「這 114 人算沒教過的」 | 不合理。那 114 人的答案已經參與過計分標準的制定,考試前就先影響了規則 |
| Pipeline 版 | 先把 114 人的卷子封起來,只用剩下 455 人的答案訂計分標準,最後才拆封批改那 114 人 | 合理。那 114 人對規則零影響,真的是「沒見過」 |
洩漏出去的東西,具體長什麼樣
洩漏聽起來很抽象,但它有明確的存放位置——就是那幾個尾巴帶底線的屬性:
| 變數 | 裡面裝什麼 | 被誰汙染 |
|---|---|---|
scaler.mean_ | 30 欄各自的平均值 | 全部 569 筆都參與了計算,包含之後要當驗證折的那 114 筆 |
scaler.scale_ | 30 欄各自的標準差 | |
pca.components_ | 10 個主成分的方向 |
之後不管 cross_val_score 怎麼切折,模型拿到的都是用這幾組被汙染的數字轉換過的資料。切折切得再乾淨也沒用——資料在被切之前就髒了。
驗證折到底貢獻了哪些資訊
即使完全不看 y,驗證折仍然貢獻了這些關於 X 的資訊:
- 每一欄的平均值與標準差(被 StandardScaler 學走)
- 整體的變異程度與特徵之間的相關結構(被 PCA 學走)
- 因此主成分方向是為了「包含驗證折在內的那份資料」而最佳化的
y。反過來說,「把公斤換成公克」這種固定規則的轉換就完全沒問題——它不需要看資料,乘個 1000 就好。
後果:分數會虛高,而且你看不出來
模型真正上線時遇到的新病人,不可能參與過訓練時的平均值計算——那個人當時根本還沒來看診。
交叉驗證存在的意義,就是預先模擬這種「完全沒見過」的情況。而錯誤版沒有模擬到,它給的是一個比真實情況樂觀的數字。等到上線才發現落差,通常已經來不及了。
Pipeline 怎麼堵住這個洞
呼叫 pipe.fit(X_train, y_train) 時,內部自動這樣做:
前面每一站(scale、pca)→ fit_transform(訓練資料)      學參數 + 轉換
最後一站(clf)        → fit(轉換後資料, y_train)       訓練模型
呼叫 pipe.predict(X_val) 時:
前面每一站(scale、pca)→ 只呼叫 transform(驗證資料)     用訓練學到的參數,不重學
最後一站(clf)        → predict()
transform,從來沒有被 fit 過。它完美扮演了「未來的新病人」。Pipeline 天生就分得清「什麼時候該 fit、什麼時候只能 transform」——你自己手寫很容易搞混,Pipeline 不會。互動實驗室:Pipeline 逐步追蹤器比較訓練與驗證的差別
互動實驗室:5 折交叉驗證動畫每折分數為實跑數據
互動實驗室:資料洩漏對照實驗兩組數字都是實跑
先對完整 X 做 fit_transform
放進 Pipeline 交給 cross_val_score
但只要換成樣本少、或前處理用到 y(特徵選擇、目標編碼、SMOTE、用整體平均補缺失值),差距就會非常誇張。上面那個「純亂數」按鈕就是例子:資料完全是隨機的、真實 AUC 應該是 0.5,洩漏版卻報出 0.929。
所以正確做法不是「看情況」,而是養成永遠用 Pipeline 的習慣。
06ROC-AUC 是什麼
先把模型想成一台「風險評分器」
模型其實不只回答「是惡性還是良性」這種是非題。它做的第一件事,是給每位病人一個分數:
| 病人 | 模型判斷為惡性的風險 |
|---|---|
| A | 95% |
| B | 82% |
| C | 61% |
| D | 35% |
| E | 8% |
分數越高,模型越認為可能是惡性。要變成「是/不是」的答案,還得再畫一條線。
為什麼需要設定門檻
假設我們規定:風險 ≥ 50% 判定為惡性、< 50% 判定為良性。這個 50% 就是判定門檻。
但門檻不一定要是 50%,而且調高調低各有代價:
| 門檻 | 會發生什麼 | 代價 |
|---|---|---|
| 降到 20% | 風險 ≥ 20% 就判惡性 → 抓到更多真正的惡性病例 | 很多良性也被誤判成惡性,誤報變多 |
| 維持 50% | 折衷 | — |
| 提高到 80% | 只有很確定才判惡性 → 誤報減少 | 可能漏掉真正的惡性病例 |
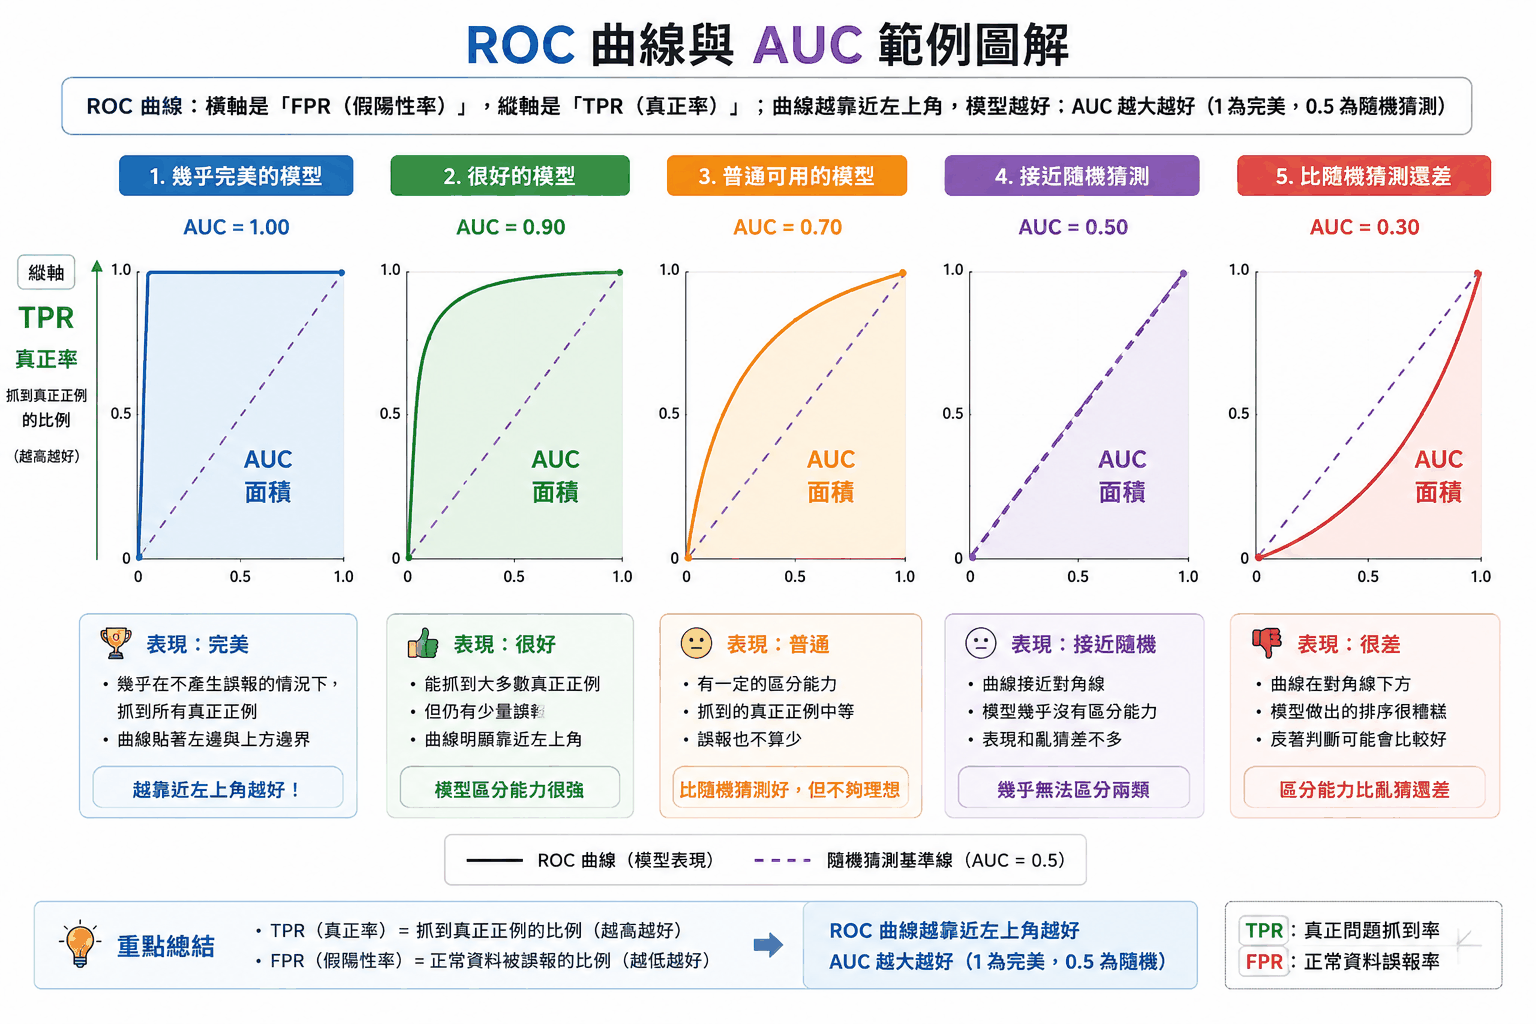
ROC 是什麼
既然門檻可以任意調,那乾脆全部都試一遍——10%、20%、30%……90%,然後在每個門檻下記錄兩件事:
- 真正的惡性病例,抓到了多少(縱軸)
- 良性病例,被誤判成惡性的比例是多少(橫軸)
把這些點連起來,就是 ROC 曲線。
對照上面兩個軸,那就是「往上」而且「往左」——所以ROC 曲線越靠近左上角,代表模型越好。
AUC 是什麼
AUC 全名 Area Under the Curve,也就是 ROC 曲線下方的面積。它把整條曲線濃縮成一個數字,通常介於 0.5 到 1.0 之間:
| ROC-AUC | 白話解釋 |
|---|---|
| 0.5 | 跟隨機猜差不多 |
| 0.6 | 區分能力較弱 |
| 0.7 | 有一定區分能力 |
| 0.8 | 區分能力良好 |
| 0.9 | 區分能力非常好 |
| 1.0 | 完美區分 |
這只是粗略解讀,實際好不好仍要看醫療、資安、金融等應用情境。實務上看到 1.0 通常要先懷疑資料洩漏。
最淺顯的理解方法
如果 AUC = 0.90,大致可以理解為:模型約有 90% 的機會,把應該排在高風險的那一位排得更前面。
所以 ROC-AUC 評估的是——模型有沒有能力把兩種類別正確排序。它問的是排序能力,不是判斷力。
完美的模型   ●●●●●●●●●●●●●●●●│●●●●●●●●●●●   AUC = 1.0
             ← 一類全在左邊 ─┤─ 另一類全在右邊 →

沒用的模型   ●●○●○○●●○●○●●○●○○●●○●○●●○●●○●   AUC = 0.5
             ← 兩色交錯,排了等於沒排 →
互動實驗室:ROC-AUC 到底在量什麼拖動看 AUC 怎麼變
跟 Accuracy 有什麼不同
| 看幾個門檻 | 回答的問題 | |
|---|---|---|
| Accuracy | 只看一個(通常是 0.5) | 在這一個判定標準下,答對多少題 |
| ROC-AUC | 全部都看 | 整體而言,模型能不能把兩種類別排對順序 |
所以 Accuracy 只代表模型在那個門檻下的結果;門檻一換,數字就變。AUC 不會——上面的實驗室拖門檻就能看到這件事。
用保全警報器來理解
假設一台警報器可以調整敏感度:
| 敏感度 | 結果 |
|---|---|
| 非常敏感 | 風吹草動就響 → 真正的小偷很少漏掉,但貓經過也會警報 |
| 不太敏感 | 只有很明顯的入侵才響 → 誤報比較少,但可能漏掉真正的小偷 |
ROC 曲線就是測試這台警報器在各種敏感度下的表現;AUC 則用一個數字表示:這台警報器整體區分「真正入侵」與「正常狀況」的能力有多好。
放回你的程式裡
scores = cross_val_score(pipe, X, y, cv=cv, scoring="roc_auc") # 跑 5 輪交叉驗證,得到 5 個 ROC-AUC 分數
這一行的意思是:在每一折交叉驗證中,評估模型區分兩種類別的整體排序能力,而不只看固定門檻下的準確率。
最後得到五個分數(本題實跑):
array([0.99384, 0.99770, 0.98412, 1.00000, 0.99870])

scores.mean()  → 0.9949    平均表現
scores.std()   → 0.0058    折與折之間的波動,越小越穩定
0.9949 代表這套 StandardScaler → PCA → LogisticRegression 具有很強的兩類區分能力。平均值回答「這個流程大概多強」,標準差回答「這個估計可不可信」——0.0058 很小,代表換一份資料表現也差不多。
補充:因為 ROC-AUC 需要連續的機率分數才能排序,sklearn 在 scoring="roc_auc" 時會自動去呼叫 predict_proba,而不是 predict,不需要你手動處理。
這份資料集的一個注意點
0 = 惡性、1 = 良性,而 roc_auc 預設把 1 當作正類。因此這段程式實際上是在評估:模型能否把良性樣本的分數排在惡性樣本之前。不過核心仍然是在衡量「能不能有效區分良性和惡性」,數值不受影響。
—回到題目:現在再作答一次
整段程式已經一行一行拆完了。先不要往下捲,回頭把同一題再做一次——這次應該不只是選對,而是說得出每個選項為什麼對、為什麼錯。
使用 scikit-learn 的 Breast Cancer 資料集評估 StandardScaler、PCA 與 LogisticRegression 的組合。下列寫法將前處理放入 Pipeline,再交由交叉驗證執行:相較於先在完整 X 上執行 scaler.fit_transform(X) 與 pca.fit_transform(X),上述 Pipeline 在交叉驗證中最重要的優點為何?
 1  from sklearn.datasets import load_breast_cancer                       # 從 sklearn 的 datasets 模組,把「載入乳癌資料集」的函式拿到手上
 2  from sklearn.decomposition import PCA                                 # 拿 PCA(主成分分析),之後用來降維
 3  from sklearn.linear_model import LogisticRegression                   # 拿邏輯迴歸——名字是迴歸,工作是分類
 4  from sklearn.model_selection import StratifiedKFold, cross_val_score  # 一次拿兩樣:分層切折的規則+跑交叉驗證的執行者
 5  from sklearn.pipeline import Pipeline                                 # 拿 Pipeline——把多個步驟串成一條生產線
 6  from sklearn.preprocessing import StandardScaler                      # 拿標準化工具——把每欄變成平均 0、標準差 1
 7
 8  X, y = load_breast_cancer(return_X_y=True)                            # 真正載入資料:特徵表裝進 X、答案裝進 y
 9
10  pipe = Pipeline([                                                     # 開始組生產線,存進 pipe(( 是呼叫、[ 是開清單)
11      ("scale", StandardScaler()),                                      # 第 1 站:標準化("scale" 是自己取的名字)
12      ("pca", PCA(n_components=10)),                                    # 第 2 站:降到 10 維
13      ("clf", LogisticRegression(max_iter=2000))                        # 第 3 站:分類模型(行尾沒有逗號)
14  ])                                                                    # ] 關清單、) 關呼叫,生產線組完
15
16  cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)       # 切 5 折、切前先洗牌、亂數固定成 42
17  scores = cross_val_score(pipe, X, y, cv=cv, scoring="roc_auc")        # 跑 5 輪交叉驗證,得到 5 個 ROC-AUC 分數
07自我檢測
七題,答錯會直接告訴你錯在哪。
08重點整理
from A import B=去 A 這個模組,把 B 拿到手上,不執行任何運算。- 有括號才會動:
PCA是設計圖,PCA()是做出來的機器。 - 括號外的
=是「存進箱子」,括號內的=是「指定參數」,所以cv=cv不是廢話。 - sklearn 只有三個動詞:fit(學並記住)、transform(套用已學的)、predict(預測)。
- StandardScaler 把每欄變成平均 0、標準差 1,讓 PCA 和 LogisticRegression 不被單位騙。決策樹家族不需要。
- PCA 不是挑欄位,是重新加權混合造新欄位;它是非監督的,完全不看
y,所以不保證提高準確率。 - LogisticRegression 名字是迴歸、工作是分類;
max_iter是上限不是固定次數,收斂了會提早停。 - StratifiedKFold 確保每折的類別比例跟整體一樣;
shuffle=True要搭配random_state才能重現。 - Pipeline 最大的價值不是少寫幾行,是不會把
fit用錯地方。 - 本題答案 A:每一折的前處理只從該折的訓練資料學參數,驗證折全程只被
transform,避免資料洩漏,交叉驗證分數才可信。
SelectKBest)、目標編碼、過採樣(SMOTE)、用整體平均補缺失值、標準化與降維。只要它會從資料學到東西,就一定要放進 Pipeline。像「把公斤換成公克」這種固定規則的轉換就沒有洩漏問題。—考點提醒與常見問題
這一題橫跨中級科目二「大數據處理與分析」與科目三「機器學習」。歷屆最常見三種問法:①給你一段有 fit_transform(X) 在交叉驗證之前的程式,問「此寫法有何問題」——答案永遠是資料洩漏;②問「將前處理納入 Pipeline 的主要好處」——答案是每折獨立擬合前處理參數;③問 PCA 是否使用標籤、是否保證提升準確率——答案都是否。另外 StratifiedKFold vs KFold、random_state 的作用、ROC-AUC 為何優於 Accuracy 也都是高頻考點。程式題只要抓住「fit 只給訓練資料」這一條,幾乎都能秒殺。
Pipeline 只是少寫幾行嗎?不用它會怎樣?
不只是省事。手寫時最容易犯的錯就是「先對完整資料 fit_transform,再切折」,這會讓驗證折的資訊洩漏進前處理參數,交叉驗證分數偏樂觀。Pipeline 會在每一折自動只用訓練折 fit、只對驗證折 transform,把這個錯誤從根本上排除。此外它也讓超參數搜尋(GridSearchCV)可以一次調整前處理與模型的參數,寫成 pca__n_components(兩個底線)。
用「老師訂及格線」來想,這樣理解對嗎?
方向對了,但有一個地方要修正。假設全班 569 人,老師想用常模計分(把分數換算成「你比平均高幾個標準差」)。錯誤版是:收齊全部 569 份算出平均,訂好換算標準,然後才說「這 114 份當期末考」——那 114 人自己拉動了平均,等於在替自己訂標準。Pipeline 版是:先把那 114 份封起來,只用剩下 455 份算平均、訂標準,最後才拆封換算——那 114 人對標準零影響。
要修正的是:正確做法不是「完全不看資料就訂一個 60 分」,因為標準化本來就要從資料算平均值與標準差,不看資料就沒東西可算。正確做法是只看訓練折、不看驗證折。而且要注意五折各自算一次——每折的訓練資料不同,算出來的平均值與主成分方向也都不同,這才是「每一折的前處理只從該折的訓練資料學習」的完整意思。
至於「公斤換公克」這種乘 1000 的固定規則轉換,因為完全不需要看資料,放在 Pipeline 外面也不會洩漏。判斷準則只有一句:只要那個步驟會從資料學到東西並記下來,就必須放進 Pipeline。
PCA 會用到標籤 y 嗎?降維後準確率一定會提高嗎?
都不會。PCA 是非監督式降維,只看 X 的變異與相關結構,fit 的 y 參數被忽略。它挑的是「變異最大」的方向,不是「最會分類」的方向,所以可能丟掉對分類有用但變異小的資訊。本站實跑:30 維 AUC 0.9953、10 維 0.9949、1 維 0.9709——降維換到的是速度與簡潔,不是準確率。想要「會分類」的降維可以改用 LDA(線性判別分析),那才是監督式的。
為什麼一定要 shuffle=True 和 random_state?
shuffle=True 是因為原始資料可能有排序(依收案時間、依類別排),不洗牌就直接切會讓某些折特別偏頗。而一旦洗牌就引入隨機性,random_state=42 固定亂數種子後,每次執行的切分方式都完全一樣,才能重現實驗、公平比較不同模型、以及除錯。數字 42 沒有統計意義,換成任何整數都可以,重點是固定住。
資料洩漏在乳癌資料上影響不大,那是不是可以不管?
不行。這份資料影響小是因為樣本夠多(569 筆)而且 StandardScaler 與 PCA 都是非監督的。一旦換成小樣本、或前處理用到標籤(特徵選擇、目標編碼、SMOTE),差距會非常誇張。本站實測:對一份完全隨機的亂數資料(真實 AUC 應為 0.5),先用全部資料做特徵選擇再交叉驗證,報出來的 AUC 高達 0.929——完全是假的。所以正確的做法是養成永遠用 Pipeline 的習慣,而不是每次評估「這次要不要緊」。
max_iter=2000 是一定會跑 2000 次嗎?為什麼會出現 ConvergenceWarning?
不是,它是上限。模型收斂了就會提早停止。ConvergenceWarning 代表跑到上限還沒收斂,此時模型會用「目前為止最好的權重」交差,結果可能不是最佳解。要解決通常有兩條路:把 max_iter 調大(治標),或先把資料標準化(治本)。本站實測,這份資料不標準化時即使給到 2000 次仍不收斂,加上 StandardScaler 後預設的 100 次就夠了。
ROC-AUC 為什麼要用機率而不是 0/1 的預測結果?
因為 ROC 曲線是「把判定門檻從 1 一路掃到 0,記錄每個門檻下的真陽性率與偽陽性率」畫出來的,需要連續的分數才能排序。如果只有 0/1 硬答案就只剩一個點,畫不出曲線。cross_val_score 在 scoring="roc_auc" 時會自動去呼叫 predict_proba(或 decision_function)。順帶一提,本資料集標籤 1 是良性,sklearn 預設把 1 當正類,因此 AUC 衡量的是把良性排在惡性前面的能力,本質上仍是兩類區分能力。