🗺️ AI 學習與考證地圖

極度不平衡資料集 (3% 正樣本)

100 個病人中只有 3 個確診。我們該如何教導 AI?

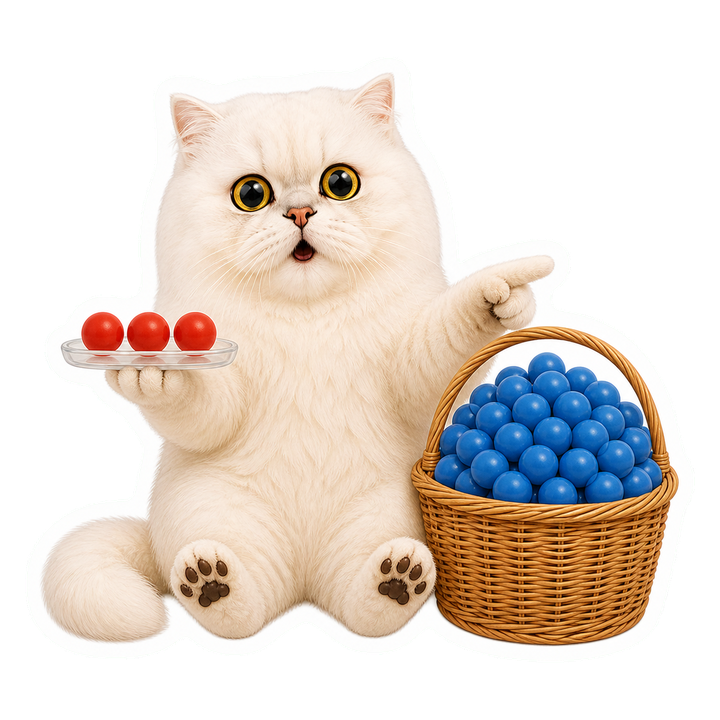
驚訝圓眼的 Mochi 貓老師比較一小撮紅色少數樣本與一大籃藍色多數樣本
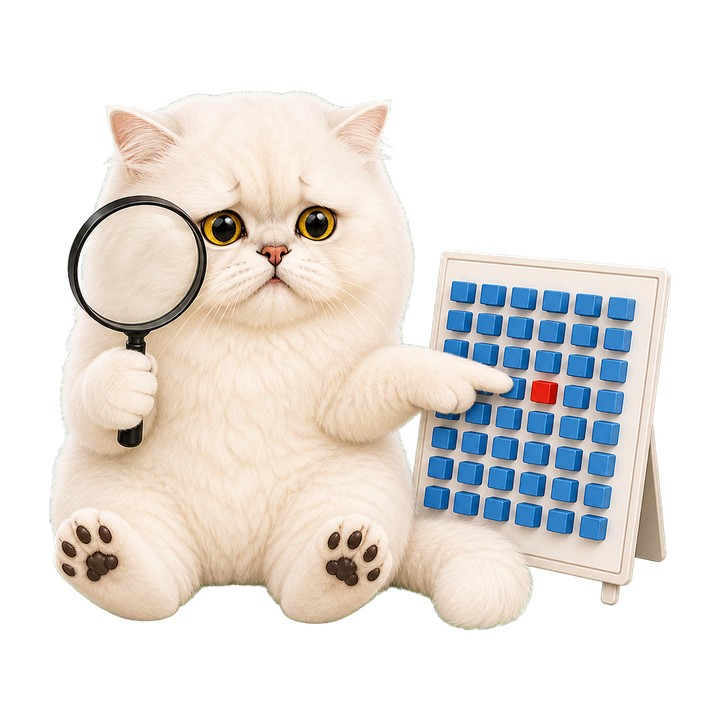
溫柔擔心的 Mochi 貓老師用放大鏡尋找大量藍色方塊中的稀少紅色方塊
01 · 一眼看懂 97:3

高準確率,不一定是好模型

當少數類只占 3%,模型只要把所有人都猜成健康,就能拿到 97% 準確率;但真正需要被找到的 3 位病患全部漏掉。類別不平衡的核心,不只是數量差很多,而是錯過少數類的代價通常更高

準確率 97%!

但是... 3 個病患全漏抓了💀

戴端正圓眼鏡的 Mochi 貓老師專注操作類別不平衡四策略控制台
📊 類別不平衡處理
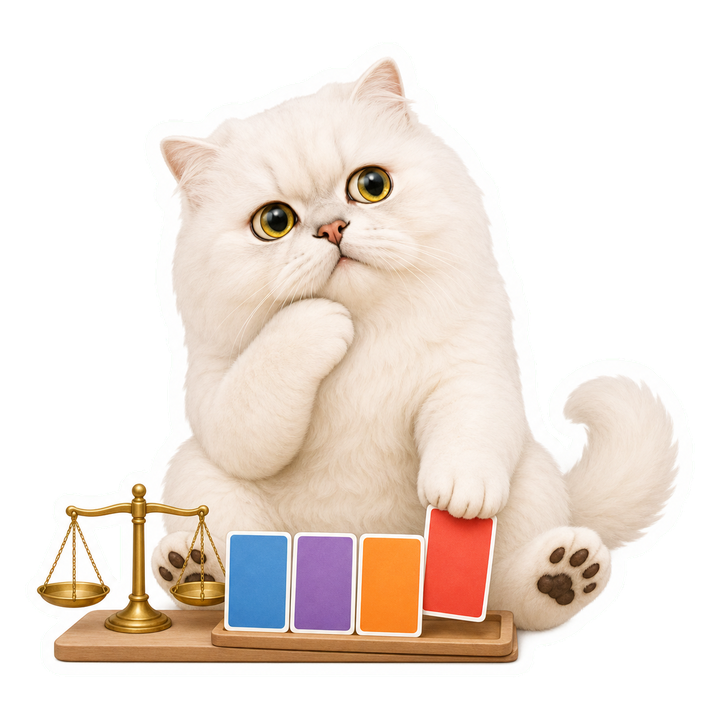
思考側看的 Mochi 貓老師整理資料、權重、指標與門檻四種策略卡
層面方法注意
資料層過取樣(SMOTE)、欠取樣只在訓練集做,避免洩漏
演算法層類別權重、cost-sensitive不動資料、調懲罰
評估層用 F1、AUC、PR-AUC別只看準確率
門檻層調整分類門檻依成本移動決策點
✅ 自我檢測
安心閉眼微笑的 Mochi 貓老師揮手並展示類別不平衡考點檢核板
為什麼不能只看準確率?
99:1 時全猜多數類也有 99% 準確率卻抓不到少數類;要用 F1、AUC 或看混淆矩陣。
重取樣要在哪個階段做?
只在「訓練折」內做並放進 pipeline;對整個資料集先重取樣會資料洩漏、評估灌水。
有哪些處理方法?
資料層(過/欠取樣、SMOTE)、演算法層(類別權重)、評估層(F1/AUC)、門檻調整,常組合使用。
🎯 重點整理
  1. 不平衡別只看準確率,改看 F1/AUC。
  2. 資料層:SMOTE 過取樣或欠取樣。
  3. 演算法層:調類別權重。
  4. 重取樣只在訓練折做,避免洩漏。
  5. 可調分類門檻配合成本。
03 · 典型應用場景

少數類雖少,往往才是最不能漏掉的訊號

溫柔自信的 Mochi 貓老師介紹詐欺、疾病、瑕疵與入侵四種典型應用

判斷是否需要處理不平衡資料時,不只看比例,也要問:少數事件漏掉一次,會造成多大的醫療、金錢、安全或品質成本?
可愛懷疑側眼的 Mochi 貓老師檢查出現警示燈的信用卡交易
信用卡詐欺偵測
絕大多數交易正常,真正的詐欺極少;漏抓可能造成直接損失。
關切柔和眼神的 Mochi 貓老師用聽診器與放大鏡進行罕見疾病篩檢
罕見疾病篩檢
確診病例少,但漏掉病患的代價高,通常特別重視召回率。
可愛專注的 Mochi 貓老師用放大鏡檢查產線上少見的紅色瑕疵零件
製造瑕疵檢測
正常品很多、瑕疵品很少;模型仍要抓到少見的品質異常。
警覺圓眼但不兇的 Mochi 貓老師用盾牌攔住少見的網路入侵警報
網路入侵偵測
正常流量占大多數,攻擊事件稀少;少數警報卻可能最關鍵。

📝 iPAS 考點提醒

類別不平衡是 iPAS 高頻考點(初級科目一、中級科目三),如詐欺 1% 對正常 99%。重點:此時準確率嚴重誤導(全猜多數類也有高分),要看召回率、F1、PR-AUC。易混點:重取樣(SMOTE 過取樣、欠取樣)只能在交叉驗證的訓練折內做,否則資料洩漏、高估表現;也可調類別權重或分類門檻。情境題常給你不平衡資料、問該用什麼指標或處理法。

想練情境題與詳解 → AI 學習與考證地圖

❓ 常見問題

什麼是類別不平衡?

各類樣本數差距懸殊(如詐欺 1% 對正常 99%);模型容易偏向多數類、忽略少數類。

為什麼不能只看準確率?

全猜多數類就有高準確率卻沒用;應看精確率、召回率、F1、PR-AUC,並看混淆矩陣。

有哪些處理方法?

重取樣(SMOTE 過取樣、欠取樣)、調類別權重、調門檻、選對指標、用集成或異常偵測法。

重取樣要在哪個階段做?

只在訓練資料、且在交叉驗證的每個 fold 內做;若先對全資料重取樣會造成資料洩漏、高估表現。

怎麼選評估指標?

在意少數類抓得到看召回率;在意警報品質看精確率;要平衡看 F1;整體排序能力看 PR-AUC(不平衡時比 ROC-AUC 更敏感)。

🧭 相關主題

← 返回 AI 學習與考證地圖