🗺️ AI 學習與考證地圖

為何其他三種方法會導致模型評估災難?

眼神明亮好奇的 Mochi 貓老師觀察三種危險的交叉驗證切分路線
溫柔擔心的 Mochi 貓老師用放大鏡尋找大量藍點中的少數紅點
01 · 先看切分是否像真實世界

交叉驗證不是切得越多越好,而是每一折都要能回答真正的預測問題

資料很少、陽性稀有、同一個人有多筆紀錄,或資料具有時間順序時,普通隨機切分可能讓驗證集失真。先用互動圖觀察三種陷阱,再把情境對應到正確切分法。

戴端正圓眼鏡的 Mochi 貓老師專注操作訓練集與驗證集切分控制台
陰性個案 (138筆)
陽性個案 (12筆)
訓練集 (Training Set) 驗證集 (Validation Set) 無法計算指標!

請選擇上方按鈕

觀察各種方法在面對 12 筆陽性、138 筆陰性資料時,會把驗證集切成什麼可怕的模樣。

📊 交叉驗證常見錯誤
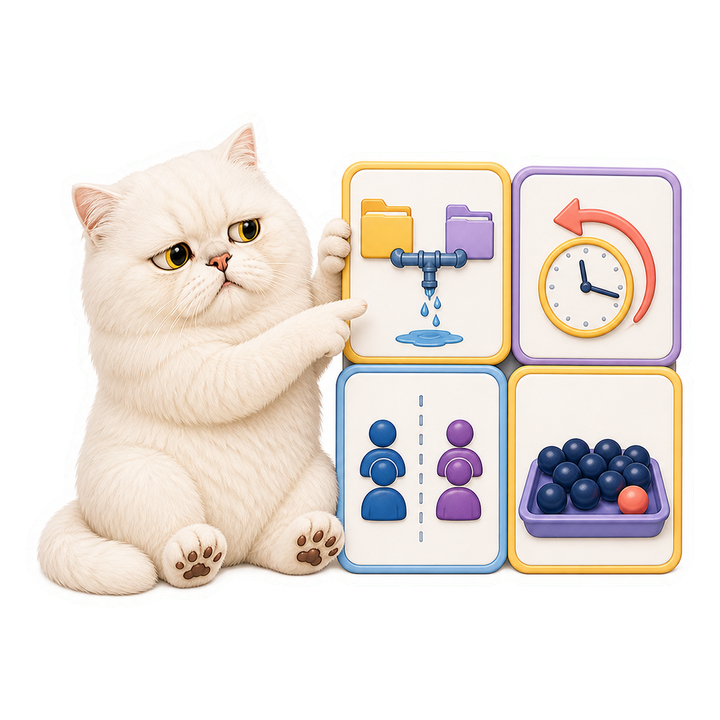
溫和側眼思考的 Mochi 貓老師檢查資料洩漏、時間穿越、群組與不平衡陷阱卡
錯誤為什麼錯正解
前處理用全資料縮放/填補看到測試資訊→洩漏放 pipeline、對每折 fit
時間序列用一般 K 折用未來預測過去、時間穿越用時序切分(只用過去)
有群組卻隨機切同一人跨訓練測試→高估Group K-Fold
不平衡沒分層某折可能沒有少數類Stratified K-Fold
✅ 自我檢測
安心閉眼微笑的 Mochi 貓老師揮手並展示安全交叉驗證檢核板
交叉驗證最常見的錯誤是什麼?
前處理(縮放/填補/選特徵)用到整個資料集,讓驗證折看到訓練外資訊,造成洩漏、分數虛高。
時間序列用一般 K 折錯在哪?
隨機折會用「未來」資料訓練去預測「過去」,發生時間穿越;要用只用過去的時序切分。
有分組資料時的陷阱?
同一使用者/病人的多筆若被切到不同折,模型「見過」該對象、評估被高估;要用 Group K-Fold。
🎯 重點整理
  1. 前處理放 pipeline,避免跨折洩漏。
  2. 時間序列用時序切分,別隨機折。
  3. 有群組用 Group K-Fold。
  4. 不平衡用 Stratified K-Fold。
  5. CV 要模擬真實預測情境。
03 · 典型應用場景

先辨認資料的關聯,再決定每一折怎麼切

溫柔自信的 Mochi 貓老師介紹群組、分層、時序與管線切分工具

最安全的交叉驗證會模擬模型上線後真正遇到的資料:同一對象不能偷跑到兩邊、少數類不能消失、未來不能倒流,而且前處理只能從當折的訓練資料學習。

沉思側看的 Mochi 貓老師把同一病患的多筆紀錄整理在同一群組
醫療與同一病患紀錄
同一病患的多次檢查要留在同一折,用 Group K-Fold 避免模型先看過這位病患。
驚訝圓眼但不兇的 Mochi 貓老師發現大量一般交易中的少數詐欺警示
詐欺與稀有事件偵測
少數類很稀有時用 Stratified K-Fold,讓每一折都保留接近整體的陽性比例。
可愛謹慎的 Mochi 貓老師沿時間箭頭只用過去資料預測未來
需求與時間序列預測
銷量、流量或感測器資料只能用過去預測未來,採前向或滾動驗證,不能隨機打散。
明亮自信的 Mochi 貓老師用盾牌保護每一折內的前處理管線
前處理與特徵工程管線
縮放、填補、選特徵與重取樣都放進 Pipeline,只能在每折的訓練部分 fit。

📝 iPAS 考點提醒

交叉驗證若做錯會讓評估虛高,是 iPAS 高頻陷阱題(中級科目二與三)。重點:最常見的錯是資料洩漏——在切分前就對全資料做標準化、特徵選擇或重取樣,測試資訊提前外洩。易混點:前處理要放進管線、在每折內只用訓練部分擬合;時間序列不能隨機切(要前向驗證)、分組資料要 GroupKFold。情境:辨識題目中哪個 CV 做法不當。

想練情境題與詳解 → AI 學習與考證地圖

❓ 常見問題

交叉驗證最常見的錯誤是什麼?

資料洩漏——在切分前就對全資料做前處理(標準化、特徵選擇、重取樣),測試折的資訊提早洩漏給模型,造成評估過度樂觀。

前處理為什麼要放進管線(pipeline)?

要在每一折只用訓練部分擬合前處理參數、再套用到驗證部分;用 Pipeline 自動確保不洩漏,手動很容易出錯。

時間序列用一般 K 折錯在哪?

隨機切會用未來資料預測過去、洩漏未來資訊使評估虛高;應改用時間順序的前向(滾動)驗證。

有分組資料時的陷阱?

同一受試者或使用者的樣本散落在訓練與驗證兩邊會洩漏;應用 GroupKFold 讓同組只落在同一邊。

還有哪些常見錯誤?

用測試集調參、不平衡資料未分層、只跑一次就下結論、在交叉驗證外才做重取樣;這些都會高估真實表現。

🧭 相關主題

← 返回 AI 學習與考證地圖