UMAP:先連出一張鄰居網,再把整張網攤平
UMAP 假設你的資料其實躺在一張捲起來的低維曲面(流形)上。它先幫每個點連出鄰居、織成一張網,再想辦法把這張網攤平到 2D 而不撕破鄰居關係。比 t-SNE 快、通常較能保留全局結構,而且可以套用到新資料。
非線性降維流形學習n_neighborsmin_dist可 transform 新資料比 t-SNE 快
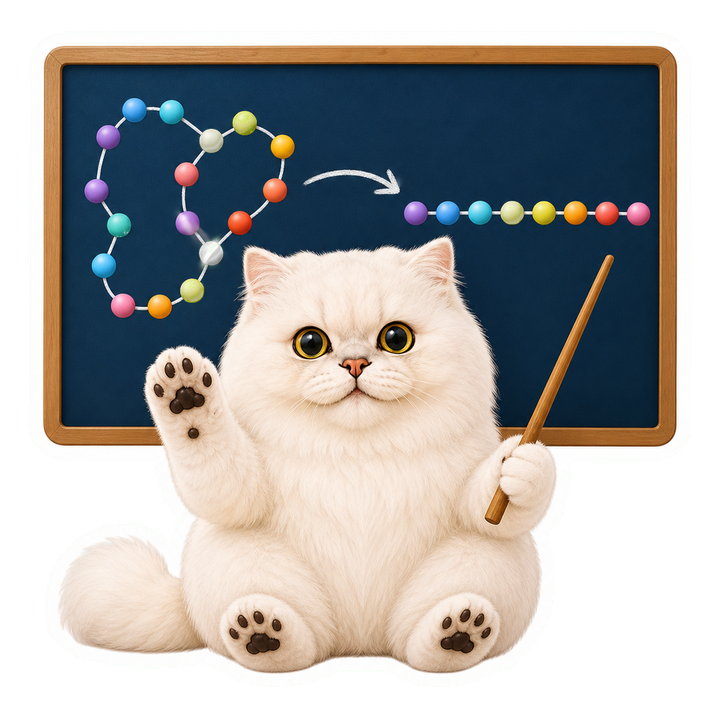
UMAP 假設你的資料其實躺在一張捲起來的低維曲面(流形)上。它先幫每個點連出鄰居、織成一張網,再想辦法把這張網攤平到 2D 而不撕破鄰居關係。比 t-SNE 快、通常較能保留全局結構,而且可以套用到新資料。
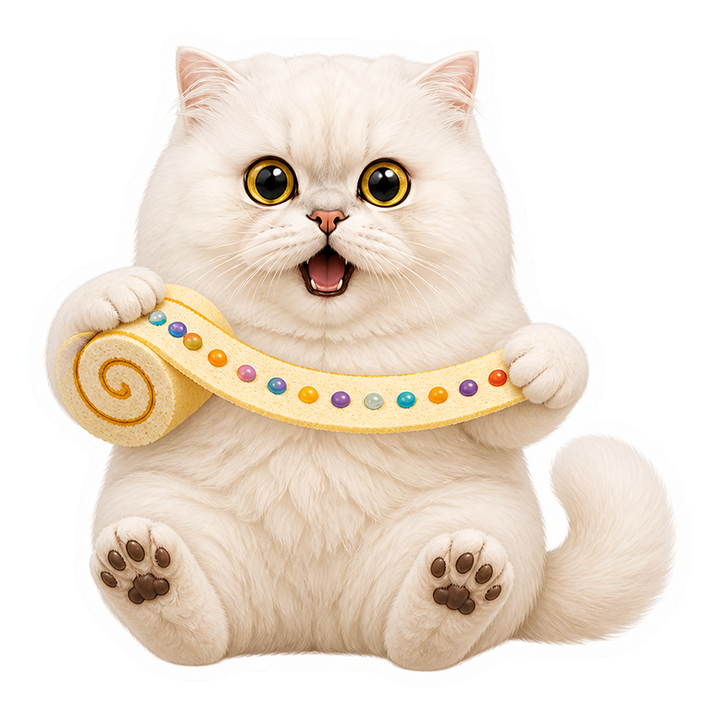
UMAP 全名 Uniform Manifold Approximation and Projection(均勻流形近似與投影),2018 年由 McInnes 等人提出。
所謂「流形(manifold)」講的就是這件事:資料的維度很高,但真正的自由度很低。一萬張手寫數字圖片是 784 維,可是決定一個「7」長什麼樣的其實只有筆畫粗細、傾斜角、彎曲度等寥寥幾個因素——那幾個因素張出來的低維曲面,就是流形。UMAP 的工作,就是把這張曲面找出來、攤平給你看。
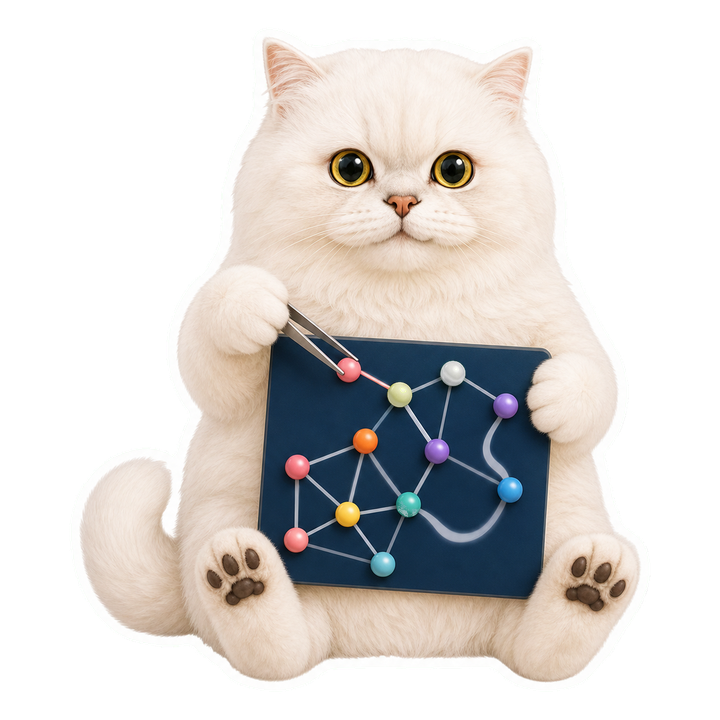
對每個點 $i$,先量到最近鄰的距離 $\rho_i$,再找一個尺度 $\sigma_i$,把距離換成 0~1 的相似度:
$w_{i \to j}=\exp\!\left(-\dfrac{\max(0,\; d(i,j)-\rho_i)}{\sigma_i}\right)$
UMAP 最小化高維網與低維網之間的交叉熵(cross-entropy),用 SGD + 負採樣來跑:每一步只挑一條邊做吸引、再隨機抓幾個點做排斥(預設 negative_sample_rate=5),不必像 t-SNE 那樣每步計算所有點對。這就是它快的主因。
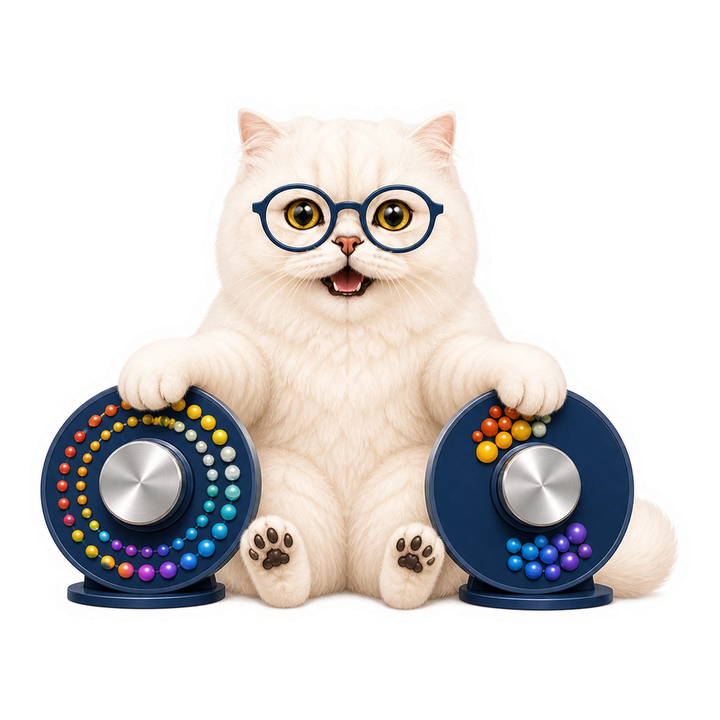
UMAP 只有兩個參數你非調不可,而且考試最愛考它們的分工。
| 參數 | 預設 | 管什麼 | 調小 ↓ | 調大 ↑ |
|---|---|---|---|---|
| n_neighbors | 15 | 看多大範圍的鄰居 (局部 ↔ 全局) | 只看眼前幾個點 → 細節多、群容易碎成小塊 | 看到整體骨架 → 全局結構好、細節被抹平 |
| min_dist | 0.1 | 低維裡兩點最近可以擠多近 (只影響「畫得多擠」) | 群更緊實、輪廓分明,適合看群集/接後續分群 | 點分散得均勻,適合看整體拓撲與連續變化 |
彩虹色代表點在原始蛋糕皮上的位置:顏色接近=原本就是鄰居。攤平成功的話,顏色會依序排成一條不打結的帶子(紫→藍→綠→黃→紅);失敗的話,顏色會捲成漩渦——內圈和外圈明明隔了一整圈,圖上卻緊貼在一起。
| 比較 | PCA | t-SNE | UMAP |
|---|---|---|---|
| 類型 | 線性 | 非線性 | 非線性(流形學習) |
| 著重 | 全局變異 | 局部鄰近 | 局部為主,兼顧部分全局 |
| 速度 | 最快 | 慢 | 快(負採樣,可上百萬筆) |
| 套用新資料 | 可以(transform) | 不行,要整批重算 | 可以(fit 後 transform) |
| 能當下游特徵 | 可以 | 不建議 | 可以 |
| 主要參數 | n_components | perplexity(5~50) | n_neighbors(15)、min_dist(0.1) |
| 損失函數 | 重建誤差/最大變異 | KL 散度 | 交叉熵 |
| 典型用途 | 壓縮、去共線性、前處理 | 純視覺化看群聚 | 視覺化+前處理,常接 HDBSCAN |
fit() 之後可以 transform() 新的點,能塞進 pipeline 當下游特徵;t-SNE 只能整批重算。fit(X, y))做監督/半監督降維,讓同類別靠得更近。
UMAP 比 t-SNE 好,但沒有好到可以照字面讀。這幾條是考題與論文都會踩的地方。
先想再點開。
① 在高維建帶權重的模糊鄰居圖(每點連 n_neighbors 個鄰居);② 在低維用 SGD+負採樣讓有邊的互相吸引、非鄰居互相排斥,最小化交叉熵把網攤平。
n_neighbors(預設 15):看多大範圍的鄰居,決定局部 ↔ 全局的平衡,會改變拓撲。min_dist(預設 0.1):低維裡點最近能擠多近,只影響畫面鬆緊,不改變誰連誰。
UMAP 快、而且能 transform 新資料(可放進 pipeline 當下游特徵、可做監督式降維),t-SNE 不可逆、每次都要整批重算,只適合當視覺化。
t-SNE 最小化 KL 散度,主要罰「該近的變遠」;UMAP 最小化交叉熵,兩邊都罰,加上譜嵌入初始化,所以全局骨架保留得比較好。
因為降維過程是局部優先的近似,群間距離只是「相對比 t-SNE 有意義一點」,仍會被扭曲;而且結果隨參數與隨機種子變動,UMAP 甚至會把純雜訊畫成漂亮團塊。
UMAP 是較新的非線性降維/流形學習方法,iPAS 中級科目三考點。重點:先用 n_neighbors 建模糊鄰居圖、再以 SGD 加負採樣最小化交叉熵把圖攤平;比 t-SNE 快、較能保留全局結構,且 fit 之後可以 transform 新資料、能當下游特徵、支援監督式降維。易混點:n_neighbors 控制局部與全局的平衡(會改變結構)、min_dist 只控制低維點的鬆緊(不改變拓撲);群間距離仍不可完全照字面解讀。情境:大規模高維資料視覺化(如單細胞 RNA、embedding 檢視),或先降維再接 HDBSCAN 分群。
想練情境題與詳解 → AI 學習與考證地圖
一種較新的非線性降維法,基於流形學習與拓撲。它假設資料躺在一個捲起來的低維曲面上,先建立鄰居圖再把圖攤平到 2D 或 3D,常用於高維資料視覺化。
UMAP 速度快很多、通常較能保留全局結構,而且 fit 之後可以 transform 新資料、能當下游特徵、支援監督式降維;t-SNE 較慢、不可逆,只適合當視覺化工具。
n_neighbors(預設 15)控制看多大範圍的鄰居,是局部與全局的平衡,會改變結構;min_dist(預設 0.1)只控制低維空間中點最近能擠多近,影響畫面鬆緊、不改變誰跟誰相連。
可以,常見做法是 UMAP 降到低維後接 HDBSCAN,此時 min_dist 常設為 0 讓群更緊實;但分群結論最好回到原始空間再驗證一次。
群間距離只是比 t-SNE 有意義一些,仍不可照字面解讀;結果對 n_neighbors 與隨機種子敏感,而且就算餵入純雜訊也可能被畫成漂亮團塊。