🌲 非監督式分群 · iPAS 常考
階層式分群:把資料合併成一棵「家族樹」
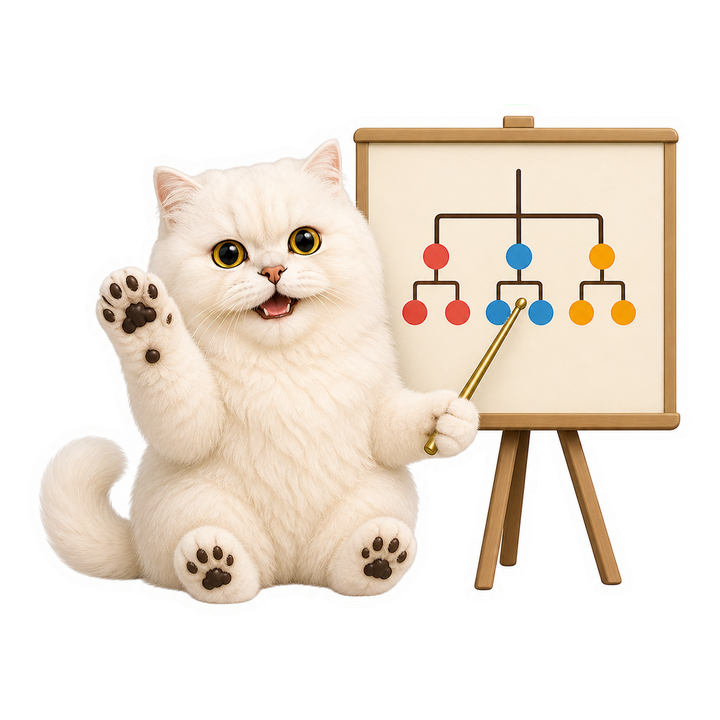
和 K-Means 不同,階層式分群不必先決定要分幾群。它由下而上,把最相近的兩群一層層合併,畫成一棵「樹狀圖」;你只要在樹上橫切一刀,就決定分成幾群。下面拉拉切割線就懂了。
由下而上合併樹狀圖 Dendrogram不需先定 K切割線連結方式 Linkagevs K-Means
🤔 一、階層式分群在做什麼?
一句話:把最像的先湊在一起,一層一層合併成一棵樹。
💡 白話定義(凝聚式 Agglomerative,由下而上)
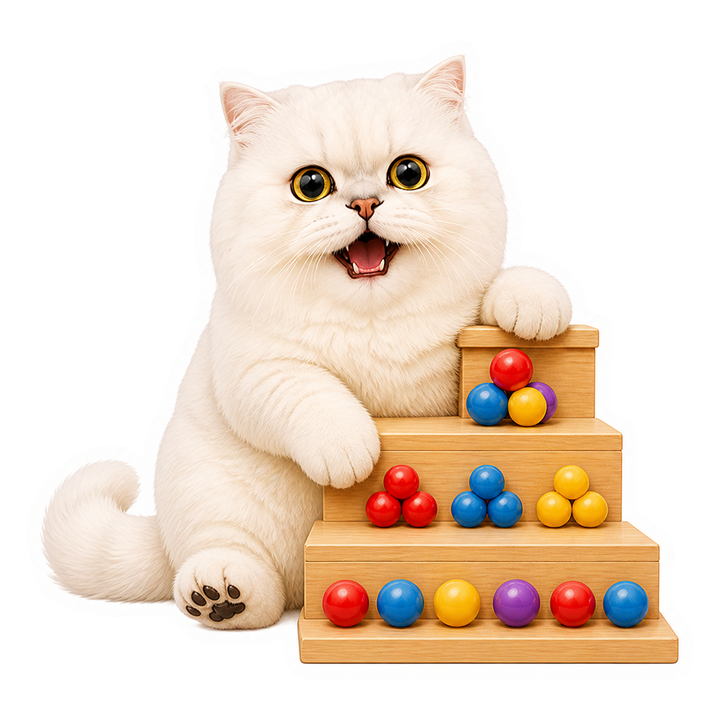
想像很多小部落:① 一開始每個資料點都是一個獨立部落;②找出距離最近的兩個部落,把它們合併成一個大部落;③一直重複,直到全部合併成一個大帝國為止。
這整個合併的歷史,就畫成右邊那棵樹狀圖(Dendrogram)。
⭐ 最大優點:不用先決定 K
K-Means 必須先說「我要分 3 群」;階層式分群先把整棵樹建好,最後才用一條「切割線」決定要切成幾群。線拉高→群少;線拉低→群多。還能直接從樹看出資料的巢狀結構。⚙️ 二、運作步驟
1
每點一群
把 N 個資料點當成 N 個獨立的群。
把 N 個資料點當成 N 個獨立的群。
2
合併最近的兩群
找出目前距離最近的兩群,合併成一群,並記下「合併時的距離」。
找出目前距離最近的兩群,合併成一群,並記下「合併時的距離」。
3
重複到剩一群
不斷重複,直到全部合成一棵樹。合併距離越大,代表越晚(越不像)才併在一起。
不斷重複,直到全部合成一棵樹。合併距離越大,代表越晚(越不像)才併在一起。
🎮 三、動手玩:拉切割線,決定分幾群
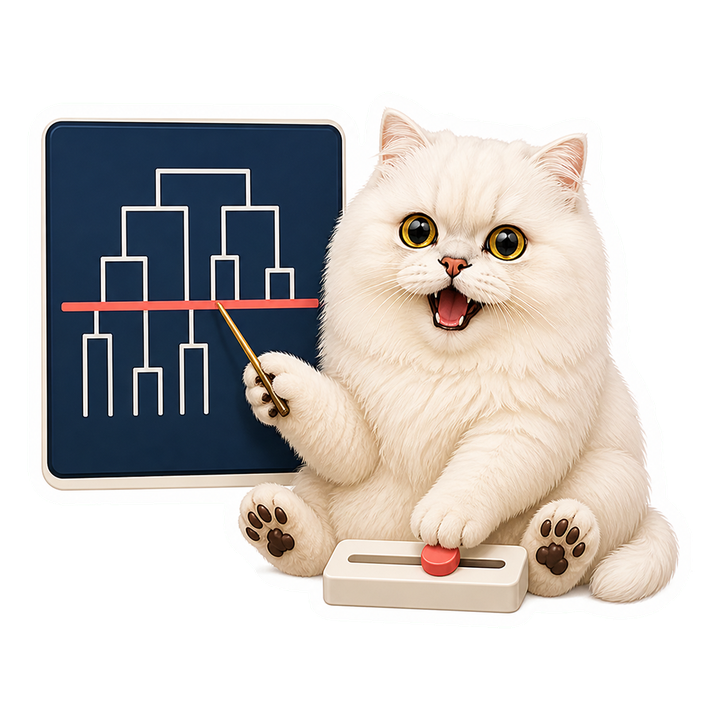
拖「切割閾值」滑桿,看右邊樹上的紅色切割線怎麼移動、左邊的點怎麼跟著重新分群。
🗺️ 怎麼看這兩張圖
左圖(原始資料):每個點依「目前分到哪群」上色。右圖(樹狀圖):底部每個分叉=一個原始點;連起來的高度=合併時的距離(低處就連=原本很近;高處才連=兩群差很大)。紅色虛線=切割線,線穿過幾條樹枝,就分成幾群。拉高→群變少、拉低→群變多。
目前分群數量:1
1. 原始數據分佈 (2D)
2. 樹狀圖 (Dendrogram)
📖 四、樹狀圖(Dendrogram)怎麼讀?
X 軸(底部)每一個原始資料點。
Y 軸(高度)=合併時的距離。越高才連=兩群越不像。
怎麼切幾群在「高度跳很大」的空檔橫切一刀——那裡上下差距大,切下去最自然。
🔗 五、連結方式(Linkage):兩群的「距離」怎麼算?
合併時要比較「群與群的距離」,但群裡有很多點,到底用哪兩點來算?這就是 linkage,不同選擇會分出不同形狀的群(常考)。
| 連結方式 | 群間距離怎麼定 | 特性 |
|---|---|---|
| 單一連結 Single | 兩群最近的兩點 | 易形成鏈狀、能抓不規則形狀,但對雜訊敏感 |
| 完全連結 Complete | 兩群最遠的兩點 | 群較緊湊球狀,但對離群值敏感 |
| 平均連結 Average | 所有點對距離的平均 | 介於單一與完全之間的折衷 |
| Ward | 合併後群內變異增加最小 | 最常用,傾向大小相近、緊湊的球狀群 |
🆚 六、階層式 vs K-Means
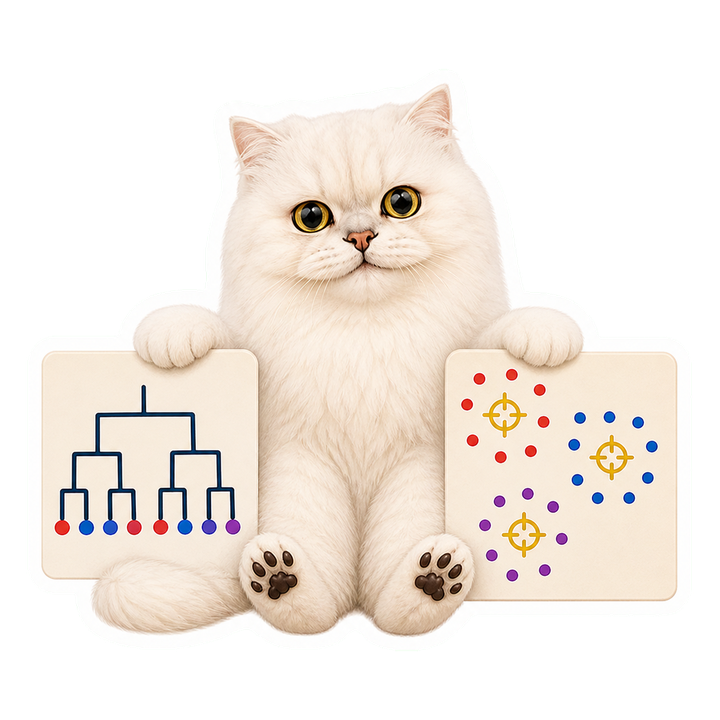
| 比較 | 階層式分群 | K-Means |
|---|---|---|
| 要先定 K? | 不用(先建樹再切) | 要(事先指定群數) |
| 輸出 | 樹狀圖(看得到階層結構) | K 個群 |
| 速度/規模 | O(n²) 以上,不適合超大資料 | 快,可處理大資料 |
| 群形狀 | 看 linkage(可較有彈性) | 偏球狀、大小相近 |
⚠️ 它的限制
計算與記憶體成本高(約 O(n²) 以上)→ 不適合超大資料;對雜訊與離群值也較敏感(單一/完全連結尤其)。資料量很大時,改用 K-Means 或 DBSCAN。🧪 七、觀念自我檢測
先想再點開。
Q1. 階層式分群和 K-Means 最大的差別?
階層式不必先指定 K(先建整棵樹、再用切割線決定群數),還能看到階層結構;K-Means 必須先定 K。
Q2. 凝聚式(agglomerative)怎麼運作?
由下而上:每點一群 → 反覆合併最近的兩群 → 直到合成一群,過程畫成樹狀圖。
Q3. 樹狀圖的高度(Y 軸)代表什麼?
合併時的距離。越高才連=兩群越不像。在「高度跳很大」的地方橫切,決定群數。
Q4. Linkage(連結方式)有哪些?
單一(最近點、易鏈狀)、完全(最遠點、緊湊)、平均、Ward(最小組內變異、最常用)。不同 linkage 分出不同形狀的群。
✅ 八、30 秒重點整理
由下而上合併每點一群 → 合併最近兩群 → 直到一群。
輸出樹狀圖高度=合併距離;在跳很大的地方橫切。
不需先定 K先建樹、再用切割線決定群數(最大優點)。
Linkage 很關鍵單一/完全/平均/Ward,影響群的形狀。
限制O(n²) 慢、不適合大資料、對雜訊敏感。
vs K-Means它不用定 K 但慢;K-Means 要定 K 但快。