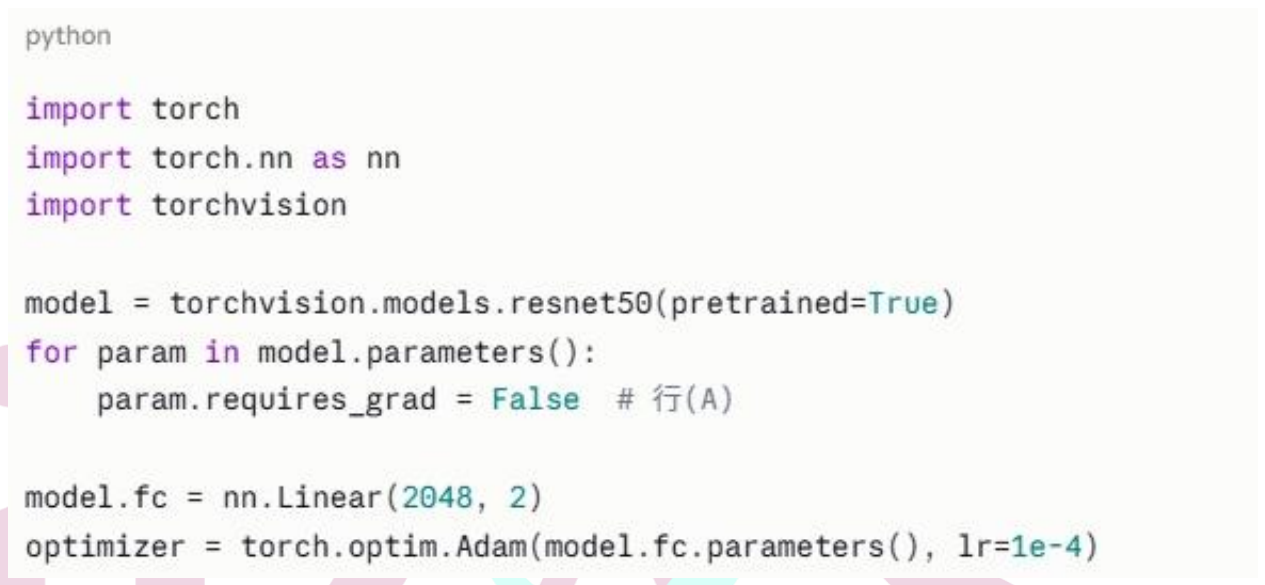
把 PyTorch 整個套件載入記憶體,之後用 torch.xxx 取用裡面的工具。
逐字拆解
import關鍵字 「把後面的模組載入,並在程式裡建立一個同名的名字」。
torch套件 PyTorch 的套件名稱,用 pip install torch 安裝。名字來自它的前身:用 Lua 語言寫的 Torch 框架。
這一行執行時發生什麼事
Python 找到安裝好的 torch,執行它的初始化程式(載入 C++ 運算核心、偵測有沒有 GPU 等),第一次可能要一兩秒。之後 torch 這個名字就指向一個「模組物件」,用點可以拿到裡面的東西。
執行後多了:
torch → 模組物件(PyTorch 本體)
torch.__version__ → '2.6.0'(本頁驗證用的版本)
torch 裡最常用的幾格
寫法 是什麼 做什麼 torch.tensor()、torch.randn()函式 建立張量。§6 用 randn 做假圖片 torch.nn子模組 各種層與損失函數(第 2 行) torch.optim子模組 各種優化器,第 10 行的 Adam 就在這 torch.cuda.is_available()函式 檢查有沒有可用的 NVIDIA GPU torch.no_grad()情境管理器 推論時暫停記錄計算圖,省記憶體(和「凍結」不同,第 7 行會比較) torch.save()、torch.load()函式 存、讀模型權重
這段程式哪裡用到 torch?
只有第 10 行的 torch.optim.Adam。你可能會想:第 2 行 import torch.nn as nn 不是也載入了 torch 嗎?載入了,但沒有建立 torch 這個名字 ——import A.B as C 只會建立 C。所以少了第 1 行,第 10 行就會出現 NameError: name 'torch' is not defined。
新手常踩的坑
寫成 import pytorch:ModuleNotFoundError: No module named 'pytorch'。框架叫 PyTorch,套件名卻是 torch。
寫成 import Torch:Python 的模組名稱分大小寫,同樣 ModuleNotFoundError(Windows 也一樣)。
想用 GPU 卻裝到 CPU 版:pip install torch 不一定是你要的 CUDA 版本,要照 PyTorch 官網的安裝指令選。裝錯時 torch.cuda.is_available() 會是 False。
走進 torch 裡的 nn 子模組(放各種神經網路層的地方),並幫它取一個短綽號 nn。
逐字拆解
torch.nn子模組 「torch 的 nn 區」,專門放神經網路積木。
nn別名 之後程式裡寫 nn 就代表 torch.nn。社群慣例都叫 nn,就像 numpy 叫 np。
nn 這個積木箱裡有什麼
類別 做什麼 和本題的關係 nn.Module所有層、所有模型的共同祖先類別 ResNet、Linear 都繼承它 nn.Parameter「要被訓練的張量」,是 Tensor 的子類別 parameters() 吐出來的就是它nn.Linear全連接層 第 9 行新的 fc nn.Conv2d、nn.BatchNorm2d、nn.ReLU、nn.MaxPool2d、nn.AdaptiveAvgPool2d卷積、批次正規化、激活、池化 ResNet-50 內部全是這些 nn.CrossEntropyLoss多類別分類的損失函數 §6 用到
物件導向重點:繼承讓所有層都有同一組方法
ResNet 和 Linear 長得完全不同,但在原始碼裡都寫成 class ResNet(nn.Module)、class Linear(Module):它們是 nn.Module 的子類別 。子類別會繼承 父類別的方法,所以下面這些方法,對整個模型、對單一一層都能用:
方法 做什麼 本題 .parameters()逐一交出所有參數(產生器) 第 6、10 行 .named_parameters()同上,但連名字一起給,例如 ('fc.weight', …) §6 .children()、.named_children()列出直接的子模組 看結構時 .train()、.eval()切換訓練/評估模式(影響 BatchNorm、Dropout) 第 7 行的進階說明 .requires_grad_(False)一次設定底下所有參數的 requires_grad 第 7 行的等價寫法 .to('cuda')把所有參數搬到 GPU 實務訓練 .state_dict()、.load_state_dict()匯出/載入所有權重 resnet50 內部載入權重就用它 物件(x)呼叫物件本身 = 執行 forward(前向計算) model(x)
執行後多了:
nn → torch.nn 模組物件
(只建立了 nn 這個名字,不會建立 torch)
新手常踩的坑
寫 import torch.nn 卻沒加 as nn,後面又用 nn.Linear:NameError: name 'nn' is not defined。沒取綽號時要寫全名 torch.nn.Linear。
寫成 import torch.nn.Linear:ModuleNotFoundError: No module named 'torch.nn.Linear'。import 後面只能接模組,Linear 是類別,要用 from torch.nn import Linear。
等價寫法 from torch import nn 結果完全一樣,看到別人這樣寫不用緊張。
載入 torchvision,等一下要從它的 models 區拿 ResNet-50。
逐字拆解
torchvision套件 PyTorch 官方的影像套件,要另外安裝(pip install torchvision),版本要和 torch 配對。
torchvision 的分區
子模組 放什麼 出現在 torchvision.models現成模型架構+預訓練權重 本題第 5 行 torchvision.transforms影像前處理、資料增強 第 41 題 torchvision.datasets常用資料集下載器 第 46 題 torchvision.io、ops、utils讀寫圖片影片、偵測用運算、畫圖小工具 —
torchvision.models 裡的其他模型(換模型時要知道的事)
工廠函式 參數量 ImageNet top-1 最後一層的屬性名 resnet18()11,689,512 69.758% fc(輸入 512)resnet50()25,557,032 80.858%(V2) fc(輸入 2048)vgg16()138,357,544 71.592% classifierefficientnet_b0()5,288,548 77.692% classifiermobilenet_v3_small()2,542,856 67.668% classifiervit_b_16()86,567,656 81.072% heads
數字取自 torchvision 0.21 各模型 DEFAULT 權重的官方 meta 資料。重點是最後一欄:只有 ResNet 家族的分類頭叫 fc ,換模型時第 9 行要跟著改。
執行後多了:
torchvision → 模組物件
torchvision.models.resnet50 → 一個「函式」(還沒做出任何模型)
新手常踩的坑
torch 和 torchvision 版本不配:例如單獨升級 torch 卻沒升 torchvision,可能在 import 或執行時出現 operator torchvision::nms does not exist 之類的錯誤。兩個一起用 pip 安裝最保險。
以為 import torchvision 就會下載模型:不會。下載發生在第 5 行呼叫 resnet50 的那一刻。
請 torchvision 的 resnet50 函式做一個 ResNet-50 模型,並把在 ImageNet 上訓練好的權重填進去,做好的模型物件取名叫 model。
逐字拆解
torchvision.models子模組 torchvision 的模型區。
.resnet50函式 小寫開頭的工廠函式 ,不是類別。它會替你呼叫 ResNet 類別並載入權重。
pretrained=True關鍵字參數 舊寫法:「要預訓練好的權重」。新版改用 weights=(下面會講)。
resnet50 函式裡面做了什麼(torchvision 0.21 原始碼節錄)
def resnet50(*, weights=None, progress=True, **kwargs):
    weights = ResNet50_Weights.verify(weights)
    return _resnet(Bottleneck, [3, 4, 6, 3], weights, progress, **kwargs)

def _resnet(block, layers, weights, progress, **kwargs):
    if weights is not None:
        _ovewrite_named_param(kwargs, "num_classes", len(weights.meta["categories"]))
    model = ResNet(block, layers, **kwargs)          # ← 這裡才真的用「類別」建立物件
    if weights is not None:
        model.load_state_dict(weights.get_state_dict(progress=progress, check_hash=True))
    return model
處理舊參數 :函式外面包了一層處理舊寫法的程式(裝飾器),先把 pretrained=True 翻譯成 weights=ResNet50_Weights.IMAGENET1K_V1,再檢查 weights 合不合法。鎖定 1000 類 :有權重時,強制 num_classes = 1000,因為權重檔裡的 fc 就是 1000 類。用 ResNet 類別建立物件 :Bottleneck 是區塊的種類,[3, 4, 6, 3] 是 layer1~layer4 各疊幾個區塊。這組數字決定了它是「50」層。填入權重 :load_state_dict(...) 下載(或從快取讀)權重檔,把 25,557,032 個數字填進對應位置。回傳 做好的物件,交給 model 這個名字。
舊寫法 pretrained=True 會跳兩個警告(不影響執行)
在 torchvision 0.21 執行第 5 行,會看到(實測):
UserWarning: The parameter 'pretrained' is deprecated since 0.13 and may be removed
in the future, please use 'weights' instead.
UserWarning: Arguments other than a weight enum or `None` for 'weights' are deprecated
since 0.13 and may be removed in the future. The current behavior is equivalent to passing
`weights=ResNet50_Weights.IMAGENET1K_V1`. You can also use `weights=ResNet50_Weights.DEFAULT`
to get the most up-to-date weights.
意思是:pretrained 從 0.13 版(2022 年)起不建議使用,目前效果等於 weights=ResNet50_Weights.IMAGENET1K_V1。警告(warning)不是錯誤(error),模型照樣建得起來,考題寫法完全可以執行。
新式寫法(建議)
from torchvision.models import resnet50, ResNet50_Weights

weights = ResNet50_Weights.DEFAULT       # 目前 DEFAULT = IMAGENET1K_V2
model = resnet50(weights=weights)
preprocess = weights.transforms()        # 這組權重配套的前處理
weights 給什麼 意思 ImageNet top-1 None(預設)不載入,全部隨機初始化(從零訓練) — ResNet50_Weights.IMAGENET1K_V12015 年原始配方訓練,= pretrained=True 76.13% ResNet50_Weights.IMAGENET1K_V2新配方重新訓練 80.858% ResNet50_Weights.DEFAULT「目前最好的那版」,torchvision 0.21 指向 V2 80.858%
預訓練模型要吃「它習慣的」圖片
weights.transforms() 會回傳一個前處理物件。V2 的內容是:短邊縮放到 232 → 中央裁切 224×224 → 轉成 0~1 的浮點數張量 → 用 ImageNet 的平均 [0.485, 0.456, 0.406]、標準差 [0.229, 0.224, 0.225] 做標準化;V1 則是縮放到 256 再裁 224。前處理和當初訓練時不一樣,凍結的特徵就會「看走眼」,程式不會報錯,但準確率會掉。
第一次執行會下載權重
權重檔不包含在套件裡。第一次呼叫時,會從 download.pytorch.org 下載(pretrained=True 對應的是 resnet50-0676ba61.pth,約 97.8 MB;V2 是 resnet50-11ad3fa6.pth,大小幾乎一樣),存到快取資料夾:
Windows :C:\Users\你的帳號\.cache\torch\hub\checkpoints\
macOS/Linux :~/.cache/torch/hub/checkpoints/
之後再執行就直接讀快取,不會重新下載。progress=True(預設)會顯示下載進度條;載入時還會用檔名裡的那段雜湊值檢查檔案(check_hash=True),檔案損壞就會報錯。
resnet50 完整參數表
參數 本題 預設值 白話 weights(沒寫,用舊參數代替) None要載入哪一組預訓練權重。None = 不載入、隨機初始化 progress— True下載權重時顯示進度條 pretrainedTrue(舊參數,已不在函式簽名裡) 0.13 起棄用;True 會被轉成 weights=IMAGENET1K_V1 並跳警告 以下是 **kwargs:resnet50 原封不動轉交給 ResNet 類別的參數 num_classes— 1000最後 fc 的輸出數。有指定 weights 時只能是 1000 zero_init_residual— False把每個殘差區塊最後一個 BatchNorm 的權重初始化成 0(從零訓練時的小技巧) groups— 1分組卷積的組數(ResNeXt 才會改) width_per_group— 64每組的寬度(Wide ResNet 才會改) replace_stride_with_dilation— None用空洞卷積取代縮小尺寸(語意分割常用) norm_layer— None(= nn.BatchNorm2d)正規化層要用哪個類別
簽名是 resnet50(*, weights=None, progress=True, **kwargs)。那顆 * 表示後面的參數都要用「名字=值」傳。寫 resnet50(True) 在 0.21 還能跑,但會多跳一個「Using 'weights' as positional parameter(s) is deprecated」警告。
執行完之後,model 身上有什麼
model → ResNet 物件(type(model) 是 torchvision.models.resnet.ResNet)
model.fc → Linear(in_features=2048, out_features=1000, bias=True) ← ImageNet 的 1000 類
參數 → 161 個參數張量,共 25,557,032 個數字,全部 requires_grad=True
model.training → True(新建立的模型預設是訓練模式)
ResNet 物件的內部零件(輸入 224×224 時,實測形狀)
屬性 是什麼 輸出形狀 參數數 conv17×7 卷積,64 個濾鏡,步幅 2 (N, 64, 112, 112) 9,408 bn1批次正規化 (N, 64, 112, 112) 128 reluReLU 激活 (N, 64, 112, 112) 0 maxpool3×3 最大池化,步幅 2 (N, 64, 56, 56) 0 layer13 個 Bottleneck 區塊 (N, 256, 56, 56) 215,808 layer24 個 Bottleneck 區塊 (N, 512, 28, 28) 1,219,584 layer36 個 Bottleneck 區塊 (N, 1024, 14, 14) 7,098,368 layer43 個 Bottleneck 區塊 (N, 2048, 7, 7) 14,964,736 avgpool全域平均池化 AdaptiveAvgPool2d((1, 1)) (N, 2048, 1, 1) 0 (flatten) forward 裡的 torch.flatten(x, 1) (N, 2048) 0 fc全連接層 2048 → 1000 (N, 1000) 2,049,000 合計 25,557,032
N 是一次餵幾張圖。fc 的 2,049,000 = 2048 × 1000 + 1000。整個模型將近六成的參數集中在 layer4。
新手常踩的坑
想一步到位做 2 類:resnet50(weights=ResNet50_Weights.DEFAULT, num_classes=2) 會報 ValueError: The parameter 'num_classes' expected value 1000 but got 2 instead.(權重檔的 fc 是 1000 類,對不上)。正確做法就是題目這樣:先載入,再換 fc。
寫成 torchvision.models.ResNet50(...):AttributeError: module 'torchvision.models' has no attribute 'ResNet50'。工廠函式是小寫 resnet50。
電腦沒網路或被防火牆擋住時,第一次執行會在下載那步失敗。可以先在能上網的地方下載,把 .pth 檔放進上面的快取資料夾。
忘了做 ImageNet 的前處理(或用了別的平均、標準差):程式不會報錯,效果卻會差很多。
看動畫 1:買下調好的工廠(0:14) 看動畫 2:resnet50 是函式(0:16)
呼叫 model 的 parameters 方法,拿到一台「一次吐一個參數」的出貨機;for 迴圈每次從裡面拿一個,暫時叫它 param,交給下一行處理,直到全部拿完。
逐字拆解
param迴圈變數 自己取的名字,每一輪指向不同的參數。叫 p 也可以。
model物件 第 5 行做出來的 ResNet 物件。
.parameters方法 從 nn.Module 繼承來的方法:「把你所有的參數交出來」。
parameters() 交出來的是什麼
回傳值是一個產生器 (generator)。每次 for 向它要下一個,它就沿著模型的子模組往下找,吐出下一個 nn.Parameter。實際的順序:
第 1 輪 param = conv1.weight 形狀 (64, 3, 7, 7)
第 2 輪 param = bn1.weight 形狀 (64,)
第 3 輪 param = bn1.bias 形狀 (64,)
… (layer1~layer4 裡的卷積與 BatchNorm 參數)
第 159 輪 param = layer4.2.bn3.bias 形狀 (2048,)
第 160 輪 param = fc.weight 形狀 (1000, 2048)
第 161 輪 param = fc.bias 形狀 (1000,)
→ 迴圈跑 161 輪;161 個張量裡的數字加起來 = 25,557,032
nn.Parameter:會被訓練的張量
每個 param 都是 nn.Parameter 物件。Parameter 是 Tensor(張量)的子類別(實測 issubclass(nn.Parameter, torch.Tensor) 是 True):本質上就是一塊多維數字陣列,只是多了一個身分——「我是模型要學的東西」。它身上常用的東西:
屬性/方法 例:conv1.weight 白話 .shapetorch.Size([64, 3, 7, 7])形狀:64 個濾鏡 × 3 個顏色通道 × 7 × 7 .requires_gradTrue(凍結前)要不要幫它算梯度——第 7 行就是改這個 .gradNone反向傳播後梯度存在這裡;還沒算過就是 None .dtype、.devicetorch.float32、cpu數字型別、放在 CPU 還是 GPU .numel()9408方法:裡面總共有幾個數字(§6 用它算參數量)
parameters() 的完整參數表
參數 本題 預設值 白話 recurse(沒寫) TrueTrue:連子模組、子模組的子模組全部往下找。False:只給「這個物件自己直接擁有」的參數。ResNet 本身不直接擁有參數(都在 conv1、layer1…裡),所以 model.parameters(recurse=False) 實測是空的
兄弟方法:想看名字就用 named_parameters()
for name, param in model.named_parameters():
    print(name, param.shape, param.requires_grad)
# conv1.weight torch.Size([64, 3, 7, 7]) True
# bn1.weight torch.Size([64]) True
# ...
每一輪拿到一個 tuple (名字, 參數),for name, param in … 會把它拆成兩個變數。完整簽名是 named_parameters(prefix='', recurse=True, remove_duplicate=True)。
產生器只能走一遍(實測)
g = model.parameters()
len(list(g))   # 161
len(list(g))   # 0   ← 第二次就空了
要重新走一遍,就再呼叫一次 model.parameters() 拿一台新的出貨機。第 10 行有一個相關的坑。
新手常踩的坑
漏了括號 for param in model.parameters::TypeError: 'method' object is not iterable。沒有呼叫方法,拿到的是「方法本身」。
漏了冒號會 SyntaxError;下一行沒縮排會 IndentationError。
以為 161 就是參數量:161 是「參數張量」的個數,每個張量裡有很多數字。總數要用 sum(p.numel() for p in model.parameters()) 算。
看動畫 2:出貨機一次吐一個(0:45)
把這一輪拿到的參數的 requires_grad 屬性設成 False:之後反向傳播不會幫它算梯度,它的值在訓練中就不會改變。迴圈跑完 161 輪,整個 ResNet-50 就被鎖住了。
逐字拆解
␣␣␣␣縮排 行首的 4 個空白(這裡用 ␣ 標出來),表示這行屬於上面的 for 迴圈,每一輪都會執行。
param物件 這一輪拿到的 nn.Parameter。
.requires_grad屬性 布林屬性:True = 要算梯度、False = 不用。沒有括號,所以是屬性不是方法。
# 行(A)註解 出題者加的標記,Python 會略過。
先弄懂「梯度」:訓練是怎麼改權重的
訓練神經網路像在山谷裡蒙著眼找最低點(loss 最小的地方)。梯度 告訴你:「每一個參數往哪個方向調、loss 會下降得最快,影響有多大」。PyTorch 的流程是:
前向 :model(x) 算出預測。只要算式裡有 requires_grad=True 的張量,PyTorch 就會邊算邊記下計算圖記錄「誰乘了誰、誰加了誰」的流程圖,反向傳播時沿著它倒著走。 。反向 :loss.backward() 沿著計算圖倒著走,用微積分的連鎖律算出每個 requires_grad=True 參數的梯度,存進它的 .grad 屬性。更新 :optimizer.step() 依照 .grad 修改參數的值。
requires_grad=False 的參數:第 2 步不會算它的梯度(.grad 一直是 None),第 3 步優化器看到沒有梯度就跳過它,值永遠不變 = 凍結 。但它仍然參與第 1 步:凍結的層照樣在「看圖」、產生特徵,只是不再學習。
比喻:161 組旋鈕的混音台
ResNet-50 像一台有 161 組旋鈕(加起來 2,556 萬個刻度)的混音台,已經由專業錄音師(ImageNet 訓練)調到很好的位置。行(A) 用膠帶把每一組旋鈕貼死:聲音照樣從混音台流過(前向計算照常),但再也沒有人能轉動它們(不會被更新)。
整個迴圈跑完後的狀態
161 個參數張量的 requires_grad:全部 False
可訓練參數:0 / 25,557,032
model.fc.weight.requires_grad → False ← 舊的 1000 類 fc 也一起被鎖住(反正下一行就換掉)
三種寫法,效果一樣
# 寫法 1:題目的寫法,逐一修改屬性
for param in model.parameters():
    param.requires_grad = False

# 寫法 2:呼叫 Module 的方法,一次鎖住底下所有參數(回傳 model 本身)
model.requires_grad_(False)

# 寫法 3:呼叫 Tensor 的方法,逐一設定
for param in model.parameters():
    param.requires_grad_(False)
名字結尾的底線 _ 是 PyTorch 的慣例,表示「就地修改(in-place)」,直接改物件本身。Module.requires_grad_ 的簽名是 requires_grad_(requires_grad=True),所以要解凍某一段就是 model.layer4.requires_grad_(True)(§4 的控制台會產生這種程式碼)。
為什麼要凍結?三個好處
保住學過的東西 :ImageNet 練出來的邊緣、紋理、形狀偵測器,不會被少量新資料亂改。資料少也不容易過擬合模型把訓練資料「背」起來,訓練集表現很好、新資料卻很差。能調的參數越多、資料越少,越容易發生。 :換上新 fc 後,可訓練的只剩 4,098 個參數。省時間、省記憶體 :反向傳播算到 fc 就停,Adam 也只要替 4,098 個參數記狀態。本頁驗證環境的 CPU 實測(batch 8):特徵萃取一步約 0.34 秒,全面微調約 1.09 秒。
進階:凍結參數 ≠ 凍結 BatchNorm 的統計值(實測)
ResNet-50 裡有 53 個 BatchNorm2d 層。BatchNorm 身上有兩種東西:可學的 weight、bias(是 Parameter,會被行(A) 鎖住),以及 running_mean、running_var、num_batches_tracked 這些累計統計值。後者是 buffer (緩衝區),不是 Parameter,不歸 requires_grad 管 ,而是在 model.train() 模式下每做一次前向計算就自動更新。
for p in model.parameters():
    p.requires_grad = False
model.train()
model(torch.randn(4, 3, 224, 224))
# bn1.running_mean 改變了嗎? True    ← 統計值還是被新資料改了
# bn1.num_batches_tracked:0 → 1
# bn1.weight 改變了嗎?      False   ← 參數確實鎖住了

model.eval()
model(torch.randn(4, 3, 224, 224))
# bn1.running_mean 改變了嗎? False   ← eval 模式才不會動
所以做純粹的特徵萃取時,有些人會在訓練時把主幹設成 eval()(例如直接 model.eval(),只讓 fc 學;fc 是 Linear,不受 train/eval 影響,梯度照樣算得出來),讓主幹完全維持 ImageNet 的樣子。兩種做法都有人用:新資料和 ImageNet 很不一樣時,讓統計值跟著新資料調整有時反而比較好。要記住的是:requires_grad 管的是 Parameter,管不到 BatchNorm 的 running 統計值 。
新手常踩的坑
param.requires_grad == False:兩個等號是「比較」,算出 True/False 就丟掉,什麼都沒改,也不會報錯。實測迴圈跑完,可訓練參數還是 25,557,032 個。param.requires_grad = false(小寫 f):NameError: name 'false' is not defined. Did you mean: 'False'?param.require_grad = False(少一個 s):最陰險。Python 允許在物件上新增任意屬性,所以不會報錯 ,只是多了一個沒人理的 require_grad,真正的 requires_grad 還是 True(實測)。把凍結和 torch.no_grad() 搞混:with torch.no_grad(): 是「這一段計算不記錄計算圖」,用在推論;凍結是「這些參數永遠不學」,是參數身上的設定。
以為凍結了就萬無一失:BatchNorm 的 running 統計值仍會在 train 模式下更新(見上面的進階說明)。
看動畫 1:for 迴圈上鎖(0:54) 看動畫 2:param 改成 False(0:52)
用 nn.Linear 類別做一個新的全連接層(吃 2,048 個特徵、輸出 2 個分數),把 model 原本的 fc 換掉。新做的層預設是可訓練的,所以整個模型現在「只有這一層」能學。
逐字拆解
.fc屬性 ResNet 物件身上叫 fc 的屬性,裝著最後一層(一個子物件)。
nn.Linear類別 全連接層的設計圖(大寫 L)。
2048位置參數 第 1 個位置是 in_features:每筆輸入有幾個數字。
2位置參數 第 2 個位置是 out_features:要輸出幾個數字 = 類別數(例如貓/狗、良品/瑕疵品)。
2048 從哪來:一定要和前一站的輸出對上
fc 吃的是 avgpool 攤平後的向量。沿著 ResNet 的 forward 走一遍(輸入 224×224,實測):
layer4 輸出 (N, 2048, 7, 7) ← 2048 個通道,每個是 7×7 的小圖
avgpool 輸出 (N, 2048, 1, 1) ← 每張 7×7 取平均,變成 1 個數字
flatten 輸出 (N, 2048) ← 拉平成 2048 維向量:這就是「萃取出來的特徵」
fc 輸出 (N, 2) ← 新的分類頭
2048 = layer4 的基本寬度 512 × Bottleneck 的擴張倍數 4(torchvision 原始碼就是 nn.Linear(512 * block.expansion, num_classes))。avgpool 是「自適應」池化 AdaptiveAvgPool2d((1, 1)),不管輸入圖片是 224 還是 300,都會壓成 1×1,所以 fc 永遠吃 2048 個數字。
更穩的寫法是讓程式自己讀:model.fc = nn.Linear(model.fc.in_features, 2)。舊 fc 的 in_features 屬性就是 2048;換成 resnet18 時它會自動變成 512,不用改數字(§6 就用這個寫法)。
nn.Linear 完整參數表
參數 本題 預設值 白話 in_features2048 (必填) 輸入向量的長度 out_features2 (必填) 輸出幾個數字;分類時 = 類別數 bias— True要不要加偏差 b device— None(= CPU)參數要建在哪個裝置上 dtype— None(= torch.float32)參數的數字型別
新的 fc 長什麼樣(實測)
model.fc → Linear(in_features=2048, out_features=2, bias=True)
model.fc.weight → 形狀 (2, 2048),requires_grad=True ← 注意是 (輸出, 輸入)
model.fc.bias → 形狀 (2,),requires_grad=True
參數數:2048 × 2 + 2 = 4,098
初始值:均勻分布的亂數,範圍約 ±1/√2048 ≈ ±0.0221
Linear 算的是「輸出 = 輸入 · WT + b」。PyTorch 把 weight 存成 (輸出數, 輸入數),和第 40 題 Keras 的 kernel(輸入數, 輸出數)剛好轉置——算出來一樣,只是存法不同。
為什麼新的 fc 可以訓練?
因為行(A) 的迴圈已經跑完了 。迴圈只處理「當時」存在的 161 個參數;這一行才新建的 Linear,它的 weight 和 bias 是全新的 nn.Parameter,預設 requires_grad=True 。
執行後:
可訓練:fc.weight (2, 2048) + fc.bias (2,) = 4,098
凍結: 其餘 159 個參數張量 = 23,508,032
總數: 23,512,130
(舊 fc 的 2,049,000 個參數已經被拆掉,不再算在模型裡)
物件導向重點:「指派一個層」為什麼就能換掉零件?
nn.Module 改寫了「設定屬性」這個動作(特殊方法 __setattr__)。當你把一個 nn.Module 物件指派給模型的屬性,它不只是存起來,還會自動登記成子模組 ,放進模型內部的 _modules 清單、取代同名的舊零件(實測順序仍是 conv1、bn1、…、avgpool、fc)。所以:
model.parameters() 之後吐出來的是新 fc 的參數,不是舊的。ResNet 的 forward 寫的是 x = self.fc(x),它會去拿「現在」叫 fc 的那個物件,所以預測自動變成 2 類。
舊的 fc 沒有任何名字指著它,Python 會自動把它回收。
順序很重要:先換 fc 再凍結,會發生什麼?(實測)
model.fc = nn.Linear(2048, 2)          # ✗ 先換
for param in model.parameters():       #   再凍結:新的 fc 也被鎖住
    param.requires_grad = False

optimizer = torch.optim.Adam(model.fc.parameters(), lr=1e-4)   # 不會報錯!
loss = loss_fn(model(x), y)            # 也不會報錯,但 loss 沒有 grad_fn
loss.backward()
# RuntimeError: element 0 of tensors does not require grad and does not have a grad_fn
可訓練參數變成 0。建立 Adam 時不會報錯 (它只是把 fc 的 2 個參數記下來);前向計算也正常;一直到 loss.backward() 才出錯,因為整張計算圖裡沒有任何需要梯度的東西。如果你改用「篩選 requires_grad 的參數」來建立優化器,則會更早在建立時就報 ValueError: optimizer got an empty parameter list。正確順序永遠是:先凍結舊的 → 再裝上新的 → 最後建立優化器 。
新手常踩的坑
nn.Linear(1024, 2)(數字和前一站對不上):建立時不會錯,一跑前向就 RuntimeError: mat1 and mat2 shapes cannot be multiplied (4x2048 and 1024x2)。model.FC = nn.Linear(2048, 2)(大寫):不會報錯,但這是「多掛一個叫 FC 的新零件」,forward 用的還是原本的 fc,輸出仍是 1000 類(實測 torch.Size([2, 1000]))。model.fc.out_features = 2:只改了一個「標籤」屬性,印出來雖然變成 out_features=2,權重矩陣還是 1000×2048,輸出仍是 1000 類(實測)。要換就換整個物件。換別的模型時屬性名不同:VGG、EfficientNet、MobileNet 的分類頭叫 classifier,ViT 叫 heads,只有 ResNet 家族叫 fc。
二分類卻寫 nn.Linear(2048, 1) 配 CrossEntropyLoss:CrossEntropyLoss 要每個類別各一個分數(2 類就輸出 2 個);只輸出 1 個分數的寫法要改配 BCEWithLogitsLoss。
看動畫 1:拆掉舊 fc(1:06) 看動畫 2:新的 Linear 物件(1:04)
用 Adam 類別建立一個優化器物件,交代它:「你只負責 fc 的 2 個參數張量(共 4,098 個數字),基本步伐(學習率)是 0.0001」,取名 optimizer。之後訓練時每呼叫一次 optimizer.step(),它就照梯度把這 4,098 個數字調一次。
逐字拆解
optimizer變數 自己取的名字,慣例叫 optimizer 或 opt。
torch.optim子模組 放各種優化器的地方(因為第 1 行有 import torch 才能這樣寫)。
.Adam類別 大寫開頭,Adam 優化演算法的設計圖。
model.fc物件 第 9 行剛裝上的 Linear 物件。
.parameters()方法 Linear 也繼承了 nn.Module 的這個方法,只吐出 fc.weight、fc.bias 兩個。
lr=1e-4關鍵字參數 learning rate,學習率 = 0.0001。
為什麼只交 model.fc.parameters()?兩道鎖
行(A) :主幹的 requires_grad=False → 反向傳播根本不算它們的梯度(省時間、省記憶體)。第 10 行 :只把 fc 交給 Adam → 優化器只會更新「交給它的」參數,就算主幹有梯度,Adam 也不會去改。
做個思考實驗:如果把行(A) 整個刪掉、第 10 行不變,主幹的權重仍然不會被改(實測 conv1.weight 沒變),只是反向傳播會白白替全部 161 個參數張量算梯度,又慢又佔記憶體。所以行(A) 的主要功能是「讓 autograd 不用算」,第 10 行則「確保只改 fc」。
Adam 完整參數表
參數 本題 預設值 白話 paramsmodel.fc.parameters()(必填) 要它負責更新哪些參數。可以給產生器、list,或分組的 dict lr1e-40.001學習率:每一步的基本步伐。本題比預設小 10 倍 betas— (0.9, 0.999)兩個「記憶衰減率」:梯度平均、梯度平方平均各保留多少過去的資訊 eps— 1e-08分母加的極小值,避免除以 0 weight_decay— 0權重衰減(L2 懲罰),抑制權重變太大 amsgrad— False是否用 AMSGrad 變形版 foreach— None是否把多個參數合在一起算來加速(None = 自動決定) maximize— FalseTrue 會改成「讓目標變大」 capturable— False配合 CUDA Graph 使用的進階選項 differentiable— False讓更新步驟本身也能被微分(研究用) fused— None使用融合版實作加速(GPU 上較常用)
簽名:Adam(params, lr=0.001, betas=(0.9, 0.999), eps=1e-08, weight_decay=0, amsgrad=False, *, foreach=None, maximize=False, capturable=False, differentiable=False, fused=None)。* 後面的參數只能用「名字=值」傳。
1e-4 是多少?
科學記號:1e-4 = 1 × 10-4 = 0.0001 (Python 裡 1e-4 == 0.0001 是 True,型別是 float)。為什麼遷移學習常把學習率設得比預設小,是第 43 題的主題;這裡先記住它是 0.0001 就好。
和第 40 題的 Keras Adam 比一比
兩邊預設學習率都是 0.001,但 epsilon 預設不同:Keras 是 1e-07,PyTorch 是 1e-08。另外 Keras 可以在 compile(optimizer='adam') 用字串指定;PyTorch 一定要自己用類別建立物件,而且建立時就要告訴它管哪些參數 。
optimizer 物件身上有什麼(實際 print 結果)
print(optimizer)
# Adam (
# Parameter Group 0
#     amsgrad: False
#     betas: (0.9, 0.999)
#     capturable: False
#     differentiable: False
#     eps: 1e-08
#     foreach: None
#     fused: None
#     lr: 0.0001
#     maximize: False
#     weight_decay: 0
# )
屬性/方法 做什麼 .param_groups(屬性)一個 list,每組是一個 dict:{'params': [fc.weight, fc.bias], 'lr': 0.0001, …}。想中途改學習率就改這裡 .state(屬性)Adam 替每個參數記的「動量」資料。剛建立時是空的;第一次 step() 之後,每個參數會多出 step、exp_avg、exp_avg_sq .zero_grad()清掉參數的 .grad(預設 set_to_none=True,設回 None)。每一步開始前都要呼叫,否則梯度會一直累加 .step()照目前的 .grad 更新一次參數 .state_dict()、.load_state_dict()存、讀優化器狀態(中斷後接著訓練用) .add_param_group({...})中途再加一組參數,例如訓練到一半才解凍 layer4
之後的訓練迴圈長這樣(第 50 題會詳講)
loss_fn = nn.CrossEntropyLoss()
for x, y in train_loader:            # 一批一批拿資料
    optimizer.zero_grad()            # ① 清掉上一步的梯度
    loss = loss_fn(model(x), y)      # ② 前向 + 算 loss
    loss.backward()                  # ③ 反向:只有 fc 會拿到梯度
    optimizer.step()                 # ④ Adam 更新 fc 的 4,098 個數字
Adam 要多少額外記憶體
Adam 替每個參數記兩個數字(exp_avg 一階動量、exp_avg_sq 二階動量)。本題只管 4,098 個參數,額外只要記 8,196 個數字;如果全面微調 23,512,130 個參數,就要多記 47,024,260 個(實測 Adam state 的數量),以 float32 每個 4 bytes 計約 188 MB。
新手常踩的坑
torch.optim.adam(...)(小寫):AttributeError: module 'torch.optim' has no attribute 'adam'。類別是大寫 Adam。Adam(model.fc.parameters, lr=1e-4)(漏括號):TypeError: 'method' object is not iterable。先把產生器存起來又用掉:params = model.fc.parameters(); print(list(params)); Adam(params, lr=1e-4) → ValueError: optimizer got an empty parameter list(產生器第二次已經空了)。
lr=1e4(少了負號):那是 10,000,不是 0.0001,訓練會立刻爆掉。先建立優化器、之後才換 fc:優化器記住的是「當時」的參數物件,換掉 fc 之後,它會一直更新那個已經被拆下來的舊 fc,新的 fc 永遠學不到東西。所以一定是先換 fc,再建立優化器 (題目的順序正確)。
看動畫 1:Adam 調音師(1:27) 看動畫 2:Adam 的清單(1:25)