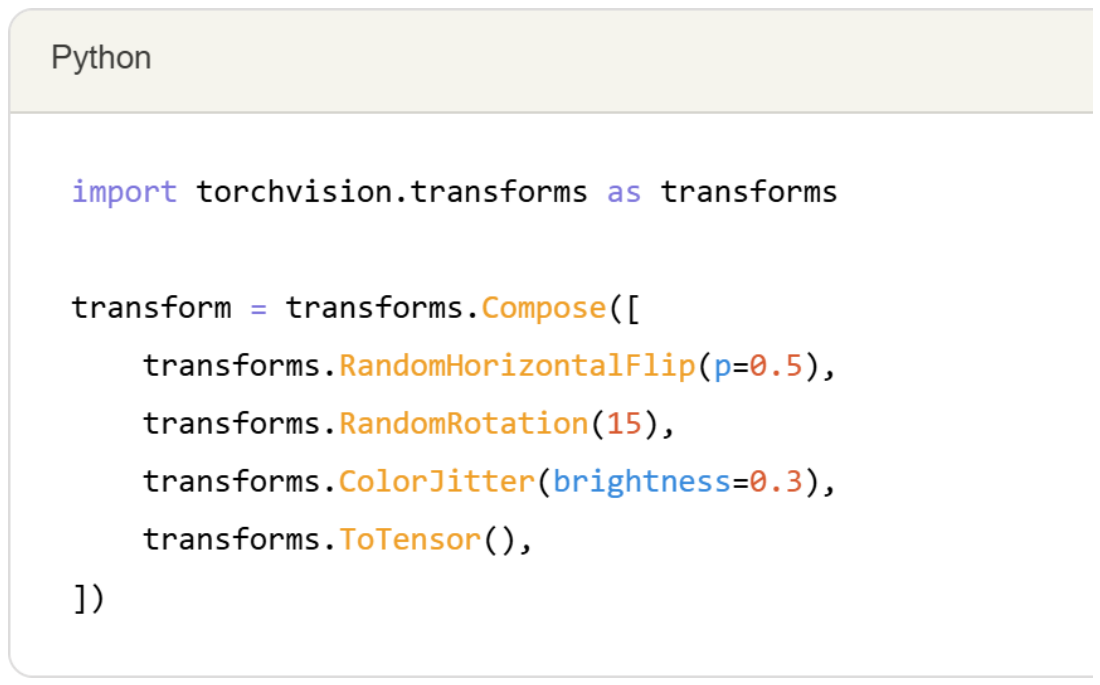
從 torchvision 套件裡,把 transforms(影像轉換工具)這個模組整個拿進來,之後用 transforms 這個名字叫它。
逐字拆解
torchvision套件PyTorch 官方的影像套件,要先安裝(pip install torchvision)才有,版本要和 torch 配對。
.transforms模組點 = 「的」。torchvision 的 transforms 區,放著所有影像轉換類別。
transforms綽號之後程式裡的 transforms 就是指這個模組。剛好和原名一樣,所以看起來像多此一舉,但少了 as transforms,你就得每次寫 torchvision.transforms.X。
這一行執行時發生什麼事
Python 會找到已安裝的 torchvision,把 transforms 模組載入記憶體(第一次 import torch 相關套件可能要一兩秒),然後在目前的程式裡建立一個名字 transforms,指向這個模組物件。
執行後多了:
transforms → <module 'torchvision.transforms' from '…/torchvision/transforms/__init__.py'>
(一個「模組」物件,裡面有 Compose、RandomHorizontalFlip、ToTensor … 等類別)
模組裡拿東西:transforms.X
之後的 transforms.Compose、transforms.ToTensor,意思都是「transforms 模組的 Compose 類別」。這行只是把貨架搬過來,還沒有做出任何物件。
新手常踩的坑
- 寫成
import torchvision.transform(少了 s):模組名稱是複數 transforms,會出現 ModuleNotFoundError。
- 寫成
import torchvision.transforms.ToTensor:import 後面要接模組,ToTensor 是類別,要改用 from torchvision.transforms import ToTensor。
- 之後把變數也取名
transforms:例如 transforms = transforms.Compose([...]),模組的綽號就被流水線物件蓋掉了,下一次寫 transforms.ToTensor() 會出現 AttributeError: 'Compose' object has no attribute 'ToTensor'(本頁實測的錯誤訊息)。所以題目才用沒有 s 的 transform 當變數名。
用 Compose 做出一條影像加工生產線,線上依序放 4 台機器(第 4~7 行做出來的 4 個轉換物件)。做好後取名叫 transform。之後只要寫 transform(img),圖片就會依序經過這 4 台機器。
逐字拆解
transform變數自己取的名字(沒有 s),像貼在生產線上的名牌。取 train_tf、aug 都可以。
=指派不是數學的等於。「把右邊做出來的東西,貼上左邊的名牌」。
transforms.模組L1 取綽號的那個模組,點 = 「的」。
Compose(類別+括號類別加括號 = 建立物件。Python 會自動執行 Compose 的 __init__。Compose 是英文「組合」的意思。
[list 開頭Compose 唯一的參數是一個 list,裡面裝要串起來的轉換物件。
])收尾(第 8 行)先關 list 的 ],再關 Compose 呼叫的 )。括號一關,第 3~8 行這一整句才結束。
Compose 完整參數表
| 參數 | 本題的值 | 預設值 | 白話 |
|---|
transforms | 4 個轉換物件組成的 list | (必填,沒有預設值) | 要依序套用的轉換。list 的順序 = 處理的順序。Compose 就只有這一個參數(inspect.signature 實測:(transforms)) |
建立物件那一刻:__init__ 做了什麼
回想 §1 觀念 4 的精簡原始碼。transforms.Compose([a, b, c, d]) 執行時:
- Python 先做出一個空的 Compose 物件。
- 自動呼叫
__init__(self=那個新物件, transforms=[a, b, c, d])。
self.transforms = transforms:把 list 存到物件身上,變成它的屬性。- 建立完成,這個物件被貼上
transform 名牌。
執行後(實際用 print 印出):
>>> print(transform)
Compose(
RandomHorizontalFlip(p=0.5)
RandomRotation(degrees=[-15.0, 15.0], interpolation=nearest, expand=False, fill=0)
ColorJitter(brightness=(0.7, 1.3), contrast=None, saturation=None, hue=None)
ToTensor()
)
type(transform) → torchvision.transforms.transforms.Compose
callable(transform) → True ← 可以像函式一樣呼叫
transform.transforms → 裝 4 個物件的 list(屬性,沒有括號)
len(transform.transforms) → 4
注意 print 出來的內容:你只寫了 RandomRotation(15),它卻印出 degrees=[-15.0, 15.0] 和三個你沒寫的參數。這就是「沒寫不代表沒有,沒寫的用預設值」,下面幾張卡會一個一個講。
呼叫 transform(img) 時的實況轉播
transform(img)
→ Python:transform 是 Compose 物件,去 Compose 類別找 __call__
→ Compose.__call__(self=transform, img=img)
第 1 圈:t = RandomHorizontalFlip 物件 → img = t(img) 可能被左右翻轉
第 2 圈:t = RandomRotation 物件 → img = t(img) 轉 −15°~+15°
第 3 圈:t = ColorJitter 物件 → img = t(img) 亮度 ×0.7~1.3
第 4 圈:t = ToTensor 物件 → img = t(img) PIL 圖 → 張量
→ return img ← 現在 img 是 torch.Size([1, 28, 28]) 的 float32 張量
前三圈 img 一直是 PIL 圖片,只有第 4 圈之後才變成張量。這也是為什麼 ToTensor 通常放最後:前面的修圖都在 PIL 圖片上做完,最後再一次轉成數字。
Compose 物件身上有什麼方法
| 方法 | 什麼時候被執行 | 做什麼 |
|---|
__init__(self, transforms) | transforms.Compose([...]) 建立物件時 | 把 list 存成 self.transforms |
__call__(self, img) | transform(img) 時 | for 迴圈依序套用每個轉換,回傳最後結果 |
__repr__(self) | print(transform) 時 | 產生上面那段好讀的文字 |
Compose 類別自己定義的就只有這三個(實測 Compose.__dict__)。它很單純:就是一個裝著 list、會依序跑 for 迴圈的物件。
進階:Compose 不是 nn.Module
Compose 的繼承關係只有 Compose → object,不是 PyTorch 的 nn.Module,官方說明文件寫明它不支援 TorchScript(把模型編譯成可部署格式的工具)。如果要把前處理一起編譯,官方建議改用 torch.nn.Sequential(...) 串,而且裡面只能放能處理張量的轉換。考試用不到,知道就好。
新手常踩的坑
- 忘了方括號:
transforms.Compose(a, b)。Compose 只收一個 list,實測會出現 TypeError: Compose.__init__() takes 2 positional arguments but 3 were given(2 個是 self 和 transforms,你卻給了 self+2 個)。
- 以為第 3~8 行執行完圖片就處理好了:這幾行只是「把生產線組好」,一張圖都還沒碰到。要等
transform(img) 被呼叫才會真的動手。
- 順序放錯:例如把
Normalize 放在 ToTensor 前面,Normalize 收到 PIL 圖片,實測會出現 TypeError: img should be Tensor Image. Got <class 'PIL.Image.Image'>。
做一台「每次擲一次銅板」的翻轉機:每張圖進來,有 50% 機率被左右鏡像翻轉,50% 原樣放行。對貓狗照片沒問題,但對字母來說,b 翻過來就是 d。
逐字拆解
transforms.模組從 transforms 貨架拿。
RandomHorizontalFlip類別Random(隨機)+ Horizontal(水平)+ Flip(翻轉)。「水平翻轉」是左右對調,像照鏡子。
(建立物件類別加括號,做出一台翻轉機。這個物件沒有自己的名字,直接當成 list 的第 1 個元素交給 Compose 保管。
p=0.5關鍵字參數p 是 probability(機率):每張圖被翻轉的機率是 0.5。
RandomHorizontalFlip 完整參數表
| 參數 | 本題的值 | 預設值 | 白話 |
|---|
p | 0.5 | 0.5 | 翻轉的機率,0~1 之間。0 = 永遠不翻,1 = 每張都翻。本題寫的值剛好就是預設值,寫 RandomHorizontalFlip() 結果完全相同 |
它就只有這一個參數(實測 signature:(p=0.5))。
翻轉機的內部:forward 方法(torchvision 0.21 原始碼)
def forward(self, img):
    if torch.rand(1) < self.p:
        return F.hflip(img)
    return img
torch.rand(1):從 0~1 之間均勻抽一個亂數。抽到 0.31 → 小於 0.5 → 翻;抽到 0.73 → 不翻。所以長期來看剛好一半被翻。self.p:建立物件時存下的 0.5(屬性)。F.hflip(img):真正動手翻的函式(F 是 torchvision.transforms.functional)。PIL 圖片會呼叫 Pillow 的 img.transpose(Image.FLIP_LEFT_RIGHT);如果傳進來的是張量,則把最後一個維度(寬)倒過來。- 沒翻的時候直接
return img,連複製都沒有,原封不動交出去。
因為它繼承 torch.nn.Module,所以 Compose 呼叫 t(img) 時會走「nn.Module 的 __call__ → forward」這條路(§1 觀念 5)。
這個物件身上:
flip.p → 0.5
flip.training → True (nn.Module 都有的屬性,下面會說它對翻轉沒影響)
flip(img) → 一張 PIL 圖片(大小不變,可能被翻過,也可能沒有)
為什麼它是禍首:字母方向就是答案
資料增強的前提是「變化後答案不變」。但 b 左右翻轉後就長成 d,標籤卻還寫著 b,因為 transform 只改圖片,完全不碰標籤。
| 翻轉方式 | 會互換的字母 | 對應的轉換 |
|---|
| 左右翻轉(水平) | b ↔ d、p ↔ q | RandomHorizontalFlip(本題) |
| 上下翻轉(垂直) | b ↔ p、d ↔ q(n 和 u 也很像) | RandomVerticalFlip |
| 轉 180° | b ↔ q、d ↔ p(數字 6 ↔ 9) | 大角度的 RandomRotation |
那模型學到什麼?假設 b 和 d 一樣多。訓練時,模型看到的「b 形狀」圖片有兩種來源:沒被翻的真 b(標籤 b),以及被翻過來的 d(標籤 d)。兩種一樣多、長得一樣,模型能做到最好的就是回答「b 50%、d 50%」,跟擲銅板一樣。部署後遇到真實的 b,當然常常認錯。這就是選項 B 說的「以 50% 機率學到鏡像錯誤標籤」。
其他字母呢?像 a、e、k 翻過來變成現實中不存在的鏡像字,不會和別的字母搶標籤,但模型白白花力氣學了沒人會寫的字形。o、x 這類左右對稱的字母翻了也沒差。§4 的抽籤機可以三種都試試看。
model.eval() 不會關掉翻轉
RandomHorizontalFlip 雖然繼承 nn.Module、也有 .training 屬性,但它的 forward 裡完全沒有檢查這個屬性。實測:對它呼叫 .eval() 之後抽 1000 次,仍然翻了 487 次。所以「訓練用增強、驗證不用」只能靠建立兩個不同的 transform 來做到,不能靠切換模式。
新手常踩的坑
- 看到網路範例(多半是貓狗、CIFAR-10 這種一般物體)都加了水平翻轉,就照抄到文字、數字辨識上。翻轉適不適合,要看「翻完之後答案變不變」。
- 以為 p 是翻轉的「幅度」:p 是機率,翻就是整張完整鏡像,沒有翻一半這種事。
- 以為只影響 4 個字母、整體準確率還不錯就沒關係:這 4 個字母的準確率會掉到接近擲銅板,§4 會用數字算給你看。
做一台隨機旋轉機:每張圖進來,從 −15° 到 +15° 之間隨機抽一個角度,把圖轉過去。模擬「每個人寫字時紙張歪的角度不一樣」。
逐字拆解
RandomRotation類別Random(隨機)+ Rotation(旋轉)。
(15)位置參數沒寫名字,照位置對應第 1 個參數 degrees。寫成 RandomRotation(degrees=15) 完全一樣。
degrees = 15 不是「轉 15 度」
給一個數字 15,torchvision 會在 __init__ 裡把它換成範圍 [-15.0, 15.0] 存起來。每次處理圖片時,再從這個範圍均勻地抽一個角度(原始碼:torch.empty(1).uniform_(degrees[0], degrees[1]))。所以可能轉 +3.2°、−11.7°、+14.9°,每次都不一樣。
- 正數 = 逆時針,負數 = 順時針(官方文件寫 counter-clockwise,本頁也實際轉了一張圖確認)。
- 也可以直接給範圍:
RandomRotation((-5, 10)) 表示從 −5° 到 +10° 之間抽。
RandomRotation 完整參數表
| 參數 | 本題的值 | 預設值 | 白話 |
|---|
degrees | 15 → [-15.0, 15.0] | (必填) | 角度範圍。一個數字 x 代表 [−x, +x];也可以給 (最小, 最大) |
interpolation | — | InterpolationMode.NEAREST | 轉完之後新像素怎麼算。NEAREST(最近鄰)直接抄最近的舊像素,快但邊緣鋸齒;BILINEAR(雙線性)取周圍平均,比較平滑 |
expand | — | False | False:維持原本大小,轉出去的角落被裁掉;True:把畫布放大到裝得下整張轉過的圖(圖片尺寸會變) |
center | — | None | 旋轉中心。None = 圖片正中央 |
fill | — | 0 | 轉完後空出來的角落要補什麼顏色。0 = 黑色 |
這個物件身上:
rot.degrees → [-15.0, 15.0] ← 15 被轉成範圍了
rot.interpolation → InterpolationMode.NEAREST
rot.expand → False
rot.fill → 0
rot(img) → 一張 PIL 圖片,還是 28×28
fill=0 的小陷阱:白底的圖會長出黑角
EMNIST、MNIST 這類資料是黑底白字,背景本來就是 0,補黑色剛好看不出來。但如果你的資料是白底黑字,轉完四個角會出現黑色三角形。本頁實測:一張全白的 28×28 圖轉 15°,有 80 個像素變成 0。這時要改成 fill=255。§4 的抽籤機可以切到白底看看。
和選項 A 的關係
±15° 對手寫字其實是常見的溫和範圍:b 歪 15° 還是 b,不會變成 d。要讓 b 變成別的字母,得轉到接近 180°(b 變 q)。所以「角度太大」可能讓字有點變形,但解釋不了「錯誤剛好集中在 b/d/p/q」這個現象。
新手常踩的坑
- 寫
RandomRotation(-15) 想表示「往順時針轉」:單一數字必須是正數,實測會出現 ValueError: If degrees is a single number, it must be positive.
- 以為每張都轉 15 度:是從範圍裡隨機抽,抽到接近 0° 的機會和抽到 14° 一樣多。
- 數字辨識用太大的角度(例如 180):6 和 9 會互換,和本題的 b/d 是同一類錯誤。
做一台隨機調光機:每張圖進來,從 0.7 倍到 1.3 倍之間抽一個亮度倍率,每個像素都乘上它。模擬「筆的深淺、掃描時光線不同」。
逐字拆解
ColorJitter類別Color(顏色)+ Jitter(抖動):隨機抖動顏色相關的屬性。
brightness=0.3關鍵字參數亮度抖動的幅度。0.3 會被換成倍率範圍 (0.7, 1.3)。
ColorJitter 完整參數表
| 參數 | 本題的值 | 預設值 | 白話 |
|---|
brightness | 0.3 → (0.7, 1.3) | 0(不調) | 亮度倍率範圍。給 x 代表 [max(0, 1−x), 1+x];也可以直接給 (0.8, 1.2) |
contrast | — | 0(不調) | 對比倍率範圍,規則同上 |
saturation | — | 0(不調) | 飽和度(顏色鮮豔程度)。對灰階圖沒有效果(實測灰階圖調完完全不變) |
hue | — | 0(不調) | 色相(偏紅偏藍)。給 x 代表 [−x, +x],x 最大 0.5。灰階圖直接原樣回傳 |
這個物件身上(實際印出):
cj.brightness → (0.7, 1.3)
cj.contrast → None ← 預設 0 會被存成 None,代表「這項關掉」
cj.saturation → None
cj.hue → None
亮度倍率實際上怎麼改像素
對 PIL 圖片,torchvision 呼叫 Pillow 的 ImageEnhance.Brightness:每個像素乘上倍率,超過 255 的截在 255。本頁實測一排像素 [0, 128, 255]:
| 倍率 | 0(黑底) | 128(灰) | 255(白色筆畫) |
|---|
| × 0.7 | 0 | 89 | 178 |
| × 1.0 | 0 | 128 | 255 |
| × 1.3 | 0 | 166 | 255 |
黑底永遠是 0,變的只有筆畫的深淺。字的形狀、方向完全沒動,b 怎麼調都還是 b。這就是選項 C 不成立的原因。
補充:ColorJitter 每次會用 torch.randperm(4) 隨機決定亮度、對比、飽和度、色相的處理順序。本題只開了亮度,順序沒有影響。
新手常踩的坑
- 以為
brightness=0.3 是「調暗 30%」:它是「在 0.7~1.3 倍之間隨機」,可能變暗也可能變亮。
- 給太大:
brightness=1.5 實測會變成範圍 (0.0, 2.5),倍率抽到接近 0 時整張圖幾乎全黑,等於餵模型一張空白圖。
- 給負數或 hue 超過 0.5:實測分別出現
ValueError: If brightness is a single number, it must be non negative. 和 hue values should be between (-0.5, 0.5)。
生產線最後一站:把 PIL 圖片換成 PyTorch 能計算的張量,把 0~255 的整數縮成 0.0~1.0 的小數,形狀排成「通道 × 高 × 寬」。
逐字拆解
ToTensor類別To(轉成)+ Tensor(張量)。
()建立物件沒有任何參數,但括號一定要寫,因為要放進 list 的是「物件」,不是「類別」。
,尾逗號list 最後一個元素後面多一個逗號是合法的,方便之後再加一行。
ToTensor 完整參數表
| 參數 | 本題的值 | 預設值 | 白話 |
|---|
| (沒有任何參數) | — | — | 實測 signature:()。它只做一件固定的事,不需要設定 |
它做了三件事
- 換型別:PIL 圖片(或 NumPy 陣列)→
torch.Tensor,資料型別 float32。
- 縮放數值:0~255 的整數 ÷ 255 → 0.0~1.0。例如 255 → 1.0、178 → 0.698、0 → 0.0。
- 調整維度順序:圖片習慣的「高 × 寬 × 通道」(H×W×C) → PyTorch 習慣的「通道 × 高 × 寬」(C×H×W)。灰階圖只有 1 個通道channel:每個像素有幾個數字。灰階 1 個(亮度),彩色 RGB 有 3 個(紅、綠、藍)。,所以 28×28 的灰階圖變成
[1, 28, 28];彩色 28×28 會變成 [3, 28, 28]。
實測(28×28 灰階 PIL 圖):
輸入 PIL Image, mode='L', size=(28, 28),像素 0~255 的整數
輸出 torch.Size([1, 28, 28]),torch.float32,最小 0.0、最大 1.0
和其他轉換不一樣的地方:它不是 nn.Module
ToTensor 的繼承關係是 ToTensor → object,邏輯直接寫在 __call__,原始碼只有一行:return F.to_tensor(pic)。官方文件也註明它不支援 TorchScript。
選項 D:ToTensor 一定要放在幾何變換前面嗎?
不用。翻轉、旋轉、調亮度都能直接處理 PIL 圖片,所以傳統寫法是「先在 PIL 圖上修完,最後 ToTensor」。而且舊版 transforms 的這幾個轉換也能處理張量,本頁實測把 ToTensor 改放第一個,整條線照樣跑得動、輸出一樣是 [1, 28, 28]。順序的硬性規定只有一條:需要張量的轉換(例如 Normalize)要放在 ToTensor 後面。所以 D「必須放在所有幾何變換之前」是錯的,而且就算換順序,b 被翻成 d 的問題也不會消失。
版本小知識:transforms.v2 的新寫法
torchvision 後來推出 torchvision.transforms.v2,類別名稱大多相同(v2.RandomHorizontalFlip、v2.RandomRotation…)。其中 ToTensor 在 v2 被標為「即將淘汰」,實測呼叫 v2.ToTensor() 會跳警告,建議改成兩步:
from torchvision.transforms import v2
to_tensor = v2.Compose([
    v2.ToImage(),                           # PIL 圖片 → 影像張量(uint8,還是 0~255)
    v2.ToDtype(torch.float32, scale=True),  # 轉成 float32,scale=True 才會 ÷255 變 0~1
])
實測輸出同樣是 [1, 28, 28]、float32、0.0~1.0。另外 v2 的 Compose 和 ToImage 都繼承 nn.Module,和舊版不同。考題用的是舊版寫法,兩種都看得懂就好。
新手常踩的坑
- 忘了括號寫成
transforms.ToTensor:list 裡放的變成「類別」,Compose 執行 t(img) 時等於在建立物件,實測錯誤是 TypeError: ToTensor.__init__() takes 1 positional argument but 2 were given。
- 對已經是張量的東西再 ToTensor 一次:實測
TypeError: pic should be PIL Image or ndarray. Got <class 'torch.Tensor'>。
- 以為所有輸入都會 ÷255:只有 uint8(0~255 整數)的圖會縮放;如果餵 float 型別的 NumPy 陣列,實測 255.0 進去還是 255.0 出來。
- 想保留 0~255 整數,要用另一個類別
PILToTensor()(實測輸出 uint8、最大 255)。
第 3~8 行只是「組好一條生產線」。真正開工是在訓練時:資料集每取出一張圖,就呼叫一次 transform(img),而且每次都重新擲骰子。資料不會因此變多,但同一張圖每個 epoch 看起來都不一樣。
transform 交給 Dataset 保管(示意,不必執行)
import torchvision
from torch.utils.data import DataLoader

train_set = torchvision.datasets.EMNIST(
    root='data', split='letters', train=True,
    download=True, transform=transform)          # ← 把整條生產線交給資料集
loader = DataLoader(train_set, batch_size=64, shuffle=True)

for x, y in loader:      # 每一圈取 64 張,每張都在這時才跑 transform
    ...                  # x: [64, 1, 28, 28],y: 64 個標籤
| EMNIST 參數 | 這裡的值 | 預設值 | 白話 |
|---|
root | 'data' | (必填) | 資料存放的資料夾 |
split | 'letters' | (必填) | 要哪一份。可選 byclass、bymerge、balanced、letters、digits、mnist |
train | True | True | True 拿訓練集,False 拿測試集 |
download | True | False | 本機沒有就自動下載 |
transform | transform | None | 對圖片做的處理,就是本題那條生產線 |
target_transform | — | None | 對標籤做的處理。本題沒有,所以圖被翻了標籤也不會跟著改 |
EMNIST 的 signature 是 (root, split, **kwargs),train、download、transform、target_transform 這幾個是透過 **kwargs 轉交給它的父類別 MNIST(實測 MNIST 的 signature 確認了上面的預設值)。letters 分割把大小寫合併成 26 類,類別清單實測是 ['N/A', 'a', 'b', …, 'z'],所以標籤是 1~26(b = 2、d = 4)。
Dataset 取一張圖時,transform 在這裡被呼叫
EMNIST 繼承自 MNIST,取第 i 張圖時跑的是 MNIST 的 __getitem__(torchvision 0.21 原始碼節錄):
def __getitem__(self, index):
    img, target = self.data[index], int(self.targets[index])
    img = Image.fromarray(img.numpy(), mode="L")     # 先變成 PIL 灰階圖
    if self.transform is not None:
        img = self.transform(img)                    # ← 呼叫 Compose.__call__
    if self.target_transform is not None:
        target = self.target_transform(target)
    return img, target
看到了嗎?self.transform 就是你交給它的 Compose 物件,self.transform(img) 就是觀念 5 講的「像函式一樣呼叫物件」。而標籤 target 走的是另一條路,和圖片怎麼被翻轉完全無關。
即時(on-the-fly)隨機:資料不會變多,但每次都不一樣
本頁用 200 張假圖做的 Dataset 實測:
len(ds) → 200 ← 加了增強,筆數還是 200
x1, y1 = ds[0]; x2, y2 = ds[0]
torch.equal(x1, x2) → False ← 同一張圖取兩次,結果不同
y1, y2 → 1, 1 ← 標籤永遠一樣
DataLoader(batch_size=64) 取一批 → x: torch.Size([64, 1, 28, 28]) float32
y: torch.Size([64]) int64
- 資料增強不會先把資料集複製成好幾倍存起來。10 萬張的資料集,每個 epoch 還是看 10 萬次。
- 但每次取圖都重新抽亂數,所以第 1 個 epoch 的第 0 張可能是「翻轉+轉 7°」,第 2 個 epoch 變成「沒翻+轉 −12°」。等於每個 epoch 都看到一份新的版本。
- 這也代表:翻轉造成的「圖文不符」不是只發生一次,而是每個 epoch 都有約一半的 b/d/p/q 被教錯,模型永遠擺脫不了。§4 的動畫 3 用 4 個 epoch 演給你看。
驗證集要用另一條「不隨機」的生產線
val_transform = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize((0.5,), (0.5,)),   # 選用:0~1 → -1~1
])
val_set = torchvision.datasets.EMNIST(root='data', split='letters', train=False,
                                      download=True, transform=val_transform)
驗證和測試是在模擬「真實上線的情況」,不應該加隨機變化,同一張圖每次評估都該得到一樣的分數(實測 val_transform 對同一張圖跑兩次,結果完全相同)。完整修正版在 §5。
新手常踩的坑
- 訓練集和驗證集共用同一個
transform:驗證集也被隨機翻轉,分數會忽高忽低,而且和上線時的真實分布不同。
- 以為「加了增強資料就變多」,於是把 epoch 數調少:每個 epoch 的筆數沒變,只是內容每次不同。
- 以為圖翻了標籤會自動跟著改:transform 只碰圖片。要改標籤得自己寫
target_transform 或自訂 Dataset,而且得知道「翻轉後該變成哪個字母」,非常麻煩,直接不要翻最單純。