§6
動手跑跑看:第 46~48 題接起來,真的訓練一次
把第 46、47 題的程式和本頁補出來的訓練、畫圖接起來,就是一支完整、可以直接跑的程式。下面這份在本機實際跑過(TensorFlow 2.20、Keras 3.13.1、CPU),輸出和圖都是那一次的結果。複製到 Google Colab 也能直接執行(建議開 GPU);第一次執行會下載約 170 MB 的 CIFAR-10。
import tensorflow as tf
from tensorflow.keras import datasets, layers, models
import matplotlib.pyplot as plt

tf.keras.utils.set_random_seed(42)        # 固定亂數,讓結果比較能重現

# ---- 第 46 題:載入與前處理 ----
(x_train, y_train), (x_test, y_test) = datasets.cifar10.load_data()
x_train, x_test = x_train / 255.0, x_test / 255.0
y_train = tf.keras.utils.to_categorical(y_train, 10)
y_test = tf.keras.utils.to_categorical(y_test, 10)

# ---- 第 47 題:建模型 ----
model = models.Sequential([
    layers.Input(shape=(32, 32, 3)),
    layers.Conv2D(32, kernel_size=(3,3), padding="same", activation="relu"),
    layers.BatchNormalization(),
    layers.Conv2D(32, (3,3), activation='relu', padding='same'),
    layers.BatchNormalization(),
    layers.MaxPooling2D((2,2)),
    layers.Dropout(0.25),

    layers.Conv2D(64, (3,3), activation='relu', padding='same'),
    layers.BatchNormalization(),
    layers.Conv2D(64, (3,3), activation='relu', padding='same'),
    layers.BatchNormalization(),
    layers.MaxPooling2D((2,2)),
    layers.Dropout(0.25),

    layers.Conv2D(128, (3,3), activation='relu', padding='same'),
    layers.BatchNormalization(),
    layers.Conv2D(128, (3,3), activation='relu', padding='same'),
    layers.BatchNormalization(),
    layers.MaxPooling2D((2,2)),
    layers.Dropout(0.25),

    layers.Flatten(),
    layers.Dense(256, activation='relu'),
    layers.BatchNormalization(),
    layers.Dropout(0.5),
    layers.Dense(10, activation='softmax')
])

# ---- 第 48 題:訓練+畫圖(考卷沒印,這裡補上) ----
model.compile(loss='categorical_crossentropy',
              optimizer='adam',
              metrics=['accuracy'])

history = model.fit(x_train, y_train,
                    epochs=10,
                    validation_data=(x_test, y_test),
                    verbose=2)                 # 每輪印一行

acc = history.history['accuracy']
val = history.history['val_accuracy']
print('鍵:', list(history.history.keys()))
print('索引 6(第 7 輪):訓練', round(acc[6], 4), '驗證', round(val[6], 4))
print('每輪差距(訓練 − 驗證):', [round(a - v, 3) for a, v in zip(acc, val)])

plt.plot(acc, 'bo-', label='Train Accuracy')
plt.plot(val, 'ro-', label='Validation Accuracy')
plt.title('Training and Validation Accuracy for CIFAR-10 with CNN')
plt.xlabel('Epochs')
plt.ylabel('Accuracy')
plt.legend()
plt.grid(True, linestyle='--')
plt.savefig('cifar10_curve.png', dpi=120)   # 要存檔,寫在 show 之前
plt.show()
實際跑出來的結果
Epoch 1/10
1563/1563 - 34s - 21ms/step - accuracy: 0.4850 - loss: 1.4934 - val_accuracy: 0.5888 - val_loss: 1.1906
Epoch 2/10
1563/1563 - 32s - 20ms/step - accuracy: 0.6605 - loss: 0.9694 - val_accuracy: 0.6586 - val_loss: 0.9676
Epoch 3/10
1563/1563 - 32s - 20ms/step - accuracy: 0.7147 - loss: 0.8212 - val_accuracy: 0.7328 - val_loss: 0.7728
Epoch 4/10
1563/1563 - 32s - 21ms/step - accuracy: 0.7463 - loss: 0.7296 - val_accuracy: 0.7255 - val_loss: 0.8106
Epoch 5/10
1563/1563 - 33s - 21ms/step - accuracy: 0.7743 - loss: 0.6533 - val_accuracy: 0.7293 - val_loss: 0.8236
Epoch 6/10
1563/1563 - 33s - 21ms/step - accuracy: 0.7957 - loss: 0.5909 - val_accuracy: 0.7799 - val_loss: 0.6552
Epoch 7/10
1563/1563 - 33s - 21ms/step - accuracy: 0.8134 - loss: 0.5394 - val_accuracy: 0.7911 - val_loss: 0.6178
Epoch 8/10
1563/1563 - 32s - 21ms/step - accuracy: 0.8286 - loss: 0.5024 - val_accuracy: 0.7976 - val_loss: 0.6141
Epoch 9/10
1563/1563 - 32s - 21ms/step - accuracy: 0.8411 - loss: 0.4638 - val_accuracy: 0.7909 - val_loss: 0.6434
Epoch 10/10
1563/1563 - 33s - 21ms/step - accuracy: 0.8488 - loss: 0.4307 - val_accuracy: 0.8330 - val_loss: 0.5135
鍵: ['accuracy', 'loss', 'val_accuracy', 'val_loss']
索引 6(第 7 輪):訓練 0.8134 驗證 0.7911
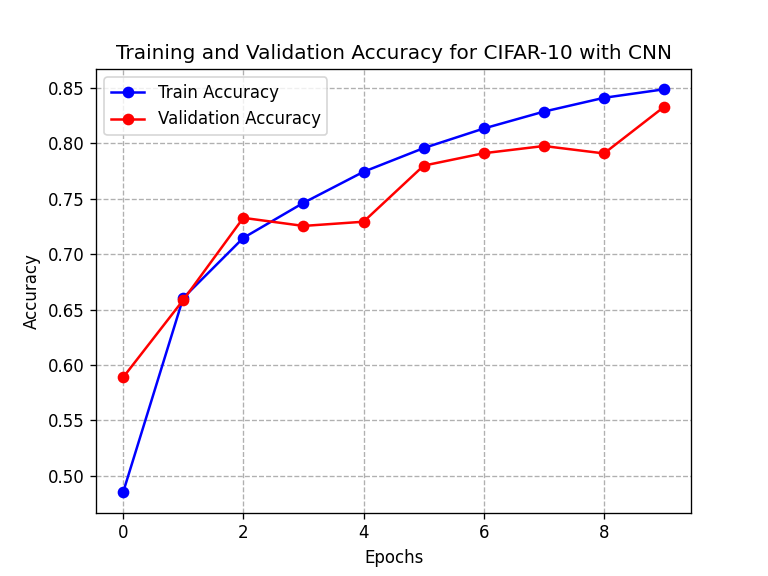
每輪差距(訓練 − 驗證): [-0.104, 0.002, -0.018, 0.021, 0.045, 0.016, 0.022, 0.031, 0.05, 0.016]
這次執行存下的 cifar10_curve.png(和考卷的圖同一種畫法)
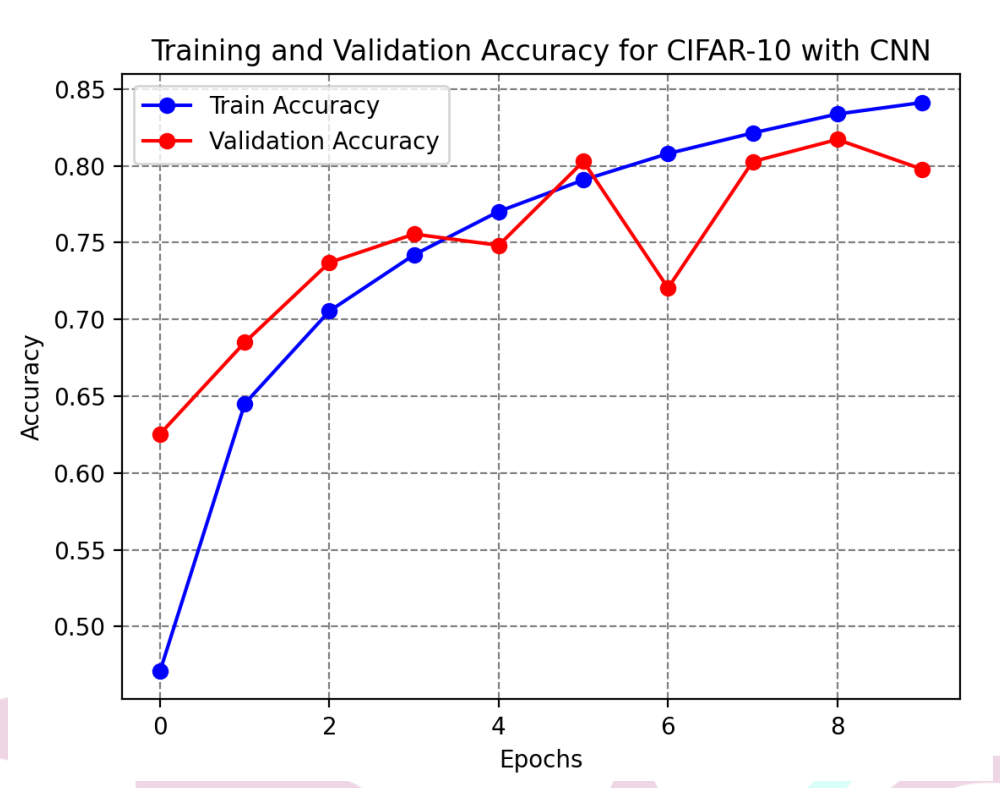
每一輪的那一行怎麼讀 :1563/1563 是這一輪跑完的步數(50,000 ÷ 32 進位);32s - 20ms/step 是這一輪花的時間和每一步的平均時間(本機 CPU);後面四個數字就是 history 裡 4 個 list 在這一輪新增的值。這次的曲線更像考卷 :驗證在橫軸 3、4 和 8 都掉了一下,最後一輪又跳到 0.833。單一輪的起伏很常見,要看整條趨勢。第 1 輪驗證比訓練高 0.104 :原因就是 §4 實測一,訓練分數是一路累積的平均,而且 Dropout 開著。和 §4「考題設定」那次用同一個亂數種子,數字還是不一樣 :TensorFlow 在 CPU 上的平行運算不保證每次結果完全相同。要完全重現,得另外呼叫 tf.config.experimental.enable_op_determinism()(會變慢)。plt.show() 會停住程式
加一個 EarlyStopping:驗證變差就自動停下
es = tf.keras.callbacks.EarlyStopping(monitor='val_loss',          # 盯著驗證 loss
                                      patience=3,                  # 連續 3 輪沒進步就停
                                      restore_best_weights=True)   # 權重退回最好的那一輪
history = model.fit(x_train, y_train,
                    epochs=50,                                     # 上限給大一點,交給它決定
                    validation_data=(x_test, y_test),
                    callbacks=[es])
EarlyStopping 和 History 一樣是 callback,每一輪結束時被 Keras 叫起來檢查一次。把 §4「拿掉正則化」那次真實的驗證 loss 一輪一輪交給 Keras 的 EarlyStopping 物件檢查(沒有重新訓練):它在橫軸 6 停下(stopped_epoch = 6),權重退回橫軸 3 (best_epoch = 3),正好是驗證 loss 最低的那一輪。那次訓練在橫軸 3 之後的 16 輪,驗證 loss 沒有一輪比橫軸 3 好;EarlyStopping 會省下最後 13 輪,留下最好的那一份權重。
新出現的語法 是什麼 白話 tf.keras.utils.set_random_seed(42)函式 一次固定 Python、NumPy、TensorFlow 的亂數種子 verbose=2fit 的參數 每一輪只印一行(不要進度條),適合存成文字記錄 zip(acc, val)內建函式 把兩個 list 一對一配對:(第 1 輪訓練, 第 1 輪驗證)、(第 2 輪…, …) [round(a - v, 3) for a, v in …]串列推導式 每一對相減、留 3 位小數,收集成新的 list plt.savefig('cifar10_curve.png', dpi=120)函式 把目前的圖存成檔案;dpi 是解析度。要寫在 show 之前 tf.keras.callbacks.EarlyStopping(...)類別 → 物件 照 EarlyStopping 設計圖做一個「提早停止」的 callback 物件 callbacks=[es]fit 的參數 一個 list,放所有要在訓練中插手的 callback 物件(History 會自動加,不用寫)