iPAS AI 奈米級拆解程式題解說・中級科目三 115-01
Question 40 · TensorFlow / Keras

用 Keras 疊一個手寫數字分類器:
softmax 和 categorical_crossentropy 為什麼是一對

這段程式只有 8 行,但每一行都藏著 Python 物件導向和深度學習的關鍵觀念。這頁會帶你一個字一個字看懂:哪個是類別、哪個是物件、點(.)後面的方法在做什麼,以及每個參數到底控制了什麼。

TensorFlow 2.xKeras SequentialDensecompile() softmaxOne-Hot零基礎可讀

讀完這頁,你會知道

  1. from … import … 在做什麼,Sequential、Dense 為什麼是「類別」
  2. 「類別 → 建立物件 → 用物件的方法」這條路線,在 Keras 裡長什麼樣子
  3. Dense(64, activation='relu', input_shape=(784,)) 裡每個參數的意思,以及第一層為什麼有 50,240 個參數
  4. 輸出層的激活函數和損失函數,要依「幾個類別」和「標籤長什麼樣子」來配對
§0

題目

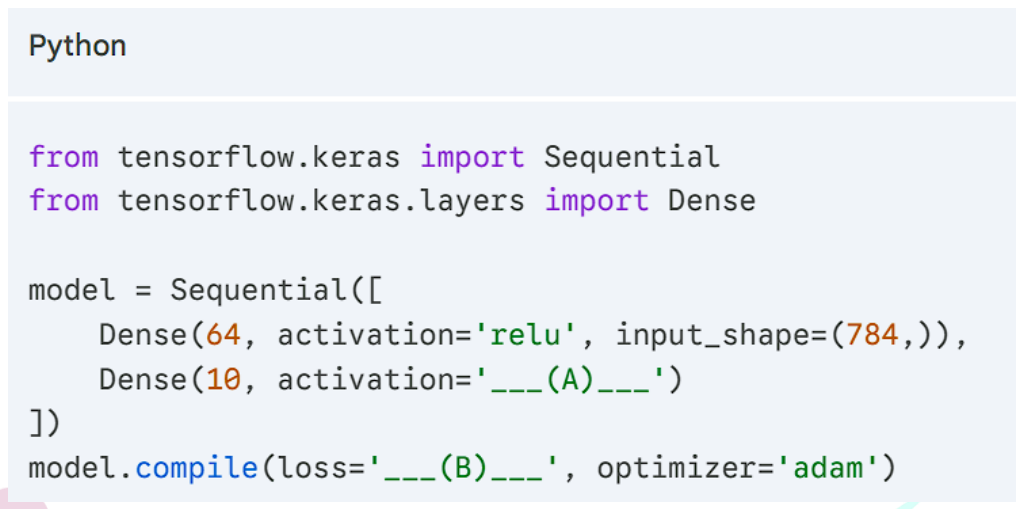
分析師準備建立一個能將手寫數字圖片(28x28 像素展平為 784 維度)分為 0~9 共 10 個類別的多層感知機(MLP),且標籤已轉為 One-Hot 編碼(One-Hot Encoding)。為符合 10 個類別的單標籤分類需求,下圖中的程式碼中 (A) 與 (B) 的函數應填入何者?
第 40 題原始程式碼截圖:Sequential 內含兩個 Dense 層,第二層 activation 為空格 A,compile 的 loss 為空格 B
原卷附圖(程式碼已在 §3 完整重打一份)

先憑直覺選一個,讀完再回來對照:

先抓題目的三個關鍵字

① 10 個類別:輸出層要有 10 個神經元。② 單標籤:一張圖只屬於一個數字,10 個機率應該加起來等於 1。③ 標籤已是 One-Hot:答案長得像 [0,0,0,0,0,0,0,1,0,0],不是單一個整數 7。這三個條件會決定 (A) 和 (B)。

§1

先補 Python 基本功:從 import 一路看到物件導向

如果你寫過 Python,可以跳到 §2。完全沒寫過也沒關係:這一節用三支動畫,把「程式執行時,電腦記憶體裡到底發生什麼事」畫給你看,每支動畫前後都有文字說明。

① import動畫 1
工具箱進記憶體
→
② 物件導向設計圖是什麼?
→
③ 類別・物件・方法動畫 2
珍奶店比喻
→
④ 參數與型別觀念 4~7
→
⑤ 記憶體實況動畫 3
8 行程式逐行

觀念 1|import:把整個工具箱載入記憶體,再貼一張名牌

你用 pip install tensorflow 裝好的東西,是放在硬碟上的一大包程式碼(上千個 .py 檔)。程式要用它,必須先把它載入到記憶體。import 就是做這件事的指令。

理解 import 之前,先建立兩個畫面,三支動畫都會用到:

記憶體=一大排置物櫃

每一格都有自己的地址(例如 0x1dd74782570)。程式做出來的每樣東西(物件),都住在某一格裡。

名字(變數)=一張名牌

程式裡寫的 tf、model,只是一張綁著線的名牌,線的另一端指向記憶體裡的某個物件。名牌不是物件本身。

看動畫 1 之前:這支要回答什麼

寫下 import tensorflow as tf 的那一刻,電腦裡多了什麼?tf.keras.Sequential 和第 40 題寫的 from tensorflow.keras import Sequential 差在哪?看的時候盯著三樣東西:左邊的紅色名牌、名牌拉出去的箭頭、右邊記憶體裡的灰色工具箱。

動畫 1import 在記憶體裡做了什麼2 分 16 秒・有旁白,也有字幕

畫面上的位址、數量和秒數,都取自同一次真實執行(Python 3.13、TensorFlow 2.20、Keras 3.13)。每台電腦、每次執行的位址都不一樣,這是正常的。

動畫 1 的文字版:import 的每一步

第一次執行 import tensorflow as tf 時,Python 依序做四件事

  1. 查「已載入清單」:Python 有一本清單叫 sys.modules,記錄已經載入過的套件。第一次執行時,清單裡還沒有 tensorflow。
  2. 執行 tensorflow 的程式碼:把硬碟上 tensorflow 資料夾裡的程式碼跑一遍,在記憶體做出一個「模組物件」。這一步最花時間,這次實測 7 秒。
  3. 登記到清單:把這個模組物件記進 sys.modules。
  4. 綁名牌:在你的程式裡建立名字 tf,指向這個模組物件。注意:不會有 tensorflow 這個名字,名牌上只寫 tf。

第二次再執行同一行,第 1 步就會在清單裡找到它,直接拿同一個模組物件來綁名牌,不會再做一個。實測第二次只要 0.0000 秒,而且是同一個位址。

模組物件就像一個「裝好的工具箱」

tensorflow 本身不是設計圖。它是照 Python 內建的 module 類別做出來的一個物件,裡面裝滿了 TensorFlow 團隊寫好的東西。工具箱裡的東西分成四種(實際數出來的數量):

種類是什麼用法tftf.keraskeras.layers例子
子工具箱(模組)箱中箱,裡面再放東西用點往裡面走:tf.keras50280keras、data、layers
設計圖(類別)照它可以做出物件加括號建立物件:Dense(64)3220166Sequential、Dense
機器(函式)丟材料進去,吐成品出來加括號呼叫:tf.constant([1,2])199411constant()、to_categorical()
現成物件(實例)import 時就做好的成品直接拿來用2600tf.float32

所以第 40 題要用的 Sequential,是放在 tensorflow 工具箱 → keras 子工具箱裡的一張設計圖。

三種寫法,在記憶體裡的差別

寫法記憶體裡多了什麼名牌之後怎麼用 Sequential
import tensorflowtensorflow → 工具箱tensorflow.keras.Sequential(走三步)
import tensorflow as tftf → 同一個工具箱(沒有 tensorflow)tf.keras.Sequential(走三步)
from tensorflow.keras import SequentialSequential → 直接指到那張設計圖(沒有 tf 也沒有 tensorflow)Sequential(捷徑,一步到位)

三種寫法都會載入整個 tensorflow 工具箱,差別只在名牌綁在哪裡。點(.)的意思是「打開它,往裡面找」:tf.keras.Sequential 就是「名牌 tf 指的工具箱 → 打開 keras → 拿出 Sequential」。實測 Sequential is tf.keras.Sequential 的結果是 True:兩條路找到的是同一個東西(同一個位址),不是複製品。

最重要的一句:每個實例,都有做出它的設計圖

記憶體裡的東西,不管怎麼來的,都可以用 type() 問它「你是哪張設計圖做的」(以下都實際執行過):

東西怎麼來的type() 的答案(它的設計圖)
64、'relu'、(784,)直接寫出來,Python 自動做好int、str、tuple
Dense(64)設計圖加括號Dense
to_categorical([1], 3)機器(函式)在裡面替你做ndarray
tf.float32import 時就做好放在箱子裡DType
tf(工具箱本身)import 時 Python 做的module

實例有三個來源:你自己拿設計圖加括號、呼叫函式由它在裡面替你做、import 時就做好。但追到最後,每一個實例背後都有一張設計圖(類別)。

深入一點(可以先跳過)

① 設計圖本身也是物件:type(Sequential) 的答案是 type,也就是「設計圖的設計圖」。在 Python 裡一切都是物件。② TensorFlow 2.16 之後,tf.keras 其實是一個「延遲載入」的模組物件(KerasLazyLoader):第一次用到 tf.keras. 什麼東西時,才真的把 Keras 載入。動畫裡為了好懂,畫成一個普通的子工具箱。

看完動畫 1,你應該能回答:import tensorflow as tf 之後,可以寫 tensorflow.constant(1) 嗎?
不行。名牌只有 tf,沒有 tensorflow。實測錯誤訊息:NameError: name 'tensorflow' is not defined。
同一支程式裡 import 兩次,記憶體裡會有兩個 tensorflow 工具箱嗎?
不會。第二次會在「已載入清單」sys.modules 裡找到它,直接拿同一個(同一個位址),所以幾乎不花時間。
from tensorflow.keras import Sequential 只會載入 Sequential 嗎?
不是。整個 tensorflow 工具箱都會載入,只是名牌直接綁到裡面的 Sequential 設計圖上,所以之後不用寫 tf.keras.。
tensorflow 是設計圖(類別)嗎?
不是。tensorflow 是一個模組物件(裝好的工具箱),它的設計圖是 Python 內建的 module。箱子裡的 Sequential、Dense 才是設計圖。

什麼是物件導向?為什麼要先有設計圖?

動畫 1 最後停在一個問題:工具箱裡的 Sequential 是一張設計圖。設計圖是什麼?要怎麼用?

物件導向(Object-Oriented Programming,OOP)是一種寫程式的方式:先寫設計圖(類別),再照設計圖做出一個一個物件來用。它有兩個核心想法:

  1. 把「資料」和「會做的動作」包在一起。一個模型有自己的資料(有哪些層、權重是多少、用什麼優化器),也有會做的動作(compile、fit、predict)。物件導向把它們全部包進同一個物件裡,你手上只要拿著 model 一個東西就好。
  2. 一張設計圖,可以做出很多個獨立的物件。用同一張 Sequential 設計圖,可以做出 model_a、model_b,各自有不同的層、各自訓練,互不影響。

Keras 為什麼這樣設計?因為 Keras 的作者已經把「一個模型該有哪些資料、會做哪些事」寫成 Sequential 這張設計圖,裡面是上千行的程式。你不用自己寫,只要照設計圖做一個模型,再叫它做事。第 40 題的 8 行程式,做的就是這件事。

名詞白話第 40 題裡的例子
類別 class設計圖:規定做出來的東西有什麼資料、會做什麼Sequential、Dense
物件 object/實例 instance照設計圖做出來的那一個東西model、兩個 Dense(…) 層
屬性 attribute物件身上的資料(沒有括號)model.layers、model.optimizer
方法 method物件會做的動作(有括號)model.compile(…)、model.fit(…)
看動畫 2 之前:這支要回答什麼

上面四個名詞,用珍奶店變成畫面:配方卡是類別,照配方做出來的每一杯是物件,每杯的甜度、冰塊是屬性,封膜、搖一搖是方法。看的時候注意三件事:配方卡只有一張,杯子有好幾杯;每一杯的資料各自獨立;杯A.封膜() 只作用在點前面的那一杯。最後動畫會把每個比喻對回第 40 題的程式。

動畫 2一張配方卡,做出很多杯:類別、物件、方法2 分 9 秒・有旁白,也有字幕

動畫裡的「點餐程式」杯A = 珍奶(甜度="半糖", 冰塊="少冰") 是比喻用的假想程式,真正能執行的是第 40 題那 8 行。

看完動畫 2,你應該能回答:配方卡能喝嗎?那 Sequential 本身能拿來訓練嗎?
都不行。配方卡(類別)只寫規則;要先照它做出一杯(物件)。同樣地,要先 model = Sequential([...]) 做出模型物件,才能 model.compile()、model.fit()。
杯A.封膜() 會讓杯B 也封膜嗎?
不會。動作寫在配方卡上,但只作用在「點前面的那個物件」。換成程式:model_a.compile(…) 只會設定 model_a。
第 40 題的 8 行裡,誰是類別、誰是物件、誰是方法?
類別:Sequential、Dense。物件:model,以及兩個 Dense(…) 做出來的層。方法:compile。

觀念 2|類別(class)與物件(object):配方卡和照著做出來的那一杯

類別是一張「配方卡」或「設計圖」,描述某種東西該有哪些資料、會做哪些動作。物件是照配方實際做出來的那一個東西,也叫「實例(instance)」。

比喻(和動畫 2 同一套):珍奶的配方卡是類別,照配方做出來的每一杯是物件。同一張配方卡可以做出很多杯,每杯的甜度、冰塊各自獨立;而配方卡本身不能喝。

在 Python 裡,類別名稱後面加上小括號 ( ),就是「照設計圖做一個出來」:

Sequential          # 這只是設計圖(類別本身)
Sequential([...])   # 加上括號 = 照設計圖做出一個模型物件
model = Sequential([...])   # 做出來之後,貼一張名牌叫 model
怎麼一眼看出誰是類別?

Python 社群的命名慣例(PEP 8):類別用大寫開頭的駝峰式(Sequential、Dense、KNeighborsClassifier),函式、方法、變數用小寫(compile、model)。這不是語法規定,但幾乎所有知名套件都遵守,讀程式時非常好用。

觀念 3|方法(method)與屬性(attribute):物件會做的事、物件身上的資料

物件做出來以後,可以用「物件.名稱」取用它身上的東西:

方法:有括號,叫物件「做事」

model.compile(...):叫 model 設定訓練方式
model.summary():叫 model 印出結構表
model.fit(...):叫 model 開始訓練

屬性:沒括號,讀物件「身上的資料」

model.layers:這個模型有哪些層
model.optimizer:目前設定的優化器
model.weights:所有權重

方法其實就是「綁在物件身上的函式」。差別在於:方法會自動知道「是哪個物件在做事」,所以 model.compile() 改的是 model 自己的設定,不會影響別的模型。

觀念 4|呼叫時傳入參數:位置參數 vs 關鍵字參數

呼叫類別或函式時,括號裡放的東西叫參數(嚴格說法是「引數 argument」,日常混用沒關係)。有兩種給法:

Dense(64, activation='relu')
#     ↑   ↑
#     │   └─ 關鍵字參數:用「名字=值」指定,順序可以換
#     └───── 位置參數:照位置對應,Dense 的第 1 個位置是 units(神經元數量)
  • 位置參數一定要寫在關鍵字參數前面,否則 Python 會報 SyntaxError。
  • 沒寫到的參數會用「預設值」。例如 Dense 的 use_bias 沒寫,就自動是 True。讀程式時要記得:沒寫不代表沒有。
  • Dense(64) 和 Dense(units=64) 完全一樣。

觀念 5|會出現的資料型別:字串、整數、list、tuple

長相型別白話本題出現在
'relu'字串 str引號包起來的文字。單引號、雙引號都可以激活函數、loss、optimizer 的名字
64整數 int沒有小數點的數字神經元數量
[a, b]串列 list方括號,有順序、可以修改的清單,裡面可以裝任何東西,包括物件裝兩個 Dense 層
(784,)元組 tuple圓括號,有順序但不能修改的組合輸入形狀
最容易看漏的逗號

(784) 只是數字 784 外面多套一層括號,Python 會當成整數。(784,) 多了一個逗號,才是「只有一個元素的 tuple」。Keras 的 shape 一律要 tuple,所以那個逗號不能省。

觀念 6|括號沒關起來,就可以換行

Python 通常一行就是一句。但只要 (、[、{ 還沒關起來,換行會被當成同一句的延續。所以 §3 的第 4~7 行,其實是同一句話:「model = Sequential([第一層, 第二層])」,只是為了好讀才拆成四行。

觀念 7|物件也可以「像函式一樣呼叫」:model(x) 和 layer(x)

有些物件做出來之後,可以直接在名字後面加括號、把資料丟進去,就像呼叫函式一樣。這種物件叫做可呼叫物件(callable)。Python 的做法是:類別裡如果寫了一個叫 __call__ 的特殊方法,物件後面加括號時就會執行它。

Keras 的層和模型都是可呼叫物件(以下在 Keras 3 實測,x 是 3 筆、每筆 784 個數字):

model.layers[0](x)    # 只跑第一層       → 形狀 (3, 64)
model(x)              # 整個模型跑一次   → 形狀 (3, 10),型別是 TensorFlow 張量
model.predict(x)      # 方法:分批跑完   → 形狀 (3, 10),型別是 NumPy 陣列
寫法是什麼回傳什麼時候用
model(x)呼叫物件(背後是 __call__)TensorFlow 張量小量資料、自己寫訓練迴圈時
model.predict(x)呼叫方法NumPy 陣列大量資料:它會自動切成小批次(預設每批 32 筆)跑完再合併

所以「物件後面直接加括號」和「物件.方法()」是兩種不同的用法,但背後都是在執行類別裡寫好的方法。第 41 題的 transform(img)、第 50 題的 model(images) 都是同一個觀念。

把觀念串起來:本題的「類別 → 物件 → 方法」路線

① 類別(設計圖)Sequential、Dense
住在 tensorflow 工具箱裡,由 import 綁上名牌;本身還不是模型
→
② 建立物件(照配方做一杯)Dense(64, …) 做出一個層物件
model = Sequential([…]) 做出模型物件,取名 model
→
③ 呼叫方法(叫它做事)model.compile(…) 設定訓練方式
之後還有 model.fit()、model.predict()

把三件事合起來:照設計圖建立物件時,記憶體裡發生什麼

動畫 1 讓你看到 import 時記憶體的樣子,動畫 2 讓你懂「設計圖、物件、方法」是什麼。動畫 3 把兩者合起來:第 40 題的 8 行一行一行執行,畫出記憶體裡每一刻多了什麼。

看動畫 3 之前:這支要回答什麼

帶著三個問題看:① Dense(64, …) 剛做好的時候,有沒有權重?② model 這張名牌是什麼時候才綁上去的?③ model 身上明明沒有 compile,Python 去哪裡找到它?

看的時候抓四種樣子:黃色格子是類別(設計圖)、綠色格子是物件、紅色名牌是名字、虛線框是剛開好、還沒填資料的新物件。

動畫 3打開記憶體:Python 執行第 40 題時發生了什麼3 分 3 秒・有旁白,也有字幕

這支動畫照 Keras 3 實際的行為畫,位址和動畫 1 取自同一次執行。為了畫面清楚,有兩處省略:tensorflow 工具箱裡其他 300 多樣東西不畫;Keras 會在模型內部自動加一個 InputLayer,也不畫。

看完動畫 3:Dense(64, …) 剛做好的時候,有沒有權重?
沒有(built = False)。權重是在 Sequential(…) 建立模型時才做的:第一層寫了 input_shape=(784,),Keras 知道輸入大小,才替兩層建好 784×64 和 64×10 的權重。
第 4~7 行是一整句,Python 先做哪一部分?model 名牌什麼時候綁上?
先做括號最裡面的兩個 Dense(…),再做方括號清單,再呼叫 Sequential(…) 建立模型物件。整句右邊都算完,最後才執行等號,把 model 名牌綁上去。
model.layers[0] 和第 5 行做出來的 Dense 是同一個物件嗎?
是。layers 存的是指向那兩個 Dense 物件的箭頭,不是複製品。實測 model.layers[0] is 第一個 Dense 物件的結果是 True。
model 身上沒有 compile,Python 去哪裡找到它?
沿著 __class__ 回到 Sequential 類別,再一路往上層類別找(Sequential → Model → TensorFlowTrainer → Trainer),在 Trainer 找到。這叫「繼承」。呼叫時,Python 自動把 model 當成 self 傳進去。
為什麼 model = model.compile(…) 會壞掉?
compile 改的是 model 自己,回傳 None。等號會把 model 名牌改綁到 None,做好的模型沒有名牌指著,接著 model.fit() 就出現 AttributeError: 'NoneType' object has no attribute 'fit'。
§2

認識這次登場的框架:TensorFlow 與 Keras

TensorFlow
Google 開發的深度學習框架(2015 年開源)

負責「底層苦工」:大量矩陣運算(張量 tensor 的運算)、自動微分自動算出「每個權重要往哪個方向調、調多少」的梯度,不用自己推公式。、用 GPU 加速,以及把模型部署到伺服器或手機。

比喻:汽車的引擎和底盤。力氣很大,但直接操作很複雜。

Keras
高階深度學習 API,由 François Chollet 開發

把 TensorFlow 的複雜操作包成簡單的積木:「疊層 → 設定 → 訓練 → 預測」。TensorFlow 2.0 起,Keras 成為官方高階介面,所以可以用 tensorflow.keras 取用。

比喻:方向盤和儀表板。你只要轉方向盤,不用自己控制每個汽缸。

版本小知識:Keras 3

2023 年起的 Keras 3 可以切換底層引擎(TensorFlow、JAX、PyTorch 擇一),TensorFlow 2.16 之後的 tensorflow.keras 指向的就是 Keras 3。考題的寫法在新舊版都能執行,只有 input_shape 在新版會跳一個「建議改寫法」的警告,§3 第 5 行會說明。

Keras 的「貨架配置圖」:本題用到哪幾格

tensorflow └─ keras ├─ Sequential ← L1 拿的:一層接一層往下疊的「模型類別」 ├─ Model (可以分岔、合併的彈性模型類別) ├─ Input (宣告輸入形狀的新式寫法) ├─ layers │ ├─ Dense ← L2 拿的:全連接層類別 │ └─ Conv2D、MaxPooling2D、Dropout、Flatten …(第 47 題會用到) ├─ activations 'relu'、'softmax' 這些字串背後的函式 ├─ losses 'categorical_crossentropy' 背後的損失函數 ├─ optimizers 'adam' 背後的 Adam 類別 ├─ datasets mnist、cifar10 等練習資料集(第 46 題會用到) └─ utils to_categorical(轉 One-Hot)等小工具

Keras 做模型的固定四步驟

① 建Sequential + Dense
→
② 編model.compile()
→
③ 訓model.fit()
→
④ 用evaluate() / predict()

這題的程式碼只寫到第 ② 步。§6 會補完 ③ ④,讓你可以真的跑起來。

§3

逐行解剖

左邊是完整程式(點任一行可以跳到解說),右邊往下捲時,左邊會自動標出目前講到哪一行。手機上會改成上下排列。

q40.py8 行

把整個 tensorflow 工具箱載入記憶體(已經載入過就沿用),再做一張名牌 Sequential,直接綁到工具箱裡 keras 子工具箱的那張 Sequential(序列模型)設計圖上。

逐字拆解

from
關鍵字「從哪裡拿」。後面接要去的地方。
tensorflow
套件要先用 pip install tensorflow 安裝過才有。載入後在記憶體裡是一個模組物件(工具箱)。
.keras
子模組點 =「打開它,往裡面找」。tensorflow 工具箱裡的 keras 子工具箱。
import
關鍵字「把後面那個東西綁上名牌」:這裡是在你的程式裡建立名字 Sequential。
Sequential
類別大寫開頭,是一張設計圖。這一行只是綁上名牌,還沒做出任何模型。

這一行執行時發生什麼事

  1. 查「已載入清單」sys.modules:還沒有 tensorflow,就執行它的程式碼,在記憶體做出 tensorflow 工具箱(模組物件)並登記。這一步可能要好幾秒(實測 7 秒),還會印出一堆 log 訊息,這是正常的。已經載入過就直接沿用。
  2. 打開工具箱裡的 keras 子工具箱,找到 Sequential 這張設計圖。
  3. 在你的程式裡建立名字 Sequential,直接指向那張設計圖。
執行後,你的程式裡多了一張名牌: Sequential → tensorflow 工具箱 → keras 裡的 Sequential 設計圖(類別) 不會有 tf,也不會有 tensorflow 這兩個名牌;記憶體裡也還沒有任何模型。 實測 Sequential is tf.keras.Sequential → True(同一個東西)

Sequential 是什麼樣的模型?

Sequential 的意思是「依序」:資料從第一層進去,一層接一層直線往下走,沒有分岔、沒有跳接。像一條生產線,每一站把上一站的半成品加工後交給下一站。大部分入門模型(包括本題和第 47 題的 CNN)都用它。

等價寫法(考試也可能出現)

from tensorflow.keras.models import Sequential   # 從 models 子模組拿,結果相同
import tensorflow as tf
model = tf.keras.Sequential([...])                # 不用 from,直接寫全名
from keras import Sequential                      # Keras 3 單獨安裝時的寫法

新手常踩的坑

  • 寫成 sequential(小寫 s):Python 分大小寫。實測錯誤訊息:ImportError: cannot import name 'sequential' from 'tensorflow.keras'。
  • 寫成 import tensorflow.keras.Sequential:import 後面只能接「模組」,Sequential 是類別。實測:ModuleNotFoundError: No module named 'tensorflow.keras.Sequential'。要改用 from … import。

從 Keras 的 layers(各種神經網路層)貨架,拿出 Dense(全連接層)這張設計圖。

逐字拆解

tensorflow.keras.layers
模組專門放「層」的地方:Dense、Conv2D、Dropout… 都在這。
Dense
類別全連接層的設計圖。等一下會用它做出兩個層物件。

Dense(全連接層)到底在算什麼?

「全連接」的意思是:這一層的每個神經元,都會看過上一層的全部輸出。比喻:一場選秀有 64 位評審(神經元),每位評審都要看完參賽者的全部 784 個特徵(像素),各自依照自己的評分標準(權重)打出一個分數。

每個神經元做的事只有三步:

  1. 把每個輸入乘上自己的權重 w,全部加起來
  2. 再加上一個偏差值 b(bias,像評審的基本分)
  3. 丟進激活函數(activation)過濾一下,得到輸出
數學寫法: 輸出 = activation( 輸入 · W + b ) └ W 叫 kernel(權重矩陣),b 叫 bias(偏差向量),都是訓練時要學的數字

新手常踩的坑

  • 寫成 tensorflow.keras.layer(少一個 s):模組名稱是複數 layers。實測:ModuleNotFoundError: No module named 'tensorflow.keras.layer'。
  • 以為 import 進來就有層了:這行只是拿到設計圖,第 5、6 行加上括號才真正做出層物件。

照 Sequential 設計圖做出一個模型物件,模型內容是清單裡的兩層,由上往下依序疊起來,做好後取名叫 model。

逐字拆解

model
變數自己取的名字,叫 net、clf 都可以。它就像貼在物件上的名牌。
=
指派不是數學的「等於」。意思是「把右邊算出來的東西,貼上左邊的名牌」。
Sequential(
類別+括號類別加括號 = 建立物件。Python 會在背後執行這個類別的初始化程式(__init__),把一個全新的模型交給你。
[ … ]
list把兩個層物件裝成一份有順序的清單,當成 Sequential 的第一個參數。清單的順序就是資料流動的順序。
])
收尾先關 list 的 ],再關呼叫的 )。括號一關,這句話(第 4~7 行)才結束。

Sequential 的參數

參數本題給的值預設值意思
layers兩個 Dense 組成的 listNone要依序疊起來的層。不給也行,之後用 model.add() 一層一層加
trainable(沒寫)True整個模型的權重能不能被訓練
name(沒寫)自動取名 sequential模型的名字,summary() 會印出來

執行完之後,model 身上有什麼

model → 一個 Sequential 物件(模型本體) model.layers → [Dense 物件(64), Dense 物件(10)] ← 屬性,沒有括號 因為第一層有給 input_shape,Keras 已經知道輸入大小,權重矩陣這時就建好了, 所以馬上可以呼叫 model.summary() 看結構。

動手拆開物件看看(Keras 3 實測)

物件做好後,可以用屬性和方法一層一層「打開」它。注意哪些有括號(方法)、哪些沒有(屬性):

model.layers                  # [<Dense name=dense, built=True>, <Dense name=dense_1, built=True>]
model.layers[0]               # 取出第一個層物件(list 用 [0] 取第一個)
model.layers[0].kernel.shape  # (784, 64)  ← 第一層的權重矩陣:屬性的屬性
model.layers[0].bias.shape    # (64,)      ← 第一層的偏差
model.get_weights()           # 方法:回傳 4 個 NumPy 陣列 (784,64)、(64,)、(64,10)、(10,)
model.count_params()          # 方法:50890

model.layers[0].kernel.shape 可以從左讀到右:「model 的 layers 清單的第 0 個(一個 Dense 物件)的 kernel(權重,一個變數物件)的 shape(形狀)」。每個點都往物件裡面走一層。

這個物件會做哪些事?(Sequential 常用方法)

方法做什麼什麼時候用
model.summary()印出每層的輸出形狀和參數數量建完模型先檢查
model.compile(...)設定 loss、optimizer、metrics訓練前一定要做(第 8 行)
model.fit(x, y, ...)開始訓練,回傳訓練紀錄 History 物件compile 之後
model.evaluate(x, y)在測試資料上算 loss 和指標訓練完評估
model.predict(x)輸入新資料,輸出預測(本題是 10 個機率)真正拿來用
model.add(layer)在最後面再疊一層一層一層建模型時
model.save('m.keras')把模型存成檔案訓練好要保存

另一種寫法:先做空模型,再用 add 方法加層

model = Sequential()                       # 先做出一個「空的」模型物件
model.add(Dense(64, activation='relu', input_shape=(784,)))   # 呼叫 add 方法加第一層
model.add(Dense(10, activation='softmax'))                     # 再加第二層

結果和考題寫法一模一樣。這個寫法更能看出物件導向的味道:先有物件,再呼叫物件的方法改變它的內容。

做一個有 64 個神經元的全連接層,每個神經元算完後用 ReLU 過濾,並告訴模型每筆輸入是 784 個數字。

逐字拆解

Dense(
類別+括號建立一個 Dense 層物件。這個物件沒有取名字,直接放進 list 裡交給 Sequential 保管。
64
位置參數對應第 1 個參數 units:這層有 64 個神經元,所以會輸出 64 個數字。
activation='relu'
關鍵字參數用字串指定激活函數。Keras 會在內部把 'relu' 換成真正的 ReLU 函式。
input_shape=(784,)
關鍵字參數每一筆輸入的形狀:784 個數字排成一列。只有第一層需要寫,後面的層會自動推算。
),
收尾關掉 Dense 的括號;逗號用來分隔 list 裡的兩個元素。

參數一個一個講清楚

① units = 64|為什麼是 64?
這是超參數由人決定、不是訓練學出來的設定值,例如神經元數量、學習率、epoch 數。,沒有標準答案。神經元越多,模型能記的規律越多,但也越容易過擬合、越慢。32、64、128、256 是常見選擇。

② activation = 'relu'|ReLU 在做什麼?
ReLU(x) = max(0, x):負數變 0,正數照原樣。例如 [-2.1, 0.5, 3.0] → [0, 0.5, 3.0]。隱藏層幾乎都用它,因為:

  • 它讓網路變成「非線性」,才能學到彎曲的規律(只有線性的話,疊再多層都等於一層)
  • 計算非常快,只要比大小
  • 正數區的斜率固定是 1,比 sigmoid 更不容易梯度消失反向傳播時梯度一層層變小,傳到前面幾層幾乎是 0,前面的層就學不動。

③ input_shape = (784,)|784 從哪來?
一張手寫數字是 28 × 28 = 784 個像素。MLP 只能吃「一整排數字」,所以要先把 28×28 的方格展平成 784 個數字排成一列。注意 shape 裡不包含資料筆數:你一次餵 32 張或 1000 張都可以,Keras 會用 None 代表「筆數未定」。

Dense 完整參數表(沒寫的都用預設值)

參數本題預設值白話
units64(必填)神經元數量 = 這層輸出幾個數字
activation'relu'None激活函數。None 代表不過濾,原樣輸出(線性)
use_bias—True要不要加偏差 b
kernel_initializer—'glorot_uniform'權重一開始的亂數怎麼抽。Glorot 會依輸入、輸出數量調整亂數範圍,避免一開始就太大或太小(本層的範圍下面有算)
bias_initializer—'zeros'偏差一開始都是 0
kernel_regularizer—None對權重加 L1/L2 懲罰,用來抑制過擬合
bias_regularizer、activity_regularizer—None對偏差、對輸出加懲罰
kernel_constraint、bias_constraint—None限制權重的範圍(例如最大範數)
input_shape(784,)—舊式寫法:放在第一層告訴模型輸入形狀

參數數量怎麼算:50,240

權重 W:784 個輸入 × 64 個神經元 = 50,176 偏差 b:每個神經元 1 個 = 64 合計 = 50,240 ← model.summary() 第一列印出的就是這個數字
形狀變化: 輸入 (筆數, 784) · W (784, 64) + b (64,) → 輸出 (筆數, 64)

剛建好時,50,240 個參數是什麼數字?

還沒訓練,權重就已經有值了,是照 glorot_uniform 抽的亂數:在 ±√(6 ÷ (輸入數 + 輸出數)) 之間平均抽。

本層範圍 = ±√(6 ÷ (784 + 64)) = ±√0.00708 ≈ ±0.0841 實測 model.layers[0].kernel 的最小值 −0.08411、最大值 0.08411(剛好落在範圍內) 偏差 bias:預設 'zeros',64 個全是 0.0

為什麼不全部設成 0?如果每個神經元的權重都一樣,它們算出來的東西就一模一樣,更新時也一模一樣,64 個神經元等於只有 1 個。用亂數讓每個神經元從不同起點出發,才學得到不同的特徵。

新版 Keras 會跳警告,但不影響答案

在 Keras 3 執行這行,會看到:Do not pass an `input_shape`/`input_dim` argument to a layer…。意思是新版建議把輸入形狀獨立成一個 Input:

from tensorflow.keras import Input
model = Sequential([
    Input(shape=(784,)),               # 新式:先宣告輸入
    Dense(64, activation='relu'),      # 第一層就不用再寫 input_shape
    Dense(10, activation='softmax')
])

這只是警告(warning),不是錯誤(error),模型照樣建得起來。

新手常踩的坑

  • input_shape=(784) 少了逗號:那只是整數 784,不是 tuple。實測錯誤訊息:ValueError: Cannot convert '784' to a shape.
  • 寫成 Dense(activation='relu', 64):關鍵字參數放在位置參數前面。實測:SyntaxError: positional argument follows keyword argument,程式連開始執行都不會。
  • input_shape=(28, 28):Dense 不會自動展平。2D 圖片要先 reshape 成 784,或在最前面加一層 Flatten()。
  • 以為 input_shape 要寫資料筆數,例如 (60000, 784):不用,筆數不寫。

輸出層有 10 個神經元,剛好對應 0~9 十個數字。空格 (A) 要填一個能把 10 個分數變成「加起來等於 1 的機率」的函數。

逐字拆解

Dense(10,
類別+位置參數第二個層物件,units = 10。輸出層的神經元數一定等於類別數。
activation='___(A)___'
關鍵字參數空格就是考點:輸出層要用哪個激活函數。
)
收尾這是 list 的最後一個元素,所以後面沒有逗號(加了也不會錯)。

這層沒寫 input_shape,因為 Keras 會自動接上一層:上一層輸出 64 個數字,所以這層每個神經元有 64 個輸入。

參數:64 × 10 + 10 = 650 形狀:(筆數, 64) → (筆數, 10)

沒加激活函數之前:10 個 logits

Dense 先算出 10 個任意大小的分數,叫做 logits,例如 [1.2, -0.3, 0.8, …, 3.5, …]。它們可以是負數、可以很大,還不是機率。激活函數的工作,就是把它們轉成我們要的樣子。

(A) 填 softmax:把 10 個分數變成機率分布

softmax(zᵢ) = e^zᵢ ÷ (e^z₁ + e^z₂ + … + e^z₁₀) 小例子(3 類): z = [2.0, 1.0, 0.1] e^2.0 = 7.389 e^1.0 = 2.718 e^0.1 = 1.105 總和 = 11.212 → [0.659, 0.242, 0.099] 加起來 = 1.000 ✓

softmax 有三個特性,剛好符合題目要的「單標籤 10 類」:

  1. 每個值都在 0~1 之間(e 的次方一定是正數)
  2. 全部加起來剛好等於 1,所以可以讀成「是 0 的機率、是 1 的機率…」
  3. 分數越高的類別,機率被放大得越多,互相競爭。一個類別變高,其他的一定變低,正好表達「只會是其中一個」

四個選項的激活函數比一比

函數輸出範圍10 個加起來 = 1?適合的輸出層
softmax0~1✓ 一定等於 1多類別、單標籤(本題)
sigmoid0~1✗ 每個各算各的二元分類,或多標籤(一張圖可同時屬於多類)
relu0~∞✗ 還可能大於 1隱藏層;迴歸要輸出非負數時
tanh-1~1✗ 還有負數隱藏層(RNN 常見),不當分類輸出

到 §4 的互動實驗把四個函數切換看看,差異會非常明顯。

新手常踩的坑

  • Dense(1, activation='softmax'):只有一個數字的 softmax 永遠輸出 1.0(實測 3 筆隨機輸入都輸出 [1. 1. 1.]),模型什麼都學不到。
  • 輸出層 units 寫成 784 或 64:輸出層的數量要等於類別數 10,跟輸入大小無關。

訓練前的設定:告訴 model 用什麼方式計算「錯了多少」(loss),以及用什麼方法修正權重(optimizer)。

逐字拆解

model
物件第 4 行做出來的模型物件。
.compile
方法點 = 「的」。「model 的 compile 功能」。compile 是 Sequential 類別裡寫好的方法,每個模型物件都有。
(
呼叫方法後面加括號 = 叫它現在執行。
loss='___(B)___'
關鍵字參數空格 (B):損失函數的名字。
optimizer='adam'
關鍵字參數用字串指定優化器,Keras 會自動建立一個 Adam 物件。
物件導向重點:compile 是「改物件自己」,不會回傳新模型

compile 執行完回傳的是 None(什麼都沒有),它改的是 model 內部的設定。所以:

model.compile(...)            # ✓ 正確:直接呼叫
model = model.compile(...)    # ✗ 錯誤:model 會變成 None,之後 model.fit() 直接報錯

這是很多初學者第一次寫 Keras 就會踩的坑。實測錯誤訊息:AttributeError: 'NoneType' object has no attribute 'fit'。

compile 之後,model 身上多了什麼(Keras 3 實測)

model.optimizer → <keras.src.optimizers.adam.Adam object …> ← 字串 'adam' 被換成了一個 Adam 物件 model.optimizer.learning_rate → 0.001 ← 那個物件身上的屬性 model.loss → 'categorical_crossentropy' compile 本身回傳 None

這就是「呼叫方法 → 改變物件內部狀態」:compile 之前 model 沒有優化器,compile 之後多了一個 Adam 物件掛在 model.optimizer 上,等 fit() 時拿來用。

compile 完整參數表

參數本題預設值白話
optimizer'adam''rmsprop'怎麼依照梯度更新權重。可以給字串,也可以給優化器物件
loss(B)None怎麼計算預測和答案差多少。訓練就是想辦法讓它變小
metrics(沒寫)None訓練時順便顯示的指標,常寫 ['accuracy']。本題沒寫,所以訓練時只會看到 loss,看不到準確率
loss_weights—None多個輸出時,各個 loss 的權重
weighted_metrics—None會考慮樣本權重的指標
run_eagerly—FalseTrue 會逐行執行,方便除錯但比較慢
steps_per_execution—1一次送幾個批次給運算裝置,調大可加速
jit_compile—'auto'是否用 XLA 編譯加速

(B) 填 categorical_crossentropy:配合 One-Hot 標籤的損失函數

categorical_crossentropy = −Σ yᵢ × log(pᵢ) (y 是答案,p 是預測機率) One-Hot 標籤只有正確類別是 1,其他都是 0,所以加總裡只剩一項: loss = −log( 模型給正確答案的機率 ) 正確答案的機率 0.90 → loss = 0.105 (很有把握且答對,罰很輕) 正確答案的機率 0.24 → loss = 1.417 (猶豫) 正確答案的機率 0.01 → loss = 4.605 (很有把握地答錯,罰很重)

log 的特性讓「越有把握地答錯」被罰得越重。訓練時,optimizer 會不斷調整權重,把正確類別的機率推高、讓 loss 變小。

三個長得很像的 crossentropy,差在標籤長相

損失函數標籤 y 長這樣(答案是 7)搭配的輸出層
categorical_crossentropy[0,0,0,0,0,0,0,1,0,0](One-Hot)Dense(10, softmax)
sparse_categorical_crossentropy7(一個整數)Dense(10, softmax)
binary_crossentropy0 或 1;多標籤時是多個 0/1Dense(1 或 k, sigmoid)
mean_squared_error任意實數,例如房價 352.7Dense(1),不加激活(迴歸)

sparse 版和一般版算出來的數學結果相同,只是吃的標籤格式不同。題目明講「標籤已轉為 One-Hot」,所以選沒有 sparse 的那個。

深入一點:為什麼 softmax 和 cross-entropy 是天生一對

把 softmax 和 categorical_crossentropy 接在一起,對 logits 求梯度,結果簡單得驚人:梯度 = 預測機率 − 答案(p − y)。

logits z = [2.0, 1.0, 0.1],答案 y = [0, 1, 0] softmax p = [0.659, 0.242, 0.099] 梯度 = p − y = [0.659, −0.758, 0.099] 用 tf.GradientTape 實際算出來:[0.6590, −0.7576, 0.0986] ← 和 p − y 一模一樣

白話:正確類別的梯度是負的(要把它的分數往上推),其他類別是正的(往下壓),而且錯得越多,推力越大。梯度不會因為「很有把握地答錯」而變得很小,這正是 sigmoid + MSE(選項 A)做不到的。

'adam' 背後是什麼

字串 'adam' 會讓 Keras 用預設值建立一個 Adam 優化器物件:learning_rate=0.001、beta_1=0.9、beta_2=0.999、epsilon=1e-07。Adam 會依照每個權重最近的梯度大小,自動調整各自的步伐,是目前最常用的預設選擇。

如果想自己改學習率,就不要給字串,改給一個物件:

from tensorflow.keras.optimizers import Adam
opt = Adam(learning_rate=1e-4)              # 類別 → 物件(自訂參數)
model.compile(loss='categorical_crossentropy', optimizer=opt)   # 把物件當參數傳進去

這又是一次「類別 → 物件」:字串只是用預設值的捷徑,物件才能細調。

compile 之後的 fit(),背後在做什麼

compile 只是「設定」。真正訓練是 model.fit(),它對每一小批資料重複四件事:

① 前向model(x) 算出 10 個機率
→
② 算 losscategorical_crossentropy
→
③ 算梯度自動微分
→
④ 更新Adam 改 50,890 個參數

Keras 把這四步藏在 fit 裡面;PyTorch 則要你自己把迴圈寫出來,第 50 題就是那個迴圈。

新手常踩的坑

  • 標籤是整數(例如 [1, 2, 3])卻用 categorical_crossentropy。實測 fit 時:ValueError: Arguments `target` and `output` must have the same rank (ndim). Received: target.shape=(None,), output.shape=(None, 10)。意思是答案只有 1 維、輸出有 10 格,對不上。
  • 標籤是 One-Hot 卻用 sparse_categorical_crossentropy。實測:ValueError: Argument `output` must have rank (ndim) `target.ndim - 1`. Received: target.shape=(None, 10), output.shape=(None, 10)。sparse 版預期答案比輸出少 1 維(只有一個整數)。
  • 沒寫 metrics=['accuracy'] 就問「準確率在哪」:compile 沒要求,fit 就只印 loss。
§4

互動實驗:把四個選項的激活函數套在同一組 logits 上

下面 10 個滑桿是輸出層 Dense(10) 算出的 10 個 logits。切換激活函數,看輸出是不是「合法的機率分布」,以及 categorical_crossentropy 會給多少 loss。

輸出層激活函數實驗室
先按一個情境,再切換上方四個函數比較。
logits(Dense 的原始分數),拖拉可調整
激活後的 10 個輸出(綠色 = 正確答案)

整個模型的資料流

(筆數, 784)展平的圖片
→
Dense 64 + ReLU50,240 參數
→
(筆數, 64)64 個特徵
→
Dense 10 + softmax650 參數
→
(筆數, 10)10 個機率
→
categorical_crossentropy和 One-Hot 比對
→
Adam更新 50,890 個參數

用 model.summary() 印出來,會長這樣(實際在 TensorFlow 2.20 / Keras 3 執行的結果):

Layer (type)            Output Shape         Param #
dense (Dense)           (None, 64)            50,240
dense_1 (Dense)         (None, 10)               650
Total params: 50,890 (198.79 KB)
Trainable params: 50,890
Non-trainable params: 0

None 代表「一次餵幾筆還不知道」。198.79 KB 是 50,890 個 32 位元浮點數(每個 4 bytes)佔用的記憶體。

§5

回到題目:逐項對答案

(A) sigmoid,mean_squared_error 錯

激活:sigmoid 把每個輸出各自壓到 0~1,但 10 個加起來不會等於 1,表達不了「只會是其中一個」。
損失:MSE 是迴歸用的「距離平方」。拿來做分類時,預測很錯時梯度反而很小,學得慢,不是分類的首選。

(B) softmax,categorical_crossentropy 正解

softmax 輸出 10 個加總為 1 的機率,符合單標籤 10 類。categorical_crossentropy 吃的正好是 One-Hot 標籤,兩個條件都對上。

(C) relu,binary_crossentropy 錯

激活:relu 輸出 0~∞,可能大於 1,也可能剛好是 0(取 log 會變負無限大),不是機率。
損失:binary_crossentropy 是二元分類或多標籤(每一類各自判斷是或不是)用的。

(D) tanh,sparse_categorical_crossentropy 錯

激活:tanh 輸出 -1~1,有負數,不可能是機率。
損失:sparse 版要吃整數標籤(例如 7),但題目的標籤已經是 One-Hot。

記一張配對表就夠:輸出層 × 損失函數

任務輸出層損失函數標籤長相
二元分類(是 / 否)Dense(1, 'sigmoid')binary_crossentropy0 或 1
多類別單標籤,One-HotDense(k, 'softmax')categorical_crossentropy[0,…,1,…,0]
多類別單標籤,整數Dense(k, 'softmax')sparse_categorical_crossentropy0~k-1 的整數
多標籤(可同時多類)Dense(k, 'sigmoid')binary_crossentropy[1,0,1,…] 可以有多個 1
迴歸(預測數值)Dense(1),不加激活mean_squared_error任意實數
§6

動手跑跑看:把考題補成完整可執行的程式

考題只寫到 compile。下面把資料準備、訓練、評估、預測補齊,複製貼到 Google Colab 就能直接執行(Colab 已經裝好 TensorFlow)。

import numpy as np
from tensorflow import keras
from tensorflow.keras import Sequential, Input
from tensorflow.keras.layers import Dense

# 1. 載入 MNIST:6 萬張訓練圖、1 萬張測試圖,每張 28x28、像素 0~255
(x_train, y_train), (x_test, y_test) = keras.datasets.mnist.load_data()

# 2. 展平成 784,並把像素縮放到 0~1
x_train = x_train.reshape(-1, 784).astype("float32") / 255.0
x_test  = x_test.reshape(-1, 784).astype("float32") / 255.0

# 3. 標籤轉 One-Hot:7 -> [0,0,0,0,0,0,0,1,0,0]
y_train = keras.utils.to_categorical(y_train, 10)
y_test  = keras.utils.to_categorical(y_test, 10)

# 4. 建模型(考題的寫法,換成新式 Input)
model = Sequential([
    Input(shape=(784,)),
    Dense(64, activation='relu'),
    Dense(10, activation='softmax')          # (A)
])

# 5. 設定訓練方式,多加 metrics 才看得到準確率
model.compile(loss='categorical_crossentropy',   # (B)
              optimizer='adam',
              metrics=['accuracy'])
model.summary()

# 6. 訓練:看 5 輪,每批 128 張,抽 10% 當驗證集
history = model.fit(x_train, y_train, epochs=5, batch_size=128,
                    validation_split=0.1)

# 7. 在測試集評估
test_loss, test_acc = model.evaluate(x_test, y_test)
print("測試準確率:", test_acc)

# 8. 拿第一張測試圖預測
probs = model.predict(x_test[:1])
print(probs.round(3))          # 10 個機率
print("加總:", probs.sum())    # 約等於 1(softmax 的特性)
print("預測是:", probs.argmax(), ",答案是:", y_test[0].argmax())
跑起來大概會看到什麼

這份程式實際跑過一次(TensorFlow 2.20、CPU,每輪約 1 秒):

Epoch 1/5  accuracy: 0.8788 - loss: 0.4453 - val_accuracy: 0.9472 - val_loss: 0.2034
Epoch 5/5  accuracy: 0.9673 - loss: 0.1138 - val_accuracy: 0.9713 - val_loss: 0.1027
測試準確率: 0.9661
[[0. 0. 0. 0. 0. 0. 0. 1. 0. 0.]]
加總: 1.0000001
預測是: 7 ,答案是: 7

5 輪後測試準確率約 96.6%。第一張測試圖(答案是 7)幾乎 100% 預測成 7。加總印出 1.0000001 而不是剛好 1,是浮點數的微小誤差。每次重跑數字會有一點不同,因為權重一開始是隨機抽的。

新出現的語法是什麼白話
keras.datasets.mnist.load_data()函式下載並回傳兩組 tuple:(訓練圖, 訓練標籤), (測試圖, 測試標籤)
x_train.reshape(-1, 784)NumPy 陣列的方法把 (60000, 28, 28) 改成 (60000, 784)。-1 代表「這維你自己算」
.astype("float32")NumPy 陣列的方法把整數轉成 32 位元浮點數
keras.utils.to_categorical(y, 10)函式整數標籤轉 One-Hot
model.fit(...)模型的方法開始訓練,回傳 History 物件,history.history 裡有每輪的 loss 和 accuracy
epochs=5fit 的參數整份訓練資料完整看 5 遍
batch_size=128fit 的參數每看 128 張就更新一次權重(預設 32)
validation_split=0.1fit 的參數從訓練資料最後切 10% 出來,不拿來訓練,只用來看泛化表現
probs.argmax()NumPy 陣列的方法回傳最大值的位置,也就是機率最高的類別
§7

一頁總結+自我檢測

這題要帶走的 5 件事
  1. Sequential、Dense 是類別;加上括號才做出物件;用 model.方法() 叫物件做事。
  2. Dense 的第一個位置參數是 units(神經元數);輸出層 units 要等於類別數。
  3. 參數數量 = 輸入數 × 神經元數 + 神經元數(偏差):784×64+64 = 50,240。
  4. 單標籤多類別 → softmax(10 個機率加總為 1)。
  5. One-Hot 標籤 → categorical_crossentropy;整數標籤 → sparse_categorical_crossentropy。
如果標籤沒有轉 One-Hot,y 是 0~9 的整數,(B) 要改成什麼?
sparse_categorical_crossentropy。輸出層仍然是 Dense(10, activation='softmax'),只有損失函數換掉。
寫成 model = model.compile(...) 會發生什麼事?
compile 是「修改物件自己」的方法,回傳 None。這行執行完 model 會變成 None,接著呼叫 model.fit() 會出現 AttributeError: 'NoneType' object has no attribute 'fit'。
如果第一層改成 Dense(128, …),第一層和第二層各有多少參數?
第一層:784 × 128 + 128 = 100,480。第二層:128 × 10 + 10 = 1,290。
如果是「一張圖可能同時有貓和狗」的多標籤問題,輸出層和損失函數怎麼選?
輸出層用 sigmoid(每一類各自判斷有或沒有),損失用 binary_crossentropy。這時機率加起來不需要等於 1。
input_shape=(784) 和 input_shape=(784,) 差在哪?
沒有逗號的 (784) 只是整數 784;有逗號的 (784,) 才是只含一個元素的 tuple。shape 要給 tuple。