實測:
df.shape → (200, 4)
df.head(2) → 276.12 45.36 83.04 26.52
53.40 NaN 54.12 12.48 ← 第 2 列的 facebook 是遺漏值
Questions 48–50 · describe / 遺漏值 / 線性迴歸
行銷預算題組:讀懂 describe、找遺漏值、
兩種套件做同一個迴歸
這是一個 3 題的題組:200 筆資料記錄 YouTube、Facebook、報紙的廣告預算和銷售額(marketing.csv)。第 48 題讀 df.describe() 的數字,第 49 題找遺漏值的語法,第 50 題用 scikit-learn 和 statsmodels 各做一次線性迴歸、讀報表。答案依序是 D、C、B。這頁用同一份公開資料重現了考卷每一個數字:facebook 那一格遺漏值用中位數 27.0填補時,statsmodels 的報表和考卷逐字相同。每個選項都實際跑過,包括「不會出錯、但算的是完全不同的東西」的那一個。
pandas 2.2.3scikit-learn 1.8.0statsmodels 0.14.5
describe四分位數isna / isnullLinearRegression
coef_ / intercept_add_constantsm.OLSp 值零基礎可讀
讀完這頁,你會知道
describe()的 8 列各是什麼:count 是不是遺漏值的筆數(facebook 199,資料其實有 200 筆);mean 是平均、50% 才是中位數;25%、75% 是第一、第三四分位數。- 找遺漏值:
isna()和isnull()是同一個方法的兩個名字;isNaN、isnan在 DataFrame 上不存在(AttributeError)。 - 兩個套件的參數順序剛好相反:scikit-learn 是
fit(X, y),statsmodels 是OLS(y, X)。寫反時一個馬上出錯,另一個不會出錯,要到印報表時才炸開。 - scikit-learn 的
coef_只有 3 個(每個特徵一個),截距另外放在intercept_;statsmodels 要先add_constant加一欄 1,報表才會有截距 const。 - 讀 summary 報表:coef 是係數、P>|t| 是 p 值。newspaper 的 p 值 0.914,在 α=0.05 下不顯著,所以「所有係數都顯著」是錯的。
§0
題目:行銷預算題組(第 48~50 題)
使用銷售資料集(marketing.csv)進行迴歸分析,附圖程式碼展示資料載入與處理,請回答後續 48~50 題。
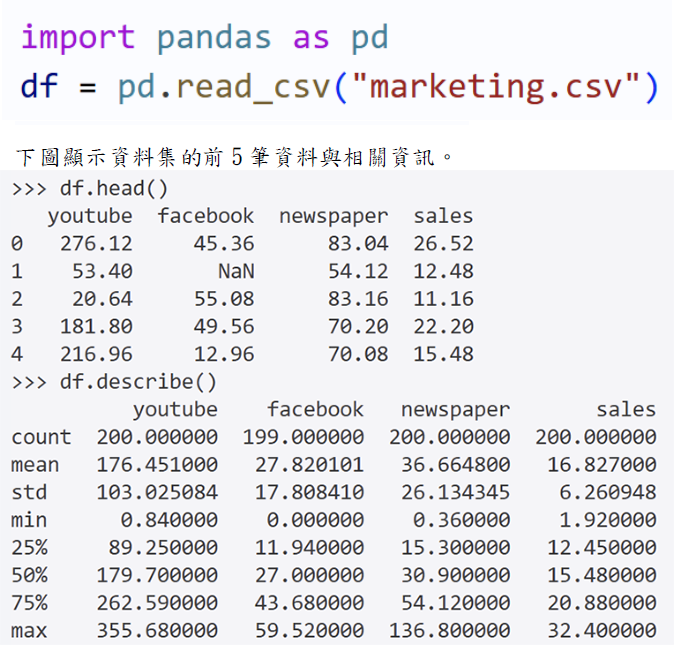
第 48 題根據上述結果,下列何者正確?
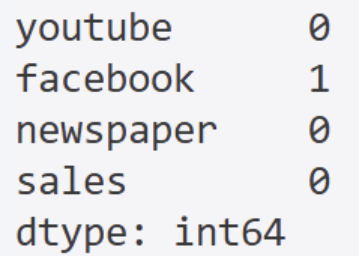
第 49 題參考下圖計算各變數的遺漏值(NaN)個數結果,下列何者正確?
- 選項 A:
df.isnull().sum() - 選項 B:
df.isNaN().sum() - 選項 C:
df.isna().sum() - 選項 D:
df.isnan().sum()
第 50 題考慮資料集已經填補遺漏值,參考下圖執行結果,下列何者正確?
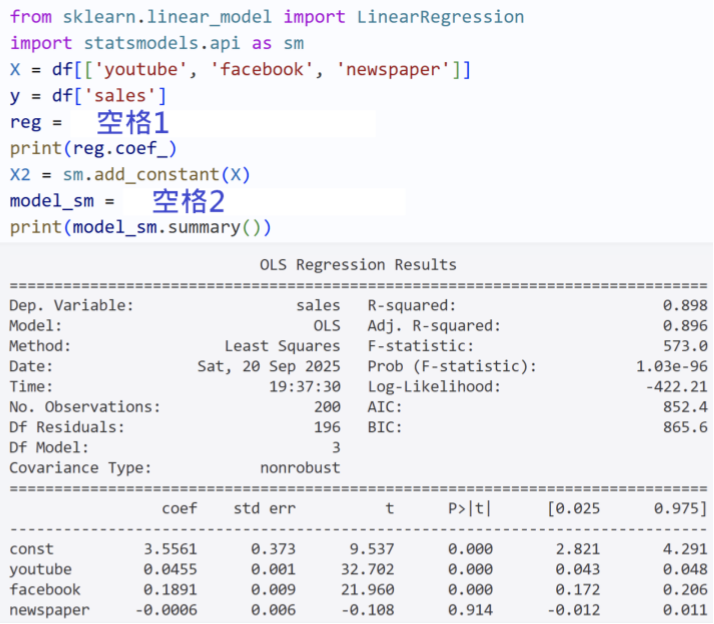
- A:空格 1 完整語法
reg = LinearRegression().fit(y, X) - B:空格 1 完整語法
reg = LinearRegression().fit(X, y) - C:
print(reg.coef_)結果為包括截距項等 4 個係數值 - D:空格 2 完整語法
sm.OLS(X2, y).fit() - E:model_sm 迴歸模型的所有迴歸係數在 α=0.05 之下具有顯著的解釋力
- F:截距項係數值為 3.5561
關於本頁的資料與版本
考卷的資料是 R 套件 datarium 裡的 marketing 資料(200 筆:youtube、facebook、newspaper 三種廣告預算,單位千元;sales 銷售額,單位千件),只是把第 2 列的 facebook(原本 47.16)改成了遺漏值。本頁照這樣重建後,head()、describe()、isnull().sum() 都和考卷一模一樣;第 50 題說「已經填補遺漏值」,實測用 facebook 的中位數 27.0填補時,報表和考卷逐字相同(用平均數 27.82 填,截距會是 3.5540)。
本頁所有數字、輸出都是在 pandas 2.2.3、scikit-learn 1.8.0、statsmodels 0.14.5(NumPy 2.4.3、Python 3.13.7)上實際執行的結果。
§1
先補基本功:這個題組需要的 5 個觀念
第 48 題考讀表,第 49 題考遺漏值,第 50 題考迴歸。中間兩支動畫:一支把 describe 的每個數字放回 200 筆資料裡看,一支打開記憶體,看 LinearRegression 和 OLS 各做出什麼物件。
① describe觀念 1、動畫 1
→
② 遺漏值觀念 2
→
③ 線性迴歸觀念 3
→
④ 兩個套件觀念 4
→
⑤ 讀報表觀念 5、動畫 2
觀念 1|describe():一欄 8 個數字
df.describe() 對每一個數值欄算 8 個統計量。把一欄的 200 個數字由小排到大,就能看懂每一列:
| 列 | 意思 | youtube(實測) |
|---|---|---|
count | 不是遺漏值的筆數(遺漏值不算) | 200(facebook 是 199) |
mean | 平均 | 176.451 |
std | 標準差:資料散得多開 | 103.025084 |
min、max | 最小、最大 | 0.84、355.68 |
25% | 第一四分位數 Q1:排好之後 1/4 的位置 | 89.25 |
50% | 中位數(Q2):正中間 | 179.70 |
75% | 第三四分位數 Q3:3/4 的位置 | 262.59 |
兩個常見的混淆:① mean 不是中位數:sales 的平均 16.827、中位數 15.48。② 「資料有幾筆」看 df.shape(實測 (200, 4)),不是看 count;count 只數有值的格子。
看動畫 1 之前:這支要回答什麼
觀念 1 列出了 describe 的 8 列。動畫 1 把每個數字放回 200 筆資料裡看:先找到 facebook 那一格遺漏值,再把 youtube、sales、facebook 的數字由小排到大,看 25%、50%、75%、mean 各落在哪裡,把第 48 題的四個選項一個一個對。
帶著三個問題看:① facebook 的 count 為什麼是 199?② 25%、50%、75% 各叫什麼?③ 16.827 是 sales 的什麼?
動畫 1describe 的 8 個數字:放回 200 筆資料裡看2 分 14 秒・有旁白,也有字幕
表格、排好的 200 個數字和每一條標線,都是用 pandas 2.2.3 在本頁的 marketing.csv 上實際算出來的(和考卷的 describe 一模一樣)。
看完動畫 1,你應該能回答:facebook 的 count 為什麼是 199?
count 只數有值的格子;facebook 第 2 列是 NaN(遺漏值),不算。資料其實有 200 筆,df.shape 是 (200, 4)。
25%、50%、75% 各叫什麼?
把數字由小排到大,1/4 的位置是第一四分位數 Q1(25%),正中間是中位數(50%),3/4 是第三四分位數 Q3(75%)。youtube 的 Q1 是 89.25。
16.827 是 sales 的什麼?
平均(mean)。sales 的中位數是 50% 那一列:15.48。
觀念 2|找遺漏值:isna 和 isnull 是同一個
df.isna() 把每一格換成 True(是遺漏值)或 False,.sum() 再把每一欄的 True 數起來(True 算 1)。pandas 的說明文件寫著:DataFrame.isnull is an alias for DataFrame.isna(isnull 是 isna 的別名),兩個結果一模一樣(實測 equals 是 True)。
isNaN、isnan 都不是 DataFrame 的方法,呼叫會出錯:AttributeError: 'DataFrame' object has no attribute 'isnan'。容易混淆的是 NumPy 有一個函式 np.isnan(df)(實測也能數出 facebook 1 個),但它要寫成函式呼叫,不是 df.isnan()。
觀念 3|線性迴歸:用預算預測銷售額
線性迴歸假設銷售額大約等於「一個基本值,加上每種預算各乘一個係數」:
sales ≈ 截距 + b1 × youtube + b2 × facebook + b3 × newspaper
      ≈ 3.5561 + 0.0455 × youtube + 0.1891 × facebook − 0.0006 × newspaper(實測)
係數的意思:其他預算不變時,這種預算多 1 單位,銷售額平均變多少。facebook 的 0.1891 表示多投 1 千元 Facebook 廣告,銷售額約多 0.19 千件。截距 3.5561 是三種預算都是 0 時的預測值。三個特徵,所以有 3 個係數+1 個截距。
觀念 4|兩個套件,參數順序相反
| scikit-learn | statsmodels | |
|---|---|---|
| 怎麼寫 | LinearRegression().fit(X, y) | sm.OLS(y, X2).fit() |
| 截距 | 預設自動加(fit_intercept=True) | 要自己 sm.add_constant(X) 加一欄 1 |
| 係數放哪 | coef_(3 個)、intercept_(1 個) | params(const+3 個) |
| 重點 | 預測 | 統計推論:標準誤、t 值、p 值、信賴區間 |
記法:scikit-learn 先給「題目」X 再給「答案」y;statsmodels 照數學式 y = Xb 的順序,先寫 y。兩個算出來的係數一樣(實測 3.5561、0.0455、0.1891、−0.0006)。
觀念 5|讀 summary 報表:coef 和 p 值
報表下半部每一列是一個係數:coef 是係數、std err 是標準誤、t = coef ÷ std err、P>|t| 是 p 值:「如果這個係數其實是 0,還會看到這麼大的 t 的機率」。p 值小於 α(通常 0.05),就說這個係數顯著。
| coef | P>|t| | α=0.05 顯著嗎 | |
|---|---|---|---|
| const | 3.5561 | 0.000 | 是 |
| youtube | 0.0455 | 0.000 | 是 |
| 0.1891 | 0.000 | 是 | |
| newspaper | −0.0006 | 0.914 | 否 |
報紙廣告的係數幾乎是 0,而且 p 值 0.914 遠大於 0.05:從這份資料看不出報紙預算和銷售額有關。上半部的 R-squared 0.898 表示這條式子解釋了銷售額 89.8% 的變化。
把觀念合起來:兩個套件各做出什麼物件
看動畫 2 之前:這支要回答什麼
觀念 3~5 講了線性迴歸、兩個套件、讀報表。動畫 2 打開記憶體,一行一行看:LinearRegression() 做出的物件、fit 之後多了什麼;add_constant 交回的表;OLS 和 fit 各交回什麼;最後看寫反成 OLS(X2, y) 時,為什麼 fit 不會出錯。
帶著三個問題看:① LinearRegression() 剛做出來時,有 coef_ 嗎?② print(reg.coef_) 印出幾個數字?截距在哪?③ sm.OLS(X2, y).fit() 會怎樣?
動畫 2打開記憶體:LinearRegression 和 OLS 各做出什麼2 分 33 秒・有旁白,也有字幕
物件型別、係數、p 值、形狀和錯誤訊息,都是 scikit-learn 1.8.0、statsmodels 0.14.5 實際執行的結果。
看完動畫 2,你應該能回答:LinearRegression() 剛做出來時,有 coef_ 嗎?
沒有(hasattr 是 False)。要 fit(X, y) 之後才有 coef_ 和 intercept_;fit 交回物件自己,所以 reg 就是學好的模型。
print(reg.coef_) 印出幾個數字?截距在哪?
3 個(youtube、facebook、newspaper 各一個)。截距另外放在 reg.intercept_:3.5561。
sm.OLS(X2, y).fit() 會怎樣?
不會出錯:它把 X2 的 4 欄當成要被解釋的東西,用 sales 去解釋,params 變成 1 × 4、欄名變成 0~3。要到 summary() 才出錯 ValueError。
§2
認識 scikit-learn 和 statsmodels
兩個都能做線性迴歸。scikit-learn 是機器學習工具箱,介面統一(fit、predict),重點在預測;statsmodels 是統計工具箱,重點在報表與檢定。簽名(實測):
LinearRegression(*, fit_intercept=True, copy_X=True, tol=1e-06, n_jobs=None, positive=False)
sm.add_constant(data, prepend=True, has_constant='skip')
sm.OLS(endog, exog=None, missing='none', hasconst=None, **kwargs)
| 名稱 | 是什麼 | 本題 |
|---|---|---|
LinearRegression().fit(X, y) | 做出模型物件、用資料學係數;fit 交回物件自己,所以可以直接接在後面 | 空格 1 |
reg.coef_、reg.intercept_ | 學到的係數(3 個)、截距(1 個);名字後面的底線表示「fit 之後才有」 | 選項 C |
sm.add_constant(X) | 交回新的 DataFrame,最前面多一欄全是 1.0 的 const | X2 |
sm.OLS(endog, exog) | OLS=最小平方法。endog(被解釋的)=y,exog(解釋的)=X2 | 空格 2 |
.fit()、.summary() | 估計係數,交回結果物件;summary 印報表 | 選項 E、F |
fit(y, X) 馬上出錯
scikit-learn 要求 X 是二維(一列一筆),y 是一維;給反了,y 這個一維的 Series 被當成 X,ValueError。
OLS(X2, y) 不會出錯
statsmodels 照樣把 X2 的 4 欄當成要被解釋的東西、用 sales 去解釋它們,fit 成功;要到 summary() 才出錯。最危險的一種錯。
沒有 add_constant
statsmodels 不會自動加截距;沒加 const,報表就沒有截距,係數也會不同。
§3
逐行解剖:三題接成一支程式(空格已填好)
左邊把考卷的兩張程式接在一起:讀資料、看遺漏值、填補(考卷說「已經填補遺漏值」,第 7 行是本頁重現考卷數字的做法),再填好兩個空格。完整可以執行的版本在 §6。
q48_50.py18 行
df.describe()方法每個數值欄算 count、mean、std、min、25%、50%、75%、max,交回一個新的 DataFrame。
實測(取幾格):
facebook count → 199 ← 遺漏值不算
sales mean → 16.827 ← 平均,不是中位數
sales 50% → 15.48 ← 中位數
facebook 25% → 11.94 ← Q1(不是 Q3)
youtube 25% → 89.25 ← Q1:第 48 題答案 D
df.isnull()、df.isna()方法同一個方法的兩個名字;每格換成 True/False。
.sum()方法每欄的 True 加起來(True=1)。
兩行都印出:
youtube 0、facebook 1、newspaper 0、sales 0
考卷只說「已經填補遺漏值」。本頁試過幾種方法,只有用 facebook 的中位數 27.0 填,報表才和考卷逐字相同。
df['facebook'].median()方法中位數(不算遺漏值):27.0。
.fillna(27.0)方法把遺漏值換成 27.0,交回新的 Series,再放回 df。
from sklearn.linear_modelfrom從 scikit-learn(匯入時寫 sklearn)裡的 linear_model 模組……
import LinearRegressionimport……只拿出 LinearRegression 這個類別。
import statsmodels.api as smimport … as整個 statsmodels.api 取一個短名字 sm,後面寫 sm.OLS、sm.add_constant。
df[[ … ]]兩層方括號裡面是 3 個欄名的清單,交回 DataFrame(200 × 3)。
df['sales']一層方括號一個欄名,交回 Series(200 個)。
LinearRegression()類別做出一個還沒學的模型物件。
.fit(X, y)方法X 在前、y 在後。學好係數後交回物件自己,所以 reg 指向這個模型。
print(reg.coef_)(實測):
[ 0.04553133 0.1891022 -0.00063392] ← 3 個,沒有截距
reg.intercept_ → 3.556127018671976
X2 的前兩列(實測):
const youtube facebook newspaper
0 1.0 276.12 45.36 83.04
1 1.0 53.40 27.00 54.12
sm.OLS(y, X2)類別y 在前(endog),X2 在後(exog)。
.fit()方法估計係數,交回結果物件 model_sm。
.summary()方法報表:R-squared 0.898、F 573.0、const 3.5561、newspaper 的 p 值 0.914(§6 程式 2 有完整輸出)。
§4
互動實驗:describe 放回資料裡看、迴歸實驗室
兩個實驗的資料、describe 的數字、係數和 p 值,都是事先用 pandas 2.2.3、statsmodels 0.14.5 實際算好的(§6 的程式可以自己重跑);實驗 2 的預測就是把係數代進式子,和 model_sm.predict 的結果一致。
可以試試看
① 實驗 1 點 facebook 的 count:199,因為有一格遺漏值;再點 sales 的 mean 和 50%:平均 16.827 在中位數 15.48 的右邊。② 實驗 2 把 newspaper 從 0 拉到 140:預測的銷售額只少了 0.089,報紙廣告幾乎沒影響(p 值 0.914)。③ 換成「平均數填補」:截距變成 3.5540,不再是考卷的 3.5561;「刪掉那一列」變 3.5392。
看動畫 3 之前:這支要回答什麼
實驗 2 讓你換填補方式、看報表的數字。動畫 3 把第 49、50 題的每個選項實際跑一次:四種數遺漏值的寫法、第 50 題的六句話各對不對(出錯的看真實的錯誤訊息),最後比較三種填補方式。
帶著三個問題看:① 第 49 題哪兩個寫法會出錯?② 第 50 題的 E 為什麼錯?③ 用平均數填補,截距會是多少?
動畫 3第 49、50 題:每個選項實際跑一次2 分 22 秒・有旁白,也有字幕
畫面上的輸出、錯誤訊息和報表數字,都是 pandas 2.2.3、scikit-learn 1.8.0、statsmodels 0.14.5 實際執行的結果(和 §6 是同一批)。
看完動畫 3,你應該能回答:第 49 題哪兩個寫法會出錯?
df.isNaN() 和 df.isnan():DataFrame 沒有這兩個方法,AttributeError。isnull 和 isna 是同一個,結果一樣,所以答案 C(選項 A、選項 C)。
第 50 題的 E 為什麼錯?
newspaper 的 P>|t| 是 0.914,大於 0.05,不顯著;不是所有係數都顯著。
用平均數填補,截距會是多少?
3.5540(刪掉那一列是 3.5392)。只有用中位數 27.0 填補,截距才是考卷上的 3.5561。
§5
逐題對答案
第 48 題:答案 D
(A) 資料集個數為 199 筆,變數個數為 4 個 錯
資料有 200 筆(df.shape 是 (200, 4),youtube、newspaper、sales 的 count 都是 200)。facebook 的 count 199 是因為有一格遺漏值,count 不數遺漏值。
(B) sales 變數的中位數是 16.827 錯
16.827 是 sales 的 mean(平均);中位數是 50% 那一列:15.48。
(C) facebook 變數的第三四分位數(Q3)是 11.94 錯
11.94 在 25% 那一列,是第一四分位數 Q1;facebook 的 Q3(75%)是 43.68。
(D) youtube 變數的第一四分位數(Q1)是 89.25 正解
youtube 的 25% 那一格就是 89.25。
第 49 題:答案 C(選項 A、選項 C)
| 寫法 | 實測 | 判斷 |
|---|---|---|
A:df.isnull().sum() | youtube 0、facebook 1、newspaper 0、sales 0 | 對 |
B:df.isNaN().sum() | AttributeError: 'DataFrame' object has no attribute 'isNaN' | 錯 |
C:df.isna().sum() | 和 A 完全一樣(isnull 是 isna 的別名) | 對 |
D:df.isnan().sum() | AttributeError: 'DataFrame' object has no attribute 'isnan' | 錯 |
JavaScript 有 isNaN、NumPy 有 np.isnan 函式,所以這兩個名字看起來很眼熟,但它們都不是 pandas DataFrame 的方法。
第 50 題:答案 B(B、F)
A:空格 1 是 LinearRegression().fit(y, X) 錯:出錯
ValueError: Expected a 2-dimensional container but got <class 'pandas.core.series.Series'> instead. Pass a DataFrame containing a single row (i.e. single sample) or a single column (i.e. single feature) instead.
scikit-learn 的 fit 第一個要 X(二維),y 是一維的 Series,放第一個就出錯。
B:空格 1 是 LinearRegression().fit(X, y) 對
X 在前、y 在後;fit 交回模型自己。
C:print(reg.coef_) 是包括截距項的 4 個係數 錯
實測 [ 0.04553133 0.1891022 -0.00063392]:3 個,每個特徵一個。截距在 reg.intercept_(3.556127018671976)。
D:空格 2 是 sm.OLS(X2, y).fit() 錯:順序反了
statsmodels 是 OLS(y, X2)。寫反時 .fit() 不會出錯:它把 X2 的 4 欄當成要被解釋的東西,用 sales 去解釋它們,算出一組形狀 (1, 4) 的係數;要到下一行 summary() 才出錯:
ValueError: shapes (200,4) and (200,4) not aligned: 4 (dim 1) != 200 (dim 0)
E:所有迴歸係數在 α=0.05 之下都顯著 錯
newspaper 的 P>|t| 是 0.914,大於 0.05,不顯著。
F:截距項係數值為 3.5561 對
報表 const 那一列的 coef 是 3.5561(scikit-learn 的 intercept_ 3.556127… 也一樣)。
常見的錯誤想法
| 錯誤想法 | 實際上 |
|---|---|
| count 就是資料筆數 | count 只數有值的格子;資料筆數看 shape。 |
| mean 就是中位數 | 中位數是 50% 那一列;sales 的 mean 16.827、中位數 15.48。 |
| isNaN、isnan 也能用 | DataFrame 只有 isna 和 isnull(同一個);np.isnan 是 NumPy 的函式。 |
| 兩個套件的 fit 都是 (X, y) | scikit-learn 是 fit(X, y);statsmodels 是 OLS(y, X)。 |
| 沒出錯就代表寫對了 | sm.OLS(X2, y).fit() 不會出錯,算的卻是完全不同的東西。 |
| coef_ 包含截距 | 截距另外在 intercept_;statsmodels 才把 const 和係數放在一起。 |
§6
動手跑跑看:三支程式
先安裝套件:pip install pandas scikit-learn statsmodels(Google Colab 已經內建)。資料:R 套件 datarium 的 marketing,存成 marketing.csv 後把第 2 列的 facebook 刪成空白,就和考卷一樣。
程式 1:第 48、49 題:describe 與遺漏值
import pandas as pd

df = pd.read_csv("marketing.csv")
print(df.shape)
print(df.describe().round(2))
print(df.isnull().sum())                  # 選項 A
print(df.isna().sum().equals(df.isnull().sum()))   # 選項 C 的結果一樣嗎?
for name in ('isNaN', 'isnan'):           # 選項 B、D
    try:
        getattr(df, name)()
    except AttributeError as e:
        print(name, '→', e)
實際跑出來的結果(pandas 2.2.3)
(200, 4)
       youtube  facebook  newspaper   sales
count   200.00    199.00     200.00  200.00
mean    176.45     27.82      36.66   16.83
std     103.03     17.81      26.13    6.26
min       0.84      0.00       0.36    1.92
25%      89.25     11.94      15.30   12.45
50%     179.70     27.00      30.90   15.48
75%     262.59     43.68      54.12   20.88
max     355.68     59.52     136.80   32.40
youtube      0
facebook     1
newspaper    0
sales        0
dtype: int64
True
isNaN → 'DataFrame' object has no attribute 'isNaN'
isnan → 'DataFrame' object has no attribute 'isnan'
程式 2:第 50 題:填好兩個空格,印出報表
import pandas as pd
from sklearn.linear_model import LinearRegression
import statsmodels.api as sm

df = pd.read_csv("marketing.csv")
df['facebook'] = df['facebook'].fillna(df['facebook'].median())   # 用中位數 27.0 填補
X = df[['youtube', 'facebook', 'newspaper']]
y = df['sales']

reg = LinearRegression().fit(X, y)          # 空格 1
print(reg.coef_)
print(reg.intercept_)

X2 = sm.add_constant(X)
model_sm = sm.OLS(y, X2).fit()              # 空格 2
print(model_sm.summary())
實際跑出來的結果(scikit-learn 1.8.0、statsmodels 0.14.5)
[ 0.04553133  0.1891022  -0.00063392]
3.556127018671976
                            OLS Regression Results
==============================================================================
Dep. Variable:                  sales   R-squared:                       0.898
Model:                            OLS   Adj. R-squared:                  0.896
Method:                 Least Squares   F-statistic:                     573.0
Date:                Mon, 19 Oct 2026   Prob (F-statistic):           1.03e-96
Time:                        17:55:49   Log-Likelihood:                -422.21
No. Observations:                 200   AIC:                             852.4
Df Residuals:                     196   BIC:                             865.6
Df Model:                           3
Covariance Type:            nonrobust
==============================================================================
                 coef    std err          t      P>|t|      [0.025      0.975]
------------------------------------------------------------------------------
const          3.5561      0.373      9.537      0.000       2.821       4.291
youtube        0.0455      0.001     32.702      0.000       0.043       0.048
facebook       0.1891      0.009     21.960      0.000       0.172       0.206
newspaper     -0.0006      0.006     -0.108      0.914      -0.012       0.011
==============================================================================
Omnibus:                       63.048   Durbin-Watson:                   2.099
Prob(Omnibus):                  0.000   Jarque-Bera (JB):              164.869
Skew:                          -1.367   Prob(JB):                     1.58e-36
Kurtosis:                       6.508   Cond. No.                         544.
==============================================================================

Notes:
[1] Standard Errors assume that the covariance matrix of the errors is correctly specified.
報表的每一個數字都和考卷一樣,只有 Date、Time 是執行當下的時間。
程式 3:填補方式的影響,和兩個寫反的選項
import pandas as pd
from sklearn.linear_model import LinearRegression
import statsmodels.api as sm

df = pd.read_csv("marketing.csv")
cols = ['youtube', 'facebook', 'newspaper']

# 填補方式不同,係數就不同:只有中位數和考卷一模一樣
for name, filled in [('中位數', df.fillna({'facebook': df['facebook'].median()})),
                     ('平均數', df.fillna({'facebook': df['facebook'].mean()})),
                     ('刪掉那一列', df.dropna())]:
    m = sm.OLS(filled['sales'], sm.add_constant(filled[cols])).fit()
    print(f'{name}:截距 {m.params["const"]:.4f},newspaper 的 p 值 {m.pvalues["newspaper"]:.3f},筆數 {len(filled)}')

df = df.fillna({'facebook': df['facebook'].median()})
X, y = df[cols], df['sales']
try:
    LinearRegression().fit(y, X)                       # 選項 A:順序反了
except ValueError as e:
    print('fit(y, X) →', str(e)[:60])
wrong = sm.OLS(sm.add_constant(X), y).fit()            # 選項 D:順序反了
print('OLS(X2, y).fit() 沒出錯,params 的形狀:', wrong.params.shape)
try:
    wrong.summary()
except ValueError as e:
    print('summary() →', e)
實際跑出來的結果
中位數:截距 3.5561,newspaper 的 p 值 0.914,筆數 200
平均數:截距 3.5540,newspaper 的 p 值 0.910,筆數 200
刪掉那一列:截距 3.5392,newspaper 的 p 值 0.883,筆數 199
fit(y, X) → Expected a 2-dimensional container but got <class 'pandas.co
OLS(X2, y).fit() 沒出錯,params 的形狀: (1, 4)
summary() → shapes (200,4) and (200,4) not aligned: 4 (dim 1) != 200 (dim 0)
錯誤訊息只印前 60 個字。fillna({'facebook': 值}) 是用字典指定「哪一欄填什麼」。
| 新出現的語法 | 是什麼 | 白話 |
|---|---|---|
df.describe().round(2) | 方法 | 8 個統計量,四捨五入到小數 2 位 |
df.isna().sum()、.equals() | 方法 | 每欄的遺漏值個數;兩個結果是否完全相同 |
getattr(df, '名字') | 內建函式 | 用文字取出物件的屬性或方法(不存在就 AttributeError) |
LinearRegression().fit(X, y) | scikit-learn | 學係數;.coef_、.intercept_ |
sm.add_constant(X) | statsmodels | 最前面加一欄 1(截距用) |
sm.OLS(y, X2).fit()、.summary()、.params、.pvalues | statsmodels | 最小平方法迴歸;報表;係數;p 值 |
§7
一頁總結+自我檢測
這個題組要帶走的 6 件事
- describe:count 不數遺漏值、mean 是平均、50% 是中位數、25%/75% 是 Q1/Q3(第 48 題 D)。
isna()和isnull()是同一個;isNaN、isnan 不存在(第 49 題 C)。- scikit-learn:
fit(X, y);statsmodels:OLS(y, X2)。 coef_只有特徵的係數(3 個),截距在intercept_;statsmodels 要add_constant。- p 值 > 0.05 就不顯著:newspaper 0.914。截距 3.5561(第 50 題 B:B、F)。
- 沒出錯不代表寫對:
OLS(X2, y).fit()照樣跑完,到 summary 才出錯。
facebook 的 count 為什麼是 199?資料有幾筆?
count 不數遺漏值,facebook 有 1 格 NaN。資料有 200 筆(shape 是 (200, 4))。
sales 的中位數是多少?16.827 是什麼?
中位數 15.48(50% 那一列);16.827 是平均(mean)。
df.isnan() 會怎樣?
AttributeError:DataFrame 沒有 isnan 這個方法。要用 df.isna() 或 df.isnull()。
scikit-learn 和 statsmodels 的參數順序各是什麼?
scikit-learn:LinearRegression().fit(X, y)。statsmodels:sm.OLS(y, X2).fit()。
print(reg.coef_) 印出幾個數字?截距在哪?
3 個(youtube、facebook、newspaper 各一);截距在 reg.intercept_,3.5561。
哪一個係數在 α=0.05 下不顯著?
newspaper,p 值 0.914。