把 NumPy 工具箱載入記憶體,取一個短名字 np。之後的 3 行完全沒有用到 np:把這一行刪掉,印出來的結果一模一樣。
import numpy模組數值計算的工具箱。SciPy 在背後會用到 NumPy,但那是 SciPy 自己載入的,和這一行無關。
as np關鍵字取別名;慣例寫成 np。
- 考卷的程式常會多寫一行
import numpy as np,是習慣,不是必要。看到 import 不代表後面一定有用到。
這題只有 4 行程式,考的是機率分佈的觀念:瑕疵品個數符合卜瓦松分佈、平均每小時 5 個,poisson.pmf(5, lambda_poisson) 算的是「剛好 5 個」的機率。四個選項各考一個容易混淆的地方:平均是不是最多、pmf 是不是「小於」、cdf 是不是「以上」,以及卜瓦松分佈的使用條件。答案是 C。這頁把 4 行程式逐行拆開,把「剛好、以下、少於、超過、以上」和 pmf、cdf、sf 一一對好,再用 10 萬小時的模擬看條件不成立時會怎樣。
pmf、cdf、sf 各算什麼:pmf 是「剛好 k 個」、cdf 是「k 個以下(含 k)」、sf 是「超過 k 個(不含 k)」。「少於 5」要寫 cdf(4),「10 個以上」要寫 sf(9)。numpy 載入了卻沒用到;poisson 不是函式而是一個「分佈物件」,pmf 是它的方法;lambda 是 Python 的保留字,所以變數叫 lambda_poisson。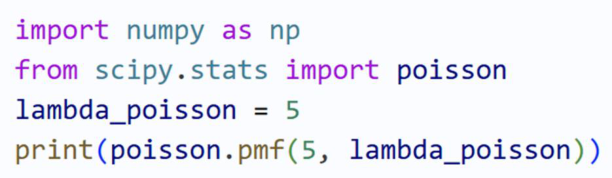
先憑直覺選一個,讀完再回來對照:
① 每小時出現瑕疵品的個數:數「一段固定時間內發生幾次」,正是卜瓦松分佈的用途。② 平均每小時 5 個:卜瓦松分佈只有一個參數 λ(平均),程式裡的 lambda_poisson = 5。③ pmf、cdf:SciPy 裡機率分佈物件的兩個方法;選項 B、D 都在考它們的意思。
本頁所有數字、輸出都是在 Python 3.13.7、SciPy 1.16.2、NumPy 2.4.3 上實際執行的結果。考卷的 4 行程式印出 0.17546736976785068。
先用「生產線上每小時數瑕疵品」把機率分佈、卜瓦松公式、使用條件講清楚,中間兩支動畫:一支在生產線上一小時一小時數,一支打開記憶體看 4 行程式各做了什麼。
每小時下線一批產品,數一數有幾個瑕疵品:這一小時 3 個、下一小時 7 個、再下一小時 5 個……每小時的個數事先不知道,所以叫隨機變數,常寫成 X。X 可能是 0、1、2、3…(整數,不會是 2.5 個)。
機率分佈就是一張表:X=0 的機率多少、X=1 的機率多少……每一格都在 0 到 1 之間,全部加起來剛好是 1。卜瓦松分佈就是其中一種常見的表。
卜瓦松分佈只有一個參數 λ(讀作 lambda):每段時間平均發生幾次。剛好發生 k 次的機率是:
e 是自然常數 2.718…,k! 是 1×2×…×k。λ=5、k=5:5⁵ × e⁻⁵ ÷ 120 = 3125 × 0.006738 ÷ 120 = 0.1755(Python 實測 0.1754673697678507)。
| k(這一小時的瑕疵品) | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| P(X = k) | 0.0067 | 0.0337 | 0.0842 | 0.1404 | 0.1755 | 0.1755 | 0.1462 | 0.1044 | 0.0653 | 0.0363 | 0.0181 |
兩件事要記住:① 卜瓦松分佈的平均和變異數都等於 λ(實測 poisson.mean(5)、poisson.var(5) 都是 5.0)。② λ 是整數時,k=λ 和 k=λ−1 的機率一樣大:剛好 4 個和剛好 5 個都是 0.1755,是最常見的兩種結果,但各自也只有約 17.5% 的機會。
卜瓦松分佈不是什麼都能套。它背後的假設是:
| 條件 | 生產線上的意思 |
|---|---|
| 事件彼此獨立 | 這個瑕疵品出現,不會讓下一個更容易或更不容易出現 |
| 平均發生率固定 | 每一小時的「平均瑕疵率」都一樣,不會上午 2、下午 8 |
| 同一瞬間最多發生一件 | 把時間切得夠細,兩個瑕疵品不會在同一瞬間出現 |
選項 C 講的就是前兩條。另一個角度:一小時生產 1,000 個零件、每個有 0.5% 的機會是瑕疵品,瑕疵品個數是二項分佈;零件很多、機率很小時,它會很接近卜瓦松分佈(實測二項分佈 P(X=5) = 0.1759,卜瓦松 0.1755)。
觀念 1~3 說到:每小時的瑕疵品個數是隨機變數,卜瓦松分佈只有一個參數 λ,而且有使用條件。動畫 1 在生產線上一小時一小時數瑕疵品,看長條怎麼慢慢貼上卜瓦松(5);再換成一條「平均發生率不固定」的生產線,看它為什麼貼不上。
帶著三個問題看:① 剛好 5 個的機率是多少?是最常見的嗎?② 平均 5 個,會不會超過 5 個?③ 平均發生率不固定時,長條變成什麼樣子?
長條的高度是 NumPy 2.4.3 實際模擬出來的比例(default_rng(0),和 §6 程式 3 同一份亂數);黑點和機率是 SciPy 1.16.2 算出來的理論值。
題目常用的中文說法,要先翻成「幾根長條加起來」,再挑對的方法:
| 中文說法 | 數學 | SciPy(λ=5) | 實測 |
|---|---|---|---|
| 剛好 5 個 | P(X = 5) | poisson.pmf(5, 5) | 0.1755 |
| 5 個以下(含 5) | P(X ≤ 5) | poisson.cdf(5, 5) | 0.6160 |
| 少於 5 個(不含 5) | P(X < 5) = P(X ≤ 4) | poisson.cdf(4, 5) | 0.4405 |
| 超過 5 個(不含 5) | P(X > 5) | poisson.sf(5, 5) | 0.3840 |
| 10 個以上(含 10) | P(X ≥ 10) = P(X > 9) | poisson.sf(9, 5) | 0.0318 |
pmf(probability mass function,機率質量函數)只看一根長條;cdf(cumulative distribution function,累積分佈函數)從 0 一路加到 k;sf(survival function,存活函數)是 cdf 剩下的部分,也就是 1 − cdf。因為個數只能是整數,「少於 5」就是「4 以下」,「10 以上」就是「超過 9」。
from scipy.stats import poisson 從 SciPy 的 stats 工具箱裡拿出一個叫 poisson 的東西。它不是函式,而是一個物件(實測型別是 poisson_gen),代表「卜瓦松分佈」這件事。pmf、cdf、sf 是它身上的方法,所以要寫成 poisson.pmf(...):點的左邊是物件,右邊是它會做的事。
變數為什麼叫 lambda_poisson 而不是 lambda?因為 lambda 是 Python 的保留字(用來寫沒有名字的小函式),不能拿來當變數名稱:實測 lambda = 5 直接出現 SyntaxError: invalid syntax。
觀念 4~5 講了 pmf、cdf、sf 的差別,和 from … import 拿出來的是一個物件。動畫 2 左邊是考卷的 4 行程式,右邊打開記憶體:numpy 模組、scipy.stats 裡的 poisson 物件和它的方法、整數 5,最後看 pmf 交回什麼。
帶著三個問題看:① 第 1 行的 np 有用到嗎?② poisson 是函式還是物件?③ 為什麼變數不叫 lambda?
型別、方法、輸出和錯誤訊息,都是 Python 3.13.7、SciPy 1.16.2 實際執行的結果。
import numpy as np 刪掉,印出來的結果一模一樣。poisson_gen。pmf、cdf、sf 是它的方法,所以寫成 poisson.pmf(...)。lambda = 5 會出現 SyntaxError: invalid syntax。SciPy 是建立在 NumPy 之上的科學計算套件,scipy.stats 是它的統計模組,裡面有一百多種機率分佈。每一種分佈都是一個物件,用法都一樣:換一種分佈,方法名稱不變。
| 方法 | 算什麼 | λ=5 的實測 |
|---|---|---|
poisson.pmf(k, mu) | 剛好 k 次的機率 P(X = k) | pmf(5, 5) → 0.17546736976785068 |
poisson.cdf(k, mu) | k 次以下的機率 P(X ≤ k) | cdf(10, 5) → 0.9863047314016171 |
poisson.sf(k, mu) | 超過 k 次的機率 P(X > k) = 1 − cdf | sf(9, 5) → 0.03182805730620481 |
poisson.ppf(q, mu) | cdf 的反過來:累積機率到 q 時是幾次 | ppf(0.95, 5) → 9.0(9 個以下的機率第一次超過 95%) |
poisson.mean(mu)、var(mu) | 平均、變異數 | 5.0、5.0 |
poisson.rvs(mu, size=…) | 照這個分佈隨機抽數字 | (模擬用,見 §6 程式 3 的 NumPy 寫法) |
參數 mu 就是 λ。方法的簽名是 pmf(k, *args, **kwds),poisson.shapes 實測是 'mu',所以 poisson.pmf(5, 5) 和 poisson.pmf(5, mu=5) 一樣。也可以先「凍結」參數:dist = poisson(5),之後寫 dist.pmf(5)、dist.cdf(10),不用每次都傳 5。
個數不會是小數:pmf(5.5, 5) 實測是 0.0;cdf(5.5, 5) 等於 cdf(5, 5)(0.6160)。
機率很小時,1 − cdf 會損失精度:1 - cdf(9, 5) 是 0.03182805730620486,sf(9, 5) 是 0.03182805730620481。
poisson.pmf(5, 5) 交回的是 NumPy 的小數型別 numpy.float64;print 出來和一般小數一樣。
左邊就是考卷的程式,一字未改。點任一行可以跳到解說;右邊往下捲時,左邊會自動標出目前講到哪一行。
把 NumPy 工具箱載入記憶體,取一個短名字 np。之後的 3 行完全沒有用到 np:把這一行刪掉,印出來的結果一模一樣。
import numpyas npimport numpy as np,是習慣,不是必要。看到 import 不代表後面一定有用到。SciPy 的 stats 模組裡有一個叫 poisson 的物件,代表卜瓦松分佈。這一行把它拿出來,之後直接用 poisson 這個名字。
scipy.statspoissonpoisson_gen 類別做出來的物件(實測 type(poisson) 是 scipy.stats._discrete_distns.poisson_gen)。身上有 pmf、cdf、sf 等方法。建立一個名字 lambda_poisson,指向整數 5。這是平均,不是上限。
lambda_poissonlambda:它是 Python 的保留字(寫匿名函式用的),實測 lambda = 5 出現 SyntaxError: invalid syntax。呼叫 poisson 的 pmf 方法:第 1 個引數 5 是 k(剛好幾個),第 2 個引數是 λ。交回的機率交給 print 印出來。
poisson.pmf(k, mu)5lambda_poissonpoisson.pmf(5, mu=5)。實驗 1 用 JavaScript 即時計算卜瓦松機率。本頁用 Node.js 跑同一段計算程式,和 SciPy 1.16.2 的 pmf、cdf、sf 比對了 λ=0.5~15(每 0.5)× k=0~40,共 3,690 個數字,相對誤差都在 10⁻⁹ 以內(畫面顯示到小數 4 位)。實驗 2 的每一根長條,是事先用 NumPy 2.4.3 實際抽出來的次數(和 §6 程式 3 同一份亂數)。
① 按「考卷的程式」:只有 k=5 那一根,0.1755。② 按「選項 B」:少於 5 是 0~4 五根加起來,0.4405,不是 pmf。③ 按「選項 D」兩個:cdf(10, 5) 塗的是 0~10,0.9863;10 個以上塗的是 10 以後,0.0318,要寫 sf(9, 5)。④ 把 λ 拉到 1:分佈擠在左邊,0 個的機率最大(0.3679);拉到 15:長條往右移、變矮、變寬,因為變異數也跟著變成 15。
卜瓦松分佈的「長相」完全由 λ 決定,平均和變異數都是 λ。「平均不固定」的那條生產線,平均一樣是 5,變異數卻有 13.98,長條兩邊高、中間低,剛好 5 個的比例只有 0.065:這時不能用 poisson.pmf(5, 5) 來算,這就是選項 C 說的「平均發生率固定」為什麼重要。
實驗 1 讓你自己選問法、看塗哪幾根。動畫 3 把四個選項一個一個塗出來:A 的「最多」、B 的「小於」、D 的「以上」各該塗哪幾根,C 的條件不成立時會怎樣。
帶著三個問題看:① 選項 B 說的「小於 5 個」要用哪個方法?② cdf(10, 5) 塗的是哪幾根?③ 為什麼 C 是對的?
每一個機率都是 SciPy 1.16.2 的 pmf、cdf、sf 實際算出來的;「平均不固定」的長條是 NumPy 2.4.3 模擬 10 萬小時的比例。
poisson.cdf(4, 5):0、1、2、3、4 五根加起來,0.4405。pmf(5, 5) 只有剛好 5 那一根。cdf(10, 5) 塗的是哪幾根?sf(9, 5),0.0318。λ 是平均,不是上限。卜瓦松分佈的 X 可以是任何非負整數:實測超過 5 個的機率 poisson.sf(5, 5) = 0.3840,10 個以上也有 0.0318。10 萬小時的模擬裡,最多的一小時出現了 18 個。
pmf 是剛好 5 個:P(X = 5) = 0.1755。小於 5 個是 0、1、2、3、4 加起來:P(X < 5) = poisson.cdf(4, 5) = 0.4405。
卜瓦松分佈描述「固定時間內發生幾次」,前提是每次發生互不影響(獨立),而且單位時間的平均發生率不變。實測:平均發生率固定的模擬,平均 4.998、變異數 5.036,和卜瓦松(5) 的 5、5 吻合;一小時 2、一小時 8 的模擬,平均 5.004 但變異數 13.975,剛好 5 個的比例 0.0648,和卜瓦松的 0.1755 差很遠。
cdf 是「以下」:poisson.cdf(10, 5) = P(X ≤ 10) = 0.9863。大於或等於 10 個要用 sf:P(X ≥ 10) = P(X > 9) = poisson.sf(9, 5) = 0.0318。兩者方向剛好相反。
| 錯誤想法 | 實際上 |
|---|---|
| 平均 5 個,所以最常出現的就是 5 個,而且很常出現 | 4 個和 5 個機率一樣大,但各自只有 17.5%;超過 5 個的機率有 38.4%。 |
| pmf 是累積的機率 | pmf 只有一根長條(剛好 k);累積的是 cdf(k 以下)。 |
「10 個以上」寫 sf(10) | sf(10) 是「超過 10」,不含 10;10 個以上要寫 sf(9),或 1 - cdf(9)。 |
poisson 是一個函式 | 它是分佈物件(poisson_gen),pmf、cdf、sf 是它的方法,所以寫成 poisson.pmf(...)。 |
| import 進來的東西一定有用到 | 考卷的 import numpy as np 完全沒用到,刪掉結果一樣。 |
三支程式都用到 SciPy(程式 3 還用到 NumPy),要先安裝:pip install scipy(會一起裝好 NumPy;Google Colab 已經內建,直接貼上就能跑)。
import math
from scipy.stats import poisson

lambda_poisson = 5
print(poisson.pmf(5, lambda_poisson))                       # 考卷的程式:剛好 5 個的機率
print(5**5 * math.exp(-5) / math.factorial(5))              # 用公式自己算一次
for k in range(11):
    print(f'k = {k:>2}:pmf {poisson.pmf(k, 5):.4f} cdf {poisson.cdf(k, 5):.4f}')
0.17546736976785068
0.1754673697678507
k =  0:pmf 0.0067 cdf 0.0067
k =  1:pmf 0.0337 cdf 0.0404
k =  2:pmf 0.0842 cdf 0.1247
k =  3:pmf 0.1404 cdf 0.2650
k =  4:pmf 0.1755 cdf 0.4405
k =  5:pmf 0.1755 cdf 0.6160
k =  6:pmf 0.1462 cdf 0.7622
k =  7:pmf 0.1044 cdf 0.8666
k =  8:pmf 0.0653 cdf 0.9319
k =  9:pmf 0.0363 cdf 0.9682
k = 10:pmf 0.0181 cdf 0.9863
第 1 行是考卷的答案,第 2 行用公式算,只差最後一位小數。k=4 和 k=5 的 pmf 一樣(0.1755);cdf 一路累加,k=10 時已經 0.9863。
from scipy.stats import poisson

mu = 5
print('A|超過 5 個 P(X > 5):', poisson.sf(5, mu))
print('B|剛好 5 個 P(X = 5):', poisson.pmf(5, mu), '|少於 5 個 P(X < 5):', poisson.cdf(4, mu))
print('D|10 個以下 P(X ≤ 10):', poisson.cdf(10, mu), '|10 個以上 P(X ≥ 10):', poisson.sf(9, mu))
print('平均、變異數:', poisson.mean(mu), poisson.var(mu))
A|超過 5 個 P(X > 5): 0.384039345166937
B|剛好 5 個 P(X = 5): 0.17546736976785068 |少於 5 個 P(X < 5): 0.44049328506521257
D|10 個以下 P(X ≤ 10): 0.9863047314016171 |10 個以上 P(X ≥ 10): 0.03182805730620481
平均、變異數: 5.0 5.0
import numpy as np
from scipy.stats import poisson

rng = np.random.default_rng(0)
hours = 100_000
steady = rng.poisson(5, size=hours)                     # 每小時的平均發生率都是 5
rate = np.where(np.arange(hours) % 2 == 0, 2, 8)        # 一小時 2、一小時 8:整體平均還是 5
unsteady = rng.poisson(rate)
for name, x in (('平均固定  ', steady), ('平均不固定', unsteady)):
    print(f'{name}:平均 {x.mean():.3f},變異數 {x.var():.3f},剛好 5 個的比例 {(x == 5).mean():.4f}')
print(f'卜瓦松(5) 理論值:平均 5,變異數 5,剛好 5 個 {poisson.pmf(5, 5):.4f}')
平均固定  :平均 4.998,變異數 5.036,剛好 5 個的比例 0.1751
平均不固定:平均 5.004,變異數 13.975,剛好 5 個的比例 0.0648
卜瓦松(5) 理論值:平均 5,變異數 5,剛好 5 個 0.1755
default_rng(0) 固定亂數,每次跑都一樣。平均固定的那條生產線,平均、變異數、剛好 5 個的比例都貼近卜瓦松(5);平均不固定的那條,平均還是 5,變異數卻接近 14。
| 新出現的語法 | 是什麼 | 白話 |
|---|---|---|
from scipy.stats import poisson | 匯入 | 從 scipy.stats 拿出 poisson 分佈物件 |
poisson.pmf(k, mu)、.cdf、.sf | 方法 | 剛好 k、k 以下、超過 k 的機率 |
math.exp(x)、math.factorial(n) | 函式 | e 的 x 次方、n 階乘 |
f'{k:>2}'、f'{p:.4f}' | f-string 格式 | 靠右占 2 格;小數 4 位 |
np.random.default_rng(0) | NumPy | 做一個固定種子的亂數產生器 |
rng.poisson(5, size=100_000) | 方法 | 照卜瓦松(5) 抽 10 萬個數字;100_000 的底線只是方便閱讀 |
np.where(條件, a, b) | NumPy 函式 | 條件成立取 a,不成立取 b(這裡:偶數小時 2、奇數小時 8) |
(x == 5).mean() | 布林陣列 | True 算 1、False 算 0,平均就是「剛好 5 個」的比例 |
pmf 剛好 k、cdf k 以下、sf 超過 k;少於 5 寫 cdf(4),10 以上寫 sf(9)。poisson 是分佈物件,pmf、cdf、sf 是它的方法;lambda 是保留字,不能當變數名。import numpy as np 沒有用到。poisson.pmf(5, 5) 算的是什麼?是多少?poisson.cdf(4, 5),0.4405。個數是整數,少於 5 就是 4 以下。poisson.cdf(10, 5) 是「10 個以上」嗎?poisson.sf(9, 5),0.0318。lambda?lambda = 5 會出現 SyntaxError。