iPAS AI 奈米級拆解程式題解說・中級科目二 115-01
Question 41 · pandas / 遺失值處理

平均 223、中位數只有 128:
右偏的收入欄缺了 5%,該拿什麼補?

這段程式只有 3 行有字:載入 pandas 工具箱、把 CSV 讀成一張表格,再從表格取一欄、算 8 個統計量、挑 3 個印出來。這頁會把每個符號講清楚(尤其是第 4 行那一串方括號和點),再用 1900 筆真的跑得出題目數字的資料,讓你親手比較平均數、中位數、最大值補值和直接刪除。最後還有一個考卷沒說的陷阱:選項裡那行補值程式,在 pandas 3 根本補不進表格。

pandas 2.2.3pandas 3.0.6NumPy read_csvDataFrameSeriesdescribe() fillna()median()NaN零基礎可讀

讀完這頁,你會知道

  1. import pandas as pd 在記憶體裡做了什麼:pandas 是一個「工具箱」模組物件,裡面有 40 張設計圖(類別)、62 台機器(函式);read_csv 是機器,DataFrame 才是設計圖,而機器在裡面照設計圖替你做出表格。
  2. 第 4 行 print(df['daily_earnings'].describe()[['mean', '50%', 'max']]) 的執行順序:從裡到外、從左到右,中途生出 3 個沒有名牌的物件;單層和雙層方括號差在哪。
  3. describe 的 8 個數字各是什麼(count 為什麼是 1900、50% 怎麼用線性內插算),以及右偏資料裡平均數為什麼會被少數人拉走。
  4. 四種處理(平均數、中位數、最大值補值、整列刪除)實際把資料變成什麼樣;選項那行 fillna(..., inplace=True) 在 pandas 3 為什麼改不到 df,以及兩種一定有效的寫法。
§0

題目

請依照共享乘車平台 driver_daily_stats.csv 情境作答: 欄位包含 driver_id、daily_earnings、region、app_version、gps_ping_rate;其中 gps_ping_rate 可能被外掛竄改,外掛司機比例極低。 資料分析師使用 Python 檢視 daily_earnings 欄位的基本統計量,執行以下程式碼(Pandas2 以上版本):
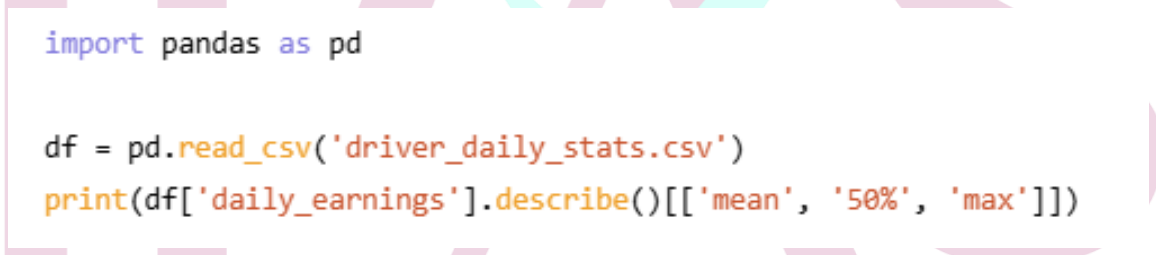
第 41 題原始程式碼截圖:import pandas as pd;df = pd.read_csv('driver_daily_stats.csv');print(df['daily_earnings'].describe()[['mean', '50%', 'max']])
原卷附圖(程式碼已在 §3 完整重打一份)
輸出結果如下: ● mean:223.411306 ● 50%:128.552462 ● max:4500.000000 若團隊進一步發現 daily_earnings 欄位約有 5%的遺失值,且目前規劃先建立線性迴歸(Linear Regression)模型來預測未來收入。為盡可能保留該欄位原有分布特性,並降低因補值造成的偏差,請問下列哪一種處理方式最為合理?

先憑直覺選一個,讀完再回來對照:

先抓題目的六個關鍵字

① 右偏:平均 223 遠大於中位數 128,代表有少數人收入特別高,把平均往上拉。② 極端值 max 4500:最高的那位是中位數的 35 倍。③ 約 5% 遺失:2000 位司機裡大約 100 格是空的。④ 線性迴歸:之後要建模,而模型不收空格(scikit-learn 會直接報錯),所以非處理不可。⑤ 保留分布特性:補完以後,資料的「形狀」(中間在哪、高低怎麼分布)不要被改太多。⑥ 降低偏差:補進去的值不要整體偏高或偏低。

關於本頁用的資料與版本

考卷沒有附 CSV。本頁用程式造了一份模擬資料 driver_daily_stats.csv:2000 位司機 × 5 欄,daily_earnings 用右偏的分布產生,再微調到題目那三個數字完全一樣(mean 223.411306、50% 128.552462、max 4500);其中 100 格(剛好 5%)完全隨機留空;gps_ping_rate 也照情境放了 1 位外掛司機。§6 可以下載。

本頁所有數字、輸出、警告和錯誤訊息,都是在 Python 3.13.7 上實際執行的結果,而且 pandas 2.2.3(NumPy 2.4.3)和 pandas 3.0.6(NumPy 2.5.4)兩個版本都跑過;兩版不一樣的地方會分開寫。

§1

先補 Python 基本功:讀懂這 3 行需要的 6 個觀念

程式雖然只有 3 行,第 4 行卻把「物件導向」最常用的動作全擠在一起:跟物件要東西、叫物件做事、再要東西、印出來。完全沒寫過 Python 也沒關係,下面每個觀念都直接用本題舉例,中間還有一支動畫把記憶體打開給你看。

① import觀念 1
工具箱與名牌
→
② 類別與物件觀念 2
設計圖與表格
→
③ 記憶體實況動畫 1
三行生出幾個物件
→
④ 方括號・點・順序・NaN觀念 3~6

動畫 2(平均數 vs 中位數)放在 §2,動畫 3(補值)放在 §4,各自和相關的說明、互動實驗放在一起。

觀念 1|import … as …:把 pandas 工具箱搬進記憶體,貼上名牌 pd

Python 本身不會讀表格。要分析 CSV,得借用別人寫好的套件(package)。pandas 就是一個用 pip install pandas 裝在硬碟上的套件,裡面有一千多個 .py 檔(實測 2.2.3 有 1411 個、3.0.6 有 1421 個)。程式要用它,得先用 import 把它載入記憶體。

先建立三個畫面,這一頁和三支動畫都會用到:

記憶體=一大排置物櫃

每一格都有自己的地址(例如 0x19cd74ad210)。程式做出來的每樣東西(物件),都住在某一格裡。

變數=一張名牌

程式裡寫的 pd、df 只是名牌。名牌不是東西本身,它只負責「指著」某個東西。

參照=名牌拉出去的箭頭

名牌用一條箭頭指向置物櫃裡的物件。兩張名牌可以指同一個物件;沒有任何名牌指著的物件,Python 會把那一格收回來再利用。

執行 import pandas as pd 時,Python 依序做四件事

  1. 查「已載入清單」:Python 有一本清單叫 sys.modules,記錄已經載入過的套件。第一次執行時,清單裡還沒有 pandas。
  2. 執行 pandas 的程式碼:把硬碟上 pandas 資料夾裡的程式跑一遍(它自己還會再 import NumPy 等套件),在記憶體做出一個「模組物件」。本頁實測約 0.4~0.6 秒。
  3. 登記到清單:把這個模組物件記進 sys.modules,同一支程式再 import 一次,就直接拿同一個,不會再做一個。
  4. 綁名牌:建立名字 pd,箭頭指向這個模組物件。注意:名牌上只寫 pd,不會有 pandas 這個名字。

模組物件=一個裝好的工具箱

pandas 本身不是設計圖。它是照 Python 內建的 module 類別做出來的一個物件(type(pd) 的答案是 <class 'module'>),裡面裝滿了 pandas 團隊寫好的東西。工具箱裡的公開名稱(不算底線開頭的)分成四種,下面是實際數出來的數量:

種類是什麼用法pandas 3.0.6pandas 2.2.3例子
子工具箱(模組)箱中箱,裡面再放東西用點往裡面走:pd.io1212io、api、plotting、errors
設計圖(類別)照它可以做出物件加括號建立物件:pd.DataFrame({...})4041DataFrame、Series、Index、Timestamp
機器(函式)丟材料進去,吐成品出來加括號呼叫:pd.read_csv('a.csv')6261read_csv、concat、merge、to_datetime
現成物件(實例)import 時就做好的成品直接拿來用55NA、NaT、options、IndexSlice

兩版差在:option_context 在 2.2 是類別、在 3.0 改成函式;3.0 另外新增 col、read_iceberg 兩台機器,拿掉了 read_gbq、value_counts。

import 的幾種寫法:差別只在名牌綁在哪

寫法記憶體裡多了什麼名牌之後怎麼叫 read_csv
import pandaspandas → 工具箱pandas.read_csv(...)
import pandas as pd(本題)pd → 同一個工具箱(沒有 pandas)pd.read_csv(...)
from pandas import read_csvread_csv → 直接指到工具箱裡那台機器read_csv(...)(不用寫 pd.)
from pandas import DataFrameDataFrame → 直接指到那張設計圖(這種寫法拿不到 read_csv)

每一種寫法都會載入整個 pandas 工具箱,差別只在名牌貼在哪裡。點(.)的意思是「打開它,往裡面找」:pd.read_csv 就是「名牌 pd 指的工具箱 → 拿出 read_csv」。as pd 是約定俗成的綽號,pandas 官方文件和幾乎所有教學都這樣寫,看到 pd. 就知道是 pandas。

觀念 2|類別與物件:DataFrame 是設計圖,df 是照著做出來的那張表

類別(class)是一張設計圖,規定照它做出來的東西有哪些資料、會做哪些動作。物件(object)是照設計圖實際做出來的那一個,也叫實例(instance)。在 Python 裡,類別名稱後面加上小括號,就是「照設計圖做一個出來」:

pd.DataFrame                                 # 設計圖(類別本身),還不是表格
pd.DataFrame({'a': [1, 2]})                  # 加括號 = 照設計圖做出一張表格物件
df = pd.read_csv('driver_daily_stats.csv')   # 本題:叫一台機器在裡面替你做一張

本題第 3 行沒有直接寫 DataFrame(...),而是呼叫 read_csv。read_csv 是一台機器(函式),不是設計圖:type(pd.read_csv) 的答案是 <class 'function'>。那表格物件到底是誰做的?打開 pandas 原始碼(兩個版本這部分都一樣),沿著 read_csv 往裡面走:

pd.read_csv('driver_daily_stats.csv') → _read(...) 讀檔前的準備 → parser = TextFileReader(...) 又一張設計圖(放在 pandas.io.parsers):先做出一個「讀檔員」物件 → parser.read(nrows) 叫讀檔員的 read 方法做事:切欄、判斷型別… df = DataFrame( ← 就是這一行:照 DataFrame 設計圖做出表格 new_col_dict, columns=columns, index=index, …) → return df 交回給你,第 3 行再把名牌 df 貼上去

所以:每一個實例,一定是照某一張設計圖做出來的。你可以自己拿設計圖加括號,也可以呼叫一台機器、由它在裡面替你做,但追到最後都有一張設計圖。用 type() 問任何東西「你是哪張設計圖做的」(以下都實際執行過):

東西怎麼來的type() 的答案(它的設計圖)
'driver_daily_stats.csv'直接寫出來,Python 自動做好str(字串)
pdimport 時 Python 做的module
pd.read_csv機器本身也是一個物件function
pd.DataFrame設計圖本身也是一個物件type(「設計圖的設計圖」)
dfread_csv 在裡面用 DataFrame(...) 做的pandas.DataFrame(2.2 顯示 pandas.core.frame.DataFrame)
df['daily_earnings']表格交出來的一欄pandas.Series(2.2 顯示 pandas.core.series.Series)
….describe() 的結果describe 方法在裡面用 Series(...) 做的Series
…[['mean', '50%', 'max']] 的結果從上一個 Series 挑出來,另外做一個Series
….describe()['mean']單層方括號,只拿一個值numpy.float64(一個數字)
print(...) 的回傳值印完交回來的東西NoneType(就是 None,「什麼都沒有」)
怎麼一眼看出誰是類別?

Python 社群的命名慣例(PEP 8):類別用大寫開頭的駝峰式(DataFrame、Series、TextFileReader),函式、方法、變數、模組用小寫(read_csv、describe、fillna、df、pd)。這不是語法規定,但 pandas 的主要類別都遵守(少數例外:2.2 的 option_context 是小寫的類別,到 3.0 才改成函式)。所以 pd.read_csv(...) 一看就知道是「呼叫機器」,pd.DataFrame(...) 是「照設計圖做物件」。

兩個版本的 type() 為什麼長得不一樣?

pandas 3 把公開類別顯示成 pandas.DataFrame;2.2 顯示它真正住的子工具箱 pandas.core.frame.DataFrame。是同一張設計圖,只是門牌寫法不同:兩版 isinstance(df, pd.DataFrame) 都是 True。

觀念 1、2 講的工具箱、設計圖、名牌和箭頭,下面的動畫 1 會在記憶體裡一步一步畫出來:三行程式跑完,記憶體裡到底多了幾個物件、哪些有名牌、哪些沒有。

看動畫 1 之前:這支要回答什麼

觀念 1、2 講了工具箱、設計圖、機器和表格物件。動畫 1 把這三行程式真的跑一遍,一行一行畫出記憶體裡多了什麼:左邊是名牌(變數),中間是記憶體(一格一格的置物櫃),右邊是記憶體外面的硬碟和螢幕。

帶著三個問題看:① import 之後,記憶體裡多了什麼?pd 指著誰?② read_csv 是設計圖還是機器?表格物件是照哪一張設計圖做的?③ 第 4 行一共做出幾個新物件?印完以後,還有名牌的是哪幾個?

看的時候抓五種樣子:灰色虛線框是模組物件(工具箱)、黃色小卡是類別(設計圖)、藍色小卡是函式(機器)、綠色格子是物件、紅色名牌是名字。

動畫 1打開記憶體:三行程式生出幾個物件2 分 31 秒・有旁白,也有字幕

畫面上的位址、型別取自一次真實執行(Python 3.13.7、pandas 3.0.6);每台電腦、每次執行的位址都不一樣,這是正常的。pandas 2.2.3 只有兩處不同:type(df) 會顯示完整路徑 pandas.core.frame.DataFrame;df['daily_earnings'] 交出的那一欄會被 df 暫存起來(item cache),印完不會被回收。工具箱裡的 40 張設計圖、62 台機器只畫了幾張代表。

看完動畫 1,你應該能回答:pd 是設計圖嗎?
不是。pd 是一張名牌,指著 pandas 這個模組物件(工具箱),type(pd) 是 module。設計圖是工具箱裡的 DataFrame、Series 這些類別。
read_csv 是類別嗎?表格物件是誰做出來的?
read_csv 是函式(機器),type(pd.read_csv) 是 function。它讀完硬碟上的檔案,在裡面呼叫 DataFrame(…),照 DataFrame 類別做出表格物件。物件(實例)一定是照某個類別做出來的,函式只是幫你去「叫」那個類別。
名牌 df 是什麼時候綁上去的?
等號右邊全部做完(讀檔、做出表格物件)之後,最後才執行等號,把 df 綁到那個表格物件上。
第 4 行一共做出幾個新物件?
三個 Series:① df['daily_earnings'] 交出的一欄(2000 格)→ ② .describe() 交出的 8 個統計量 → ③ [['mean','50%','max']] 挑出的 3 格。最後 print 把第 ③ 個轉成文字印到螢幕,print 自己交回 None。
為什麼 describe 的 count 是 1900,不是 2000?
describe 會跳過 NaN(空格)。daily_earnings 有 100 個 NaN,所以只用 1900 個數字計算。
印完以後,記憶體裡還有名牌的是哪幾個?
只有 pd(指著工具箱)和 df(指著表格)。三個中途的 Series 沒有名牌指著,pandas 3 實測會被 Python 回收。

觀念 3|方括號的三種意思:做清單、跟物件要東西、一次要好幾樣

第 4 行有 3 對方括號,意思不只一種。Python 看的是方括號前面有沒有緊貼著東西:

長相前面有東西嗎意思本題例子
[a, b, c]沒有,自己獨立出現做一個清單(list):有順序的一排東西['mean', '50%', 'max']
物件[鑰匙]有,緊貼在物件後面跟這個物件要東西:Python 會去呼叫物件的 __getitem__ 方法df['daily_earnings']
物件[[a, b]]有外層是「要東西」,內層是清單:一次要好幾樣…[['mean', '50%', 'max']]

df['daily_earnings'] 其實是 df.__getitem__('daily_earnings') 的簡寫(實測兩種寫法拿到的那一欄完全相同)。__getitem__ 是寫在 DataFrame 設計圖裡的方法:你給它一個欄名當鑰匙,它交出那一欄。動畫 1 裡,第 4 行的第 ① 步就是 df 收到鑰匙、交出一個新的 Series 物件。

單層和雙層:交出來的東西不一樣

desc = df['daily_earnings'].describe()   # 先把 8 個統計量貼上名牌 desc

desc['mean']                    # 鑰匙是一個字串 → 交出一個數字
# np.float64(223.41130600000002)

desc[['mean', '50%', 'max']]    # 鑰匙是一個清單 → 交出一個新的 Series
# mean     223.411306
# 50%      128.552462
# max     4500.000000
# Name: daily_earnings, dtype: float64

同樣的規則也用在表格上:df['daily_earnings'] 交出 Series(一欄,2000 格);df[['daily_earnings']] 交出 DataFrame(只有一欄的表格,形狀 (2000, 1))。

為什麼是 223.41130600000002 而不是 223.411306?電腦用二進位存小數,有極微小的誤差;print 的時候 pandas 只顯示到小數點後 6 位(顯示設定 display.precision 預設 6,實測),所以你在題目輸出看到的是 223.411306。

最容易寫錯:少了內層方括號

desc['mean', '50%', 'max'] 裡面那三個用逗號分開的東西,Python 會打包成一個 tuple元組:用逗號分開的一組東西,例如 ('mean', '50%')。和 list 很像,但不能修改。,pandas 拿這「一整組」當一把鑰匙去找,實測錯誤:KeyError: 'key of type tuple not found and not a MultiIndex'。要一次拿好幾個,鑰匙必須是清單:[['mean', '50%', 'max']]。

觀念 4|點、方法、方法串接:每一步都交出一個新物件

點(.)讀成「的」:df.shape 就是「df 的 shape」。點後面接的東西分兩種:

屬性:沒括號,讀物件身上的資料

df.shape → (2000, 5)
df.columns → 5 個欄名
col.name → 'daily_earnings'
col.dtype → float64

方法:有括號,叫物件做事

df.head() → 前 5 列
col.describe() → 8 個統計量
col.median() → 中位數
col.isna() → 每格是不是空的

(col 指的是 df['daily_earnings'] 那一欄。)括號加錯會怎樣?實測:df.shape() 出現 TypeError: 'tuple' object is not callable,因為 shape 是一組數字,不是機器;col.describe 忘了括號,不會出錯但也不會算,只交出方法本身,印出來是 <bound method NDFrame.describe of …>。

方法寫在設計圖上,而且可以「繼承」

方法其實是「綁在物件身上的函式」,寫在設計圖裡。col 自己身上並沒有 describe,Python 會沿著它的設計圖一路往上層找,這條路線叫 MROMethod Resolution Order:找方法的順序。Python 先找物件自己的類別,找不到就往上層類別找。(實測,兩版相同):

Series → IndexOpsMixin → OpsMixin → NDFrame → PandasObject → DirNamesMixin → IndexingMixin → object DataFrame → NDFrame → PandasObject → DirNamesMixin → IndexingMixin → OpsMixin → object describe、fillna、head 都寫在 NDFrame 這一層 mean、median、max、dropna 是 Series 自己另外寫的

NDFrame 是 Series 和 DataFrame 共同的上層類別。子類別自動擁有上層類別寫好的東西,這叫繼承。因為 describe、fillna 寫在 NDFrame,所以「一欄」和「整張表」都能用(df.describe() 也可以,§3 會看到)。實測 pd.Series.describe is pd.DataFrame.describe 是 True:兩邊找到的是同一個方法。

方法串接:點左邊交出什麼,點右邊就是「那個物件」的方法

讀到哪裡這時候手上的東西它的設計圖
df整張表格(2000 列 × 5 欄)DataFrame
df['daily_earnings']一欄,2000 格Series
….describe()8 個統計量Series(新的一個)
…[['mean', '50%', 'max']]3 個統計量Series(又一個新的)
print(…)螢幕上出現 4 行字;交回 NoneNoneType

每一步都是做一個新物件交出來,不會改到前一個:實測 col.describe() is col 是 False,describe 完 col 還是原本那 2000 格。動畫 1 裡第 4 行每走一步,記憶體就多一格新的 Series,就是這個意思。

觀念 5|執行順序:從裡到外、從左到右、等號最後

一行裡有好幾件事的時候,Python 的規則是:括號裡面的先算好,同一層由左往右;算好的結果再交給外面那一層。有等號的話,右邊全部做完,最後才把名牌貼上去。

第 3 行:df = pd.read_csv('driver_daily_stats.csv')

步驟做什麼結果
1找到名牌 pd 指的東西pandas 工具箱(模組)
2.read_csv:從工具箱拿出那台機器一個函式(還沒開動)
3'driver_daily_stats.csv'一個字串
4( … ):開動機器:讀檔、切欄、做表格一個 DataFrame 物件(這時還沒有名牌)
5df =:最後才把名牌 df 綁上去df → 那張表格

第 4 行:拆成 ①②③④

① df['daily_earnings']Series:2000 格
其中 100 格 NaN
→
② .describe()新的 Series:8 格
count … max
→
③ [['mean', '50%', 'max']]新的 Series:3 格
→
④ print( … )螢幕上 4 行字
回傳 None

第 4 行沒有等號,所以 ①②③ 做出來的三個 Series 都沒有名牌,只是一路傳下去。動畫 1 最後一段就在講:print 結束後,沒有任何名牌指著它們,它們的置物櫃會被收回。

深入一點:用 dis 看 Python 真正的步驟(可以先跳過)

Python 內建的 dis 模組可以把一行程式拆成直譯器實際執行的指令。下面是 Python 3.13 對第 4 行的實測輸出(節錄,右邊的中文是本頁加的註解):

import dis
dis.dis("print(df['daily_earnings'].describe()[['mean', '50%', 'max']])")

LOAD_NAME                0 (print)              # 先找到 print 這台機器(還沒開動)
PUSH_NULL
LOAD_NAME                1 (df)
LOAD_CONST               0 ('daily_earnings')
BINARY_SUBSCR                                   # ① df['daily_earnings']
LOAD_ATTR                5 (describe + NULL|self)
CALL                     0                      # ② .describe()
BUILD_LIST               0
LOAD_CONST               1 (('mean', '50%', 'max'))
LIST_EXTEND              1                      # 做出清單 ['mean', '50%', 'max']
BINARY_SUBSCR                                   # ③ 用清單去要東西
CALL                     1                      # ④ 這時候才真的開動 print
RETURN_VALUE

所以嚴格說,Python 一開始就「查到」print 這個名字了,但真正「開動」print 一定是最後一步。「從裡到外」說的是開動的順序:外面的機器要等括號裡的材料全部備好才能開工。第 3 行用 dis 看也一樣:CALL 1(開動 read_csv)之後才是 STORE_NAME 2 (df),也就是最後才貼名牌。

觀念 6|NaN 與「跳過空格」:為什麼 count 是 1900 不是 2000

CSV 的第 2 行是 D0001,,A,5.3.1,1.0:兩個逗號中間什麼都沒有。pandas 讀進來,會在那一格放一個 NaN(Not a Number,「不是數字」)。NaN 是電腦浮點數標準(IEEE 754)裡的一個特殊值,pandas 拿它代表「這格沒有值」。

你問答案(實測)白話
len(col)2000一共 2000 格,空格也算
col.isna().sum()100isna() 交出 2000 個 True/False,加總時 True 算 1,所以有 100 格是 NaN
col.count()1900有數字的格子
col[0]np.float64(nan)第 1 位司機 D0001 的收入是空的;NaN 本身也是一個 float64
np.nan == np.nanFalseNaN 跟誰都不相等,連自己也不等,所以判斷空格要用 isna(),不能用 ==
col.mean()223.41130600000002預設 skipna=True:跳過 100 個空格,只用 1900 個數字算
col.mean(skipna=False)nan不跳過:只要有一格是 NaN,結果就是 NaN

所以 describe 的 count 是 1900,mean、50%、max 也都只用那 1900 個數字算。但是「跳過」不等於「補好」:df 裡那 100 格還是空的,直接丟進線性迴歸會出錯(scikit-learn 1.8.0 實測:ValueError: Input y contains NaN.,收入放在特徵那邊則是 Input X contains NaN.)。這就是題目要你選一種處理方式的原因。

這 100 個空格長什麼樣子、該怎麼補,§4 的動畫 3 會畫給你看。

把 6 個觀念串起來:本題的「類別 → 物件 → 方法」路線

① 類別(設計圖)DataFrame、Series 放在 pandas 工具箱裡,L1 用 import 貼上名牌 pd
(讀檔員 TextFileReader 放在子工具箱 pandas.io.parsers)
→
② 建立物件(照設計圖做)L3:read_csv 在裡面 DataFrame(...) 做出表格,最後貼名牌 df
L4:每一步又做出一個新的 Series(沒有名牌)
→
③ 跟物件要東西、叫它做事df[…](__getitem__)、.describe()、[[…]]
最後交給 print() 印出來
§2

認識這次登場的框架:pandas、NumPy 和 CSV 檔

pandas
Python 最常用的表格資料分析套件

2008 年由 Wes McKinney 在一家投資公司開始開發,2009 年開源。名字來自計量經濟學的 panel data(面板資料)。負責:讀寫各種檔案(CSV、Excel、SQL 資料庫…)、整理表格、處理缺值、分組統計。

比喻:一本會自己算帳的試算表,只是用程式操作,幾百萬列也照樣處理。

NumPy
Python 數值計算的地基

2005 年由 Travis Oliphant 整合早期的 Numeric 與 Numarray 而成。核心是 ndarray:一整排同一種型別的數字,運算非常快。pandas 每一欄的數字底下就是一個 NumPy 陣列:實測 col.to_numpy() 的型別是 numpy.ndarray、dtype 是 float64。

本題會看到的 NumPy 東西:float64(64 位元的小數)、np.float64(單一個小數)、np.nan(缺值)。

CSV 檔
Comma-Separated Values:用逗號分欄的純文字檔

一行一列,第一行通常是欄名;用記事本就能打開。本題資料的前 4 行(原始文字):

driver_id,daily_earnings,region,app_version,gps_ping_rate D0001,,A,5.3.1,1.0 D0002,21.438655,C,5.4.0,0.943 D0003,255.924079,B,5.3.1,1.017

第 2 行的 ,, 中間沒東西:這就是一個空格(遺失值)。

pandas 工具箱的「貨架配置圖」:本題用到哪幾格

pandas(模組,L1 貼上名牌 pd) ├─ DataFrame 設計圖:整張表格 ← L3 的 df 就是它的實例 ├─ Series 設計圖:一欄(一排值+一排標籤)← df['daily_earnings']、describe() 的結果 ├─ Index 設計圖:標籤 ← 欄名、'count' 'mean' … 這些名字 │ └─ RangeIndex 0, 1, 2 … 1999 這種連號標籤(Index 的子類別) ├─ read_csv() 機器:讀 CSV → 交出 DataFrame ← L3 ├─ read_excel()、read_json()、read_sql() … 其他讀檔機器 ├─ concat()、merge()、to_datetime() … 合併表格、轉日期 ├─ NA、NaT 現成物件:pandas 自己的缺值記號 └─ io、api、plotting …(子工具箱)

一張 DataFrame 可以想成「好幾個 Series 並排,共用同一排列標籤」:

driver_id daily_earnings region app_version gps_ping_rate ← df.columns:5 個欄名(Index) 0 D0001 NaN A 5.3.1 1.000 1 D0002 21.438655 C 5.4.0 0.943 2 D0003 255.924079 B 5.3.1 1.017 3 D0004 133.313945 C 5.2.0 0.948 4 D0005 116.975976 B 5.3.1 0.827 ↑ df.index:RangeIndex(start=0, stop=2000, step=1),0~1999 的列標籤 每一個直欄單獨拿出來,就是一個 Series

上面是 df.head()(前 5 列)的實際輸出。注意 CSV 裡 D0001 的 gps_ping_rate 寫的是 1.0,pandas 顯示成 1.000,只是為了讓同一欄的小數點對齊。

這題會碰到的 pandas 2 與 pandas 3 差異

題目寫「Pandas2 以上版本」。好消息是:題目那三個數字,兩版印出來一模一樣。但選項裡的補值寫法,兩版的結果不同。下表全部實測:

項目pandas 2.2.3pandas 3.0.6對本題的影響
Copy-on-Write寫入時才複製:從表格拿出來的東西,一開始和表格共用資料;一旦有人要修改它,pandas 先替它複製一份再改,原本的表格不受影響。預設關閉(mode.copy_on_write 是 False)永遠開啟(這個設定已淘汰,關不掉)選項寫法 df[…].fillna(…, inplace=True):2.2 有補到但跳 FutureWarning;3.0 補不到 df(§5)
文字欄的 dtypeobjectstrdriver_id、region、app_version 顯示不同;數字欄兩版都是 float64
fillna 的參數value 可省略,還有 method、downcastvalue 必填,method、downcast 移除題目只用 value 和 inplace,兩版都能執行
fillna(…, inplace=True) 的回傳值None被改的那個物件自己§5 的實驗會看到
describe(percentiles=[…])一定自動補上 50%給什麼就算什麼題目沒寫 percentiles,兩版都是 25%、50%、75%
同一欄拿兩次:df['x'] is df['x']True(df 會暫存那一欄)False(每次都做一個新的 Series)動畫 1 最後「物件被回收」那一段
type(df) 的顯示pandas.core.frame.DataFramepandas.DataFrame同一張設計圖,只是門牌寫法不同
read_csv 的參數個數49 個44 個3.0 拿掉 5 個舊參數,本題都沒用到
用位置寫 col.mean(0)正常會跳 Pandas4Warning:之後只能寫 axis=0本題沒有傳參數

describe 的 8 個數字,一個一個看

df['daily_earnings'].describe() 的完整輸出(兩版相同)。題目只挑了其中 mean、50%、max 三個:

count 1900.000000 mean 223.411306 std 314.383784 min 2.714220 25% 63.244931 50% 128.552462 75% 268.723376 max 4500.000000 Name: daily_earnings, dtype: float64
標籤數值白話怎麼算出來的
count1900有數字的格子有幾個NaN 不算。顯示成 1900.000000,是因為 describe 把 8 個數字裝進同一個 float64 的 Series,大家都變成小數
mean223.411306平均數1900 個數字加總 424,481.4814 ÷ 1900
std314.383784標準差:大家離平均「平均有多遠」,越大代表高低差越大樣本標準差把每個人和平均的差平方、加總,再除以 n−1(不是 n),最後開根號。除以 n−1 是統計學上推估母體時的慣例。,除以 n−1 = 1899(pandas 預設 ddof=1);如果除以 n,會是 314.301040
min2.714220收入最少的一位跳過 NaN 後的最小值
25%63.244931第 1 四分位數:四分之一的人比它少線性內插(見下表)
50%128.552462中位數:一半的人比它少排好隊後第 950、951 位的平均
75%268.723376第 3 四分位數:四分之三的人比它少線性內插
max4500.000000收入最多的一位跳過 NaN 後的最大值

為什麼剛好是這 8 個?打開 pandas 原始碼(describe_numeric_1d 函式),它就是依序呼叫這一欄的 count()、mean()、std()、min()、quantile([0.25, 0.5, 0.75])、max(),再用 Series(…) 設計圖把 8 個數字裝成一個新的 Series,標籤就是 'count'、'mean'…'max'。所以題目才能用 '50%' 這個標籤把中位數拿出來。

百分位數怎麼算:排好隊,照「位置」找人(線性內插)

先把 1900 個數字由小到大排好。第 p 百分位數的「位置」= p ×(1900 − 1),從 0 開始數(Python 的習慣)。位置剛好是整數就直接取那個人;有小數,就在前後兩個人之間照比例取值,這叫線性內插,是 pandas quantile 的預設(interpolation='linear')。本頁用手算和 pandas 對過,結果完全相同:

百分位位置夾在哪兩位中間計算結果
25%0.25 × 1899 = 474.75第 475 位 63.038781、第 476 位 63.31364763.038781 + 0.75 × (63.313647 − 63.038781)63.2449305
50%0.5 × 1899 = 949.5第 950 位 128.386711、第 951 位 128.718213剛好在正中間:兩人平均128.552462
75%0.75 × 1899 = 1424.25第 1425 位 268.718947、第 1426 位 268.736661268.718947 + 0.25 × (268.736661 − 268.718947)268.7233755

「第 475 位」就是位置 474:位置從 0 數起,所以人數要加 1。describe 印出來時四捨五入到小數點後 6 位,所以 63.2449305 顯示成 63.244931。

平均數 vs 中位數:誰會被一個人拉走?

兩個都是在回答「一般司機一天賺多少」,算法卻完全不同:

中位數=站在正中間的那個人

讓所有人照收入由少到多排成一列,站在正中間那個人的收入就是中位數。人數是偶數時,取中間兩個人的平均。它只在乎「誰站在中間」,不在乎最右邊的人站多遠。

平均數=蹺蹺板的支點

把收入全部加起來平分。也可以想成:每個人照收入站在一根長蹺蹺板上(收入越高站越右邊),平均數就是讓蹺蹺板剛好平衡的支點。站得越遠的人,力氣越大。

先用 9 個人看

9 位司機的日收入:40、70、95、110、128、150、190、260、4500。

情況中位數(第 5 位)平均數
最後一位是 3001281343 ÷ 9 = 149.22
最後一位是 45001285543 ÷ 9 = 615.89

只動了一個人,平均數就從 149.22 跳到 615.89,9 個人裡有 8 個的收入都比這個「平均」低;中位數則紋風不動,還是 128。因為平均數要把每個數字都加進去,一個極端值就能把支點拉走;中位數只看排在中間的人。§4 第一個互動實驗可以拖滑桿自己試。

再看真實的 1900 位司機

  • 平均 223.41,但有 70.6%(1341 人)的司機收入低於平均;低於中位數的剛好 50%(950 人)。
  • 偏態係數skewness:描述分布左右對不對稱的數字。0 代表對稱;正數代表右邊拖著一條長尾巴(右偏);常見的經驗法則是超過 1 就算明顯偏斜。(col.skew())是 5.17:0 代表左右對稱,這份資料非常右偏。
  • 收入 1000 元以上有 50 人,2000 元以上只有 10 人;最高的 5 位是 2644.67、3245.05、3420.09、3479.72、4500.00。
  • 只拿掉最高的 5 位(佔 0.26%):平均 223.41 → 214.88,中位數 128.55 → 128.23。
  • 如果最高那位從 4500 打錯成 45000:平均變成 244.73,中位數一點都沒變(還是 128.552462)。

這種「大部分人擠在左邊,少數人拖出一條長長的右尾巴」的形狀叫右偏(正偏)。收入、房價、消費金額幾乎都是右偏。右偏的時候平均數會大於中位數,平均數就不太能代表「一般人」;這也是題目給你 mean、50%、max 三個數字的用意:223 > 128,而且 max 高達 4500。

看動畫 2 之前:這支要回答什麼

上面用數字說明了平均數和中位數。動畫 2 把它們畫成兩個看得見的東西:中位數=排隊時站在正中間的人,平均數=讓長尺保持平衡的支點。先用 9 位司機的小例子,再換回本題 1900 位司機的真實分布。

帶著兩個問題看:① 最右邊那位司機從 300 變成 4500,支點(平均)和中間那位(中位數)各移動多少?② 真實資料裡,為什麼有 70.6% 的司機賺得比平均少?

看的時候盯著兩個顏色:黃色是平均數,綠色是中位數。

動畫 2平均數 vs 中位數:誰會被一個人拉走1 分 59 秒・有旁白,也有字幕

9 位司機是為了好懂而編的小例子;直方圖是本頁模擬資料 driver_daily_stats.csv 裡 1900 個非空值的真實分布,每 25 元一根柱子,1000 元以上的 50 人合成右邊一根。

看完動畫 2,你應該能回答:最右邊那位從 300 變成 4500,平均和中位數各變多少?
平均從 149.22 被拖到 615.89(比 9 個人裡的 8 個都高);中位數一直是 128,因為站在中間的還是同一個人。
什麼叫「右偏」?右偏時平均和中位數誰比較大?
大多數人擠在左邊,少數很大的值把尾巴拖到右邊,叫右偏。右偏時平均會被尾巴往右拉,所以平均 > 中位數(本題 223.41 > 128.55)。
70.6% 的司機賺得比平均少,代表什麼?
平均被少數高收入(最高 4500)拉高了,已經不能代表「一般司機」;中位數左右剛好各一半(各 950 人),比較能代表一般司機。
§3

逐行解剖

左邊是完整程式(點任一行可以跳到解說),右邊往下捲時,左邊會自動標出目前講到哪一行。第 4 行很長,拆成 5 張卡:先看全貌,再一步一步看。手機上會改成上下排列。

q41.py4 行

把裝在電腦裡的 pandas 套件整個載入記憶體,之後用 pd 這個短名字叫它。

逐字拆解

import
關鍵字「把後面那個套件載入進來」。
pandas
套件要先安裝才有(pip install pandas;Anaconda 和 Google Colab 已經裝好)。名字全部小寫,Python 分大小寫。
as
關鍵字「取綽號」,後面接你想用的名字。
pd
名牌之後程式裡的 pd 就是指這個工具箱。pd 是全世界通用的慣例,不是規定,取別的名字也能跑。

這一行執行時發生什麼事

照 §1 觀念 1 的四步:查 sys.modules → 執行 pandas 的程式碼、做出模組物件 → 登記 → 貼上名牌 pd。

執行後多了: pd → <module 'pandas' from '…\\site-packages\\pandas\\__init__.py'> type(pd) → <class 'module'> ← 一個模組物件(工具箱),不是設計圖 pd.__version__ → '2.2.3' 或 '3.0.6' ← 看你裝哪一版 pd.read_csv → 工具箱裡的一台機器(function) pd.DataFrame → 工具箱裡的一張設計圖(type)

這一行只把工具箱搬進來,還沒讀任何檔案,記憶體裡也還沒有任何表格。

新手常踩的坑

  • 少打一個 s:import panda as pd,實測 ModuleNotFoundError: No module named 'panda'。沒安裝 pandas 時也是這個錯誤(名字變成 'pandas'),先 pip install pandas。
  • 大小寫寫錯:import Pandas 實測 ModuleNotFoundError: No module named 'Pandas';Import pandas 則是 SyntaxError: invalid syntax。
  • 用了綽號卻寫全名:import pandas as pd 之後寫 pandas.read_csv(…),實測 NameError: name 'pandas' is not defined。名牌只有 pd。
  • 把自己的程式存成 pandas.py:import 會先找到你自己的檔案,而不是真正的 pandas。Python 3.13 實測:AttributeError: module 'pandas' has no attribute 'read_csv' (consider renaming '…\pandas.py' if it has the same name as a library you intended to import)。

叫 pandas 的 read_csv 機器打開 driver_daily_stats.csv,把每一行切成格子、判斷每一欄是什麼型別,做成一張 2000 列 × 5 欄的表格物件,最後把名牌 df 貼上去。

逐字拆解

df
名牌自己取的名字,是 data frame 的縮寫,pandas 範例幾乎都這樣取。取 drivers 也可以。
=
指派不是數學的等於,而是「把右邊做出來的東西貼上左邊的名牌」。右邊全部做完才執行。
pd.
模組L1 貼上名牌的 pandas 工具箱,點=「打開它往裡面拿」。
read_csv
函式讀 CSV 的機器。小寫開頭,一看就知道不是設計圖(類別)。
(
呼叫函式加括號=開動機器,括號裡是交給它的材料(引數)。
'driver_daily_stats.csv'
位置引數一個字串,對應第 1 個參數 filepath_or_buffer。這是相對路徑:從「目前的工作資料夾」找這個檔名。
)
收尾材料給完,開始執行。

read_csv 常用參數表(其他沒寫的都用預設值)

參數本題的值預設值(兩版相同)白話
filepath_or_buffer'driver_daily_stats.csv'(必填)要讀的檔案:檔名、完整路徑、網址都可以
sep—','(簽名上顯示 <no_default>,內部補成逗號)用什麼符號分欄。分號分隔的檔案要寫 sep=';'
delimiter—Nonesep 的別名,兩個擇一寫
header—'infer'哪一行是欄名。'infer':沒給 names 時把第 1 行當欄名(等於 header=0);檔案沒有欄名要寫 header=None
names—不指定(<no_default>)自己給一串欄名
index_col—None哪一欄拿來當列標籤。None:自動編 0、1、2…(RangeIndex)
usecols—None(全部讀)只讀某幾欄,大檔案可以省記憶體
dtype—None(自動判斷)指定某欄的型別,例如 {'region': 'category'}
skiprows—None開頭跳過幾行(例如檔案前面有說明文字)
nrows—None(讀到最後)只讀前幾列資料,先偷看大檔案時很好用
na_values—None「另外」哪些字串也要當成缺值,例如 ['-', '無']
keep_default_na—True要不要保留內建的 19 個缺值字串(下面列出來)。本題的空格能變成 NaN,靠的就是它
encoding—None(實際用 UTF-8 解碼)檔案的文字編碼。台灣舊版 Excel 存的 CSV 常是 'cp950'(Big5)
parse_dates—None(不轉)哪些欄要轉成日期時間。本題沒有日期欄

read_csv 一共有 44 個參數(pandas 3.0.6),2.2.3 有 49 個;3.0 拿掉了 delim_whitespace、verbose、keep_date_col、date_parser、infer_datetime_format。除了第一個,其他參數都只能用「名字=值」的方式寫(簽名裡是 keyword-only)。

內建的 19 個「缺值字串」

keep_default_na=True 時,格子內容只要是下面任何一個,就會被讀成 NaN(兩版相同,實測 pandas._libs.parsers.STR_NA_VALUES):

'''#N/A''#N/A N/A''#NA''-1.#IND''-1.#QNAN''-NaN''-nan''1.#IND''1.#QNAN''<NA>''N/A''NA''NULL''NaN''None''n/a''nan''null'

本題的空格就是第一個 ''(空字串)。注意 'NA' 也在名單上:如果某一欄真的有「NA」這個值(例如北美 North America 的縮寫),實測會被當成缺值。

這台機器在裡面做了什麼

  1. 打開檔案,用 UTF-8 把位元組解碼成文字。
  2. 第 1 行當欄名:driver_id、daily_earnings、region、app_version、gps_ping_rate。
  3. 之後每一行用逗號切開;空字串照上面的名單換成 NaN。
  4. 每一欄判斷型別:全是數字 → float64;有文字 → 2.2 是 object、3.0 是 str。daily_earnings 有空格,NaN 本身是小數,所以整欄是 float64(實測:一欄整數只要有一格空白,也會變成 float64)。
  5. 照 DataFrame 設計圖做出表格物件(§1 觀念 2 的 df = DataFrame(…))。
  6. 把表格交回來,最後才執行等號,貼上名牌 df。
執行後(兩版相同的部分): df.shape → (2000, 5) ← 2000 列、5 欄(屬性,沒有括號) df.columns → Index(['driver_id', 'daily_earnings', 'region', 'app_version', 'gps_ping_rate'], dtype=…) (dtype:2.2 是 'object'、3.0 是 'str') df.index → RangeIndex(start=0, stop=2000, step=1) df.isna().sum() → 只有 daily_earnings 有 100 個空格,其他 4 欄都是 0 type(df) → pandas 3.0.6:<class 'pandas.DataFrame'> pandas 2.2.3:<class 'pandas.core.frame.DataFrame'>

df.dtypes(pandas 2.2.3)

driver_id          object
daily_earnings    float64
region             object
app_version        object
gps_ping_rate     float64
dtype: object

df.dtypes(pandas 3.0.6)

driver_id             str
daily_earnings    float64
region                str
app_version           str
gps_ping_rate     float64
dtype: object

參數改一下會怎樣(都實測過)

寫法結果
pd.read_csv('driver_daily_stats.csv', nrows=3)只讀前 3 列
…, usecols=['driver_id', 'daily_earnings']形狀 (2000, 2)
…, index_col='driver_id'形狀 (2000, 4),列標籤變成 D0001、D0002…
…, dtype={'region': 'category'}region 變成 category(類別)型別
…, header=None形狀 (2001, 5),欄名變成 0~4,原本的欄名那一行被當成第 1 筆資料,daily_earnings 那欄因此變成文字欄
…, sep=';'形狀 (2000, 1):找不到分號,整行擠成 1 欄
…, keep_default_na=False空格不再變成 NaN,而是空字串;daily_earnings 整欄變成文字(2.2 object/3.0 str),describe 只剩 count 2000、unique 1901、top ''、freq 100,算不出平均

新手常踩的坑

  • 檔名打錯或檔案不在工作資料夾:實測 FileNotFoundError: [Errno 2] No such file or directory: 'driver_daily_stat.csv'。相對路徑是從「執行程式時所在的資料夾」找,不是從 .py 檔所在的地方;不確定時用 import os; print(os.getcwd()) 看一下。
  • 中文 CSV 是 Big5(cp950)編碼:實測 UnicodeDecodeError: 'utf-8' codec can't decode byte 0xa4 in position 11: invalid start byte,加上 encoding='cp950' 就好。Excel 另存的「CSV UTF-8」開頭有一個看不見的 BOM 記號,pandas 預設就能正確處理(實測欄名沒有亂碼)。
  • 以為 read_csv 是設計圖:它是函式。想自己做表格才用設計圖 pd.DataFrame(...)。
  • 以為 df 是 CSV 檔本身:df 是記憶體裡的表格物件,改 df 不會改到硬碟上的檔案;要存回去得另外呼叫 df.to_csv(...)。

從表格 df 取出 daily_earnings 這一欄,算出它的 8 個統計量,從中挑出平均、中位數、最大值三個,印在螢幕上。

① df['daily_earnings']跟表格要一欄
→
② .describe()算 8 個統計量
→
③ [['mean', '50%', 'max']]挑 3 個
→
④ print( … )印出來
步驟交出來的東西內容有名牌嗎
①Series2000 格收入(100 格 NaN)沒有
②新的 Seriescount、mean、std、min、25%、50%、75%、max沒有
③又一個新的 Seriesmean、50%、max沒有
④None螢幕上出現 4 行字—

這一行沒有等號,所以中途做出來的三個 Series 都沒有名牌。想留著中間結果,就自己一步一步貼名牌,下面這 4 行印出來的結果和第 4 行一模一樣(實測):

col = df['daily_earnings']           # ①
desc = col.describe()                # ②
sub = desc[['mean', '50%', 'max']]   # ③
print(sub)                           # ④

拆開寫比較好除錯,每一步都能單獨 print 出來檢查;寫成一行比較精簡。兩種寫法 Python 做的事情一樣。

拿 'daily_earnings' 這把鑰匙去跟 df 要東西,df 交出那一欄:2000 格收入,帶著 0~1999 的列標籤。

逐字拆解

df
物件L3 做出來的表格。
[
取東西緊貼在物件後面的方括號=呼叫 df.__getitem__(…)(§1 觀念 3)。
'daily_earnings'
鑰匙欄名字串,要和 CSV 第一行一字不差,大小寫、底線都算。
]
收尾交出一個 Series。

Series 是什麼

一排值+一排標籤(Index),再加上一個名字。就像 Excel 裡的一整欄,連同左邊的列號一起剪下來。表格的每一欄單獨拿出來都是一個 Series。

交出來的 Series 身上有什麼(實測): type(col) → pandas.Series(2.2 顯示 pandas.core.series.Series) col.name → 'daily_earnings' ← 欄名跟著過來,最後 print 的 Name: 就是它 col.dtype → float64 len(col) → 2000 col.index → RangeIndex(start=0, stop=2000, step=1) col.isna().sum() → 100 col.head(3): 0 NaN 1 21.438655 2 255.924079 Name: daily_earnings, dtype: float64

兩版的差別:同一欄拿兩次,是同一個物件嗎?

pandas 2.2.3:df['daily_earnings'] is df['daily_earnings'] 是 True,因為 df 會把拿過的欄位暫存起來(快取),第二次直接交出同一個。pandas 3.0.6:是 False,每拿一次就做一個新的 Series。兩版拿到的 Series 一開始都和 df 共用同一塊資料(不另外複製,省記憶體);差別在「有人要改它的時候」會怎樣,這正是 §5 那個陷阱的關鍵。

新手常踩的坑

  • 欄名大小寫或拼字不同:df['Daily_Earnings']、df['earnings'],實測 KeyError: 'Daily_Earnings'、KeyError: 'earnings'。看不確定時先 print(df.columns)。
  • 忘了引號:df[daily_earnings],Python 以為 daily_earnings 是一張名牌,實測 NameError: name 'daily_earnings' is not defined。
  • 寫成 df.daily_earnings 也拿得到同一欄(實測相同),但欄名有空白、或和方法撞名時就不行:例如欄名叫 mean,df.mean 拿到的是方法,不是欄位。方括號最保險。
  • 以為 df[['daily_earnings']](雙層)和單層一樣:雙層交出的是只有一欄的 DataFrame,形狀 (2000, 1),後面接 describe 印出來的格式也會不同。

叫上一步拿到的那一欄「描述一下你自己」:它算出筆數、平均、標準差、最小值、三個四分位數、最大值,裝進一個新的 Series 交出來。

逐字拆解

.
點「的」:上一步交出的 Series「的」describe。
describe
方法寫在 NDFrame(Series 和 DataFrame 共同的上層類別),Series 是繼承來的(§1 觀念 4)。
()
呼叫括號裡沒有東西:所有參數都用預設值。括號一定要寫,不寫就不會執行。

describe 完整參數表

簽名(兩版相同):describe(self, percentiles=None, include=None, exclude=None)

參數本題的值預設值白話
percentiles—None → 0.25、0.5、0.75要算哪些百分位數,寫 0~1 之間的小數。2.2:不管你給什麼,一定自動補上 0.5;3.0:給什麼就只算什麼
include—None給 DataFrame 用:要描述哪些型別的欄(例如 'all')。對 Series 沒有作用(實測 include='all' 結果不變)
exclude—None同上,排除哪些型別的欄

它在裡面做了什麼

§2 看過:依序呼叫 count()、mean()、std()、min()、quantile([0.25, 0.5, 0.75])、max(),全部都跳過 NaN,再用 Series(…) 設計圖做出一個新的 Series。所以它也是「照設計圖做出來的實例」。

desc = df['daily_earnings'].describe() 之後: type(desc) → Series(新做出來的;desc is col → False) desc.index → Index(['count', 'mean', 'std', 'min', '25%', '50%', '75%', 'max'], dtype=…) desc.name → 'daily_earnings' ← 從原本那一欄抄過來 desc.dtype → float64 ← 所以 count 也顯示成 1900.000000

改 percentiles 試試:兩版不一樣

df['daily_earnings'].describe(percentiles=[0.1, 0.9]) 的實測輸出:

pandas 2.2.3:自動補上 50%

count    1900.000000
mean      223.411306
std       314.383784
min         2.714220
10%        32.195668
50%       128.552462
90%       484.421839
max      4500.000000
Name: daily_earnings, dtype: float64

pandas 3.0.6:只算你給的

count    1900.000000
mean      223.411306
std       314.383784
min         2.714220
10%        32.195668
90%       484.421839
max      4500.000000
Name: daily_earnings, dtype: float64

本題沒寫 percentiles,兩版都用預設的 25%、50%、75%,所以 '50%' 這個標籤一定在。如果你自己改了 percentiles 又想拿中位數,pandas 3 記得把 0.5 也寫進去。

對整張表也能 describe

df.describe() 會一次描述所有數字欄(文字欄預設跳過),兩版實測相同:

       daily_earnings  gps_ping_rate
count     1900.000000    2000.000000
mean       223.411306       1.002647
std        314.383784       0.144609
min          2.714220       0.736000
25%         63.244931       0.943000
50%        128.552462       1.001000
75%        268.723376       1.054250
max       4500.000000       6.400000

看 gps_ping_rate 的 max:6.4,遠高於 75% 的 1.05。這就是情境說的外掛司機(這份模擬資料放了 1 位,2000 人的 0.05%),是下一題的主角。

新手常踩的坑

  • 忘了括號:df['daily_earnings'].describe 只拿到方法本身,print 出來是 <bound method NDFrame.describe of 0 NaN …>,不是統計表。
  • 百分位數寫成百分比:describe(percentiles=[25]),實測 ValueError: percentiles should all be in the interval [0, 1],要寫 0.25。
  • 以為 describe 會改掉原本那一欄:它只是做一個新的 Series 交出來,原本的 2000 格完全沒變,100 個 NaN 也還在。

拿一張寫著 mean、50%、max 的清單,去跟 describe 交出的那個 Series 要東西;它照清單的順序挑出這 3 個,做成一個新的 Series。

逐字拆解

[
外層:取東西緊貼在 describe() 後面,所以是「跟那個 Series 要東西」,呼叫它的 __getitem__。
[
內層:做清單前面沒有緊貼東西(緊貼的是外層的 [),所以是做一個 list。
'mean'
標籤平均數。
'50%'
標籤describe 幫中位數取的名字。不是 'median',也不能多空格寫成 '50 %'。
'max'
標籤最大值。
]]
收尾先關清單,再關取東西。

三種等價寫法(實測結果完全相同)

寫法怎麼找
desc[['mean', '50%', 'max']]題目寫法:用標籤
desc.loc[['mean', '50%', 'max']].loc:明確說「照標籤找」
desc.iloc[[1, 5, 7]].iloc:照位置找(從 0 數起:count 是 0、mean 是 1、50% 是 5、max 是 7)
交出來的新 Series: mean 223.411306 50% 128.552462 max 4500.000000 Name: daily_earnings, dtype: float64 type → Series(第三個新物件) 順序 → 照清單的順序,不是原本的順序

新手常踩的坑

  • 寫成 'median':describe 的標籤裡沒有它,實測 KeyError: "['median'] not in index"。要中位數就用 '50%',或直接 df['daily_earnings'].median()。
  • 少了內層方括號:desc['mean', '50%', 'max'],實測 KeyError: 'key of type tuple not found and not a MultiIndex'(§1 觀念 3)。
  • 只要一個卻用雙層:desc[['mean']] 交出的是「只有一格的 Series」,不是數字;要數字用單層 desc['mean'],得到 np.float64(223.41130600000002)。

把最後那個 3 格的 Series 轉成文字,印在螢幕上。印完交回 None,資料本身一點都沒變。

逐字拆解

print
內建函式Python 本身就有,不用 import。
(
呼叫要等括號裡全部算完才開動(§1 觀念 5)。
df[…]…[[…]]
位置引數③ 交出來的 Series,就是要印的東西。
)
收尾開動 print。

print 完整參數表

簽名(Python 3.13 實測 inspect.signature(print)):(*args, sep=' ', end='\n', file=None, flush=False)

參數本題的值預設值白話
*args一個 Series—要印的東西,可以放很多個,用逗號分開
sep—' '(一個空白)好幾個東西之間要放什麼
end—'\n'(換行)全部印完之後最後加什麼
file—None(=螢幕,sys.stdout)要印到哪裡,也可以印到檔案
flush—False要不要立刻送出,不等緩衝區滿

印出來的 4 行怎麼讀

mean 223.411306 ← 左邊是標籤(Index),右邊是值 50% 128.552462 max 4500.000000 ← 數字靠右、小數點對齊 Name: daily_earnings, dtype: float64 ← 這個 Series 的名字和型別
  • print 一個物件時,Python 會請那個物件「把自己寫成文字」,Series 的寫法就是上面這樣,最後一行固定附上 Name 和 dtype。
  • 小數點後 6 位:pandas 的顯示設定 display.precision 預設是 6(實測),真正存的平均數是 223.41130600000002。
  • 題目把這 4 行寫成 ● mean:223.411306 這種條列,數字完全一樣。

印完之後:交回 None、中途的物件被回收

print 的工作是「把東西顯示出來」,它的回傳值是 None(實測)。如果寫 x = print(…),x 就是 None,不是那個 Series。

第 4 行跑完,①②③ 做出的三個 Series 沒有任何名牌指著。用 weakref(不會把物件留住的觀察工具)實測:pandas 3.0.6 三個都被回收;pandas 2.2.3 的 ② 和 ③ 被回收,但 ① 那一欄被 df 暫存著,還活著。記憶體裡長久留下來的只有 pd 和 df 指著的東西。

新手常踩的坑

  • 在 .py 檔裡只寫 df['daily_earnings'].describe() 不寫 print:程式照樣算,但螢幕上什麼都看不到。Jupyter/Colab 的儲存格會自動顯示「最後一行」的結果,所以那裡不寫 print 也看得到;Series 顯示的文字和 print 一樣(實測 str(s) == repr(s)),DataFrame 則會畫成網頁表格。
  • 以為 print 會改資料或把結果存起來:它只負責顯示。要留著結果,請自己貼名牌,例如 sub = desc[['mean', '50%', 'max']]。

選項裡的程式也拆開:fillna、mean/median/max、dropna

A、B、C 三個選項長得一樣,只差括號裡是 .mean()、.median() 還是 .max()。以 B 為例:

df['daily_earnings'].fillna(df['daily_earnings'].median(), inplace=True)

這一行在動畫 3(§4)裡會再拆一次,並且放上直方圖比較四個選項。

順序在做什麼交出什麼
1前面那個 df['daily_earnings']一欄 Series(pandas 3:一個新做出來的 Series)
2.fillna:找到這個 Series 的 fillna 方法方法本身(還沒開動)
3括號裡的 df['daily_earnings']再拿一次這一欄
4.median():跳過 NaN 算中位數一個數字 128.552462
5fillna(128.552462, inplace=True) 開動把第 1 步那個 Series 的 100 個 NaN 換成 128.552462

這是用 dis 實測的順序:括號裡的 median() 一定在 fillna 開動之前算好(從裡到外);而「前面那個」欄位在最一開始就拿了(從左到右)。請記住第 5 步改的是「第 1 步交出的那個 Series」,它和 df 是不是同一份資料,就是 §5 陷阱的答案。

fillna 完整參數表:把 NaN 換成別的值

參數選項的值pandas 2.2.3 預設pandas 3.0.6 預設白話
valuemean/median/max 算出的數字None(必填)要補什麼:一個數字;或字典 {欄名: 值}(給 DataFrame 用,每欄補不同的值);或一個 Series(照標籤對應著補)
method—None(已不建議,用了會跳 FutureWarning)已移除'ffill'/'bfill':用前一格/後一格的值補。現在改寫成 col.ffill()、col.bfill()
axis—NoneNone沿哪個方向補。Series 只有一個方向,給 1 實測 ValueError: No axis named 1 for object type Series
inplaceTrueFalseFalseFalse:不動原物件,補好的結果做成新物件交出來。True:直接改「點前面那個物件」自己;2.2 回傳 None,3.0 回傳那個物件本身
limit—NoneNone最多補幾格。實測 col.fillna(0, limit=10) 之後還剩 90 個 NaN
downcast—<no_default>已移除補完後試著把型別縮小(例如小數變整數)

兩版的簽名(實測):2.2.3 fillna(self, value=None, *, method=None, axis=None, inplace=False, limit=None, downcast=<no_default>);3.0.6 fillna(self, value, *, axis=None, inplace=False, limit=None)。不寫 value:2.2 出現 ValueError: Must specify a fill 'value' or 'method'.,3.0 出現 TypeError: NDFrame.fillna() missing 1 required positional argument: 'value'。

mean/median/max:算出要補的那個數字

參數預設值白話
axis0沿哪個方向算。Series 只有一個方向;DataFrame 的 0 是「每一欄算一個」
skipnaTrue跳過 NaN。改成 False,實測三個都變成 nan
numeric_onlyFalse給 DataFrame 用:只算數字欄

pandas 3.0.6 的簽名多了一個 *,代表這些參數建議用名字寫;實測 col.mean(0) 還能跑,但會跳 Pandas4Warning: Starting with pandas version 4.0 all arguments of mean will be keyword-only.。另外 std 多一個參數 ddof=1(除以 n−1)。

選項括號裡算出來的補值這個值比多少真實司機高
Adf['daily_earnings'].mean()223.4113060000000270.6%
Bdf['daily_earnings'].median()128.55246250.0%(剛好一半)
Cdf['daily_earnings'].max()4500.099.95%(1900 人裡 1899 人)

dropna:選項 D「直接刪除所有遺失資料」

D 沒有寫程式,最直接的寫法是 df = df.dropna()。DataFrame 的 dropna 參數(兩版相同):

參數預設值白話在本題資料上實測
axis00:刪「列」;1:刪「欄」df.dropna() → (1900, 5);df.dropna(axis=1) → (2000, 4),daily_earnings 整欄不見
how'any'(簽名顯示 <no_default>)'any':有一格 NaN 就刪;'all':整列都是 NaN 才刪how='all' → (2000, 5),一列都沒刪
thresh不指定至少要有幾格不是 NaN 才保留。不能和 how 一起寫,實測 TypeError: You cannot set both the how and thresh arguments at the same time.thresh=5 → (1900, 5);thresh=4 → (2000, 5)
subsetNone只看哪幾欄有沒有 NaNsubset=['daily_earnings'] → (1900, 5)
inplaceFalse同 fillna—
ignore_indexFalse刪完要不要重新編號預設保留原標籤(第一列變成 1,因為 0 被刪了);True → 0~1899

Series 也有 dropna(參數只有 axis、inplace、how、ignore_index):df['daily_earnings'].dropna() 只是交出一欄 1900 格的新 Series,不會刪 df 的任何一列。

§4

互動實驗:一個人能拉走多少平均?100 個空格補什麼?

兩個實驗都用 JavaScript 照 pandas 的算法即時計算:平均=加總 ÷ 筆數;中位數和四分位數用線性內插;標準差除以 n−1。第二個實驗用的是本頁那份 CSV 的全部 1900 個真實數字,算出來的結果和 pandas 一致(本頁用 Node.js 跑過同一段程式,與 pandas 的數字逐一核對)。

一個人能把平均拉多遠?
9 位司機的日收入,前 8 位固定(40~260 元),拖滑桿改第 9 位(橘色)。紅色三角形是讓蹺蹺板平衡的支點=平均數;綠色直線指著站在正中間那位=中位數。下半部把 0~300 元放大,看清楚中間那群人。
快速設定:

補值模擬器:100 個空格要填什麼?
直方圖是 daily_earnings 的真實分布:1900 個有數字的格子,每 25 元一根,1000 元以上合成最右邊一根。點選一種處理,橘色是補進去的 100 筆;下面的表格是處理後的統計量。

變化欄:紅色是比原始高、綠色是比原始低。這裡的「處理後」都用一定有效的寫法 df['daily_earnings'] = df['daily_earnings'].fillna(值) 計算(選項原文的 inplace 寫法在 pandas 3 會失效,見 §5)。

可以試試看

① 蹺蹺板:從 300 慢慢拖到 10000,盯著綠線(中位數):它一步都不動;紅色支點卻一路往右跑。② 拖到 100:第 9 位排到了 110 前面,站在正中間的人換了,中位數才跟著變成 110。只要第 9 位在 128 以上,不管多高,中位數都是 128。③ 補值模擬器依序點 A、B、C:看橘色那根補在哪裡、中位數和平均怎麼動。④ 點 B 再看標準差:就算是最好的 B,100 個一模一樣的值也會讓資料「看起來」比較集中,這是所有「補單一值」方法的共同副作用。⑤ 點 D:直方圖跟原始一樣,但表格少了 100 列,代價在別的欄位。

看動畫 3 之前:這支要回答什麼

上面的實驗讓你自己按按看四種做法。動畫 3 把同一件事串成一條線:先看 100 個 NaN 在哪裡,再把選項 B 那一行拆開,接著把 A~D 四種做法一個一個放上直方圖,最後打開記憶體,看一個很容易踩到的坑:在 Pandas 3 裡,選項那種 inplace=True 寫法其實改不到 df。

帶著三個問題看:① fillna(…) 括號裡的 median() 什麼時候算?② 四種做法各把平均、中位數變成多少?③ inplace=True 改到的是 df,還是另一個物件?

動畫 3補值:100 個空格要填什麼2 分 26 秒・有旁白,也有字幕

直方圖與補值後的數字,都是用本頁模擬資料實際算出來的(pandas 2.2.3 和 3.0.6 結果相同);inplace=True 的行為兩版不同,已分別實測:2.2.3 會補上但出現 FutureWarning,3.0.6 不會改到 df 並出現 ChainedAssignmentError。

看完動畫 3,你應該能回答:用平均數補(A)和用中位數補(B),誰的中位數變了?
A。100 個 223.41 都比原本的中位數大,把中位數從 128.55 推高到 138.34。B 把 100 個值補在正中間,中位數不變,平均只從 223.41 降到 218.67。
D 刪除之後,平均、中位數和原始一模一樣,為什麼還是不選它?
數字一樣,是因為 describe 本來就跳過 NaN。可是 dropna() 刪的是整列:100 位司機的 region、app_version、gps_ping_rate 也一起不見;而且選項說「數值型欄位不適合補值」,這個理由本身就是錯的。
在 Pandas 3 執行選項 B 那一行,df 還剩幾個 NaN?
還是 100 個。df['daily_earnings'] 交給你的是另一個 Series 物件(Pandas 3 一律當成複本),inplace=True 補的是它,不是 df,同時出現 ChainedAssignmentError 警告。Pandas 2.2 會補上,但會出現 FutureWarning 提醒你 3.0 起就不行了。
Pandas 2 和 3 都正確的寫法是什麼?
df['daily_earnings'] = df['daily_earnings'].fillna(df['daily_earnings'].median()):fillna 交出一個補好的新 Series,再用等號放回 df 的這一欄。也可以寫 df.fillna({'daily_earnings': 中位數}, inplace=True),直接叫 df 自己改。
§5

回到題目:逐項對答案

先看四種處理實際把 daily_earnings 變成什麼樣(兩個 pandas 版本結果相同,用一定有效的寫法計算):

處理補的值筆數平均中位數標準差25%75%
原始(跳過 NaN)—1900223.41128.55314.3863.24268.72
A 平均數補223.412000223.41138.34306.4265.21253.03
B 中位數補128.552000218.67128.55307.1265.21253.03
C 最大值補45002000437.24138.34981.3665.21302.32
D 整列刪除—1900 列223.41128.55314.3863.24268.72
(A) df['daily_earnings'].fillna(df['daily_earnings'].mean(), inplace=True) 錯

平均數 223.41 已經被右尾的少數高收入(最高 4500)拉高了。拿它來補,補進去的值比 70.6% 的真實司機都高,等於假設這 100 位司機全都是「中上收入」。補完之後中位數從 128.55 被推到 138.34(+7.6%),分布的中段整個往右移。之後拿去訓練線性迴歸,等於餵了 100 筆偏高的假資料。

(B) df['daily_earnings'].fillna(df['daily_earnings'].median(), inplace=True) 正解

中位數只看「站在中間的人」,4500 那位站多遠都影響不到它(§2 實測:把 4500 改成 45000,中位數一點都沒變)。用 128.55 補,補完中位數完全不動,平均只從 223.41 變成 218.67(−2.1%),是四種處理中最貼近原本分布、偏差最小的,符合題目「保留分布特性、降低偏差」的要求。它仍然有副作用(100 個相同的值讓標準差從 314.38 變成 307.12),但在四個選項裡最合理。

(C) df['daily_earnings'].fillna(df['daily_earnings'].max(), inplace=True) 錯

4500 是全場最極端的值,比 99.95% 的真實司機都高。補完資料裡突然有 101 個 4500(原本只有 1 個),平均幾乎翻倍(437.24,是原本的 1.96 倍),標準差變成 3.12 倍(981.36)。分布被嚴重扭曲,幾乎不可能是合理的做法。

(D) 直接刪除所有遺失資料,因數值型欄位不適合進行補值處理 錯

理由本身就錯:數值型欄位正是最常補值的欄位(平均數、中位數補值都是針對數值)。刪除的代價也不小:df.dropna() 刪的是整列,這 100 位司機的 region、app_version、gps_ping_rate 也一起不見,表格從 2000 列變成 1900 列(實測各區:A 區 868 → 815、B 區 700 → 672、C 區 432 → 413)。這份模擬資料是「完全隨機」遺失,所以刪完收入的統計量剛好不變;但如果遺失和收入有關(例如低收入的司機比較常沒回報),刪掉就會讓剩下的資料整體偏高,反而帶進偏差。

⚠ 重要:選項的寫法本身有坑,在 pandas 3 根本補不進 df

四個選項都用 df['daily_earnings'].fillna(…, inplace=True) 這種寫法。本頁兩個版本都實際跑過(完整程式和輸出在 §6):

版本跑完後 df 剩幾個 NaNfillna 回傳警告
pandas 2.2.30(有補上)NoneFutureWarning
pandas 3.0.6100(完全沒補到 df)被改的那個 SeriesChainedAssignmentError

pandas 2.2.3 的警告原文:

FutureWarning: A value is trying to be set on a copy of a DataFrame or Series through chained assignment using an inplace method.
The behavior will change in pandas 3.0. This inplace method will never work because the intermediate object on which we are setting values always behaves as a copy.

For example, when doing 'df[col].method(value, inplace=True)', try using 'df.method({col: value}, inplace=True)' or df[col] = df[col].method(value) instead, to perform the operation inplace on the original object.

pandas 3.0.6 的警告原文:

ChainedAssignmentError: A value is being set on a copy of a DataFrame or Series through chained assignment using an inplace method.
Such inplace method never works to update the original DataFrame or Series, because the intermediate object on which we are setting values always behaves as a copy (due to Copy-on-Write).

For example, when doing 'df[col].method(value, inplace=True)', try using 'df.method({col: value}, inplace=True)' instead, to perform the operation inplace on the original object, or try to avoid an inplace operation using 'df[col] = df[col].method(value)'.

See the documentation for a more detailed explanation: https://pandas.pydata.org/pandas-docs/stable/user_guide/copy_on_write.html

用物件和名牌來看,為什麼會這樣:

  1. df['daily_earnings'] 交給你的是一個另外的 Series 物件(§3 的 ①)。它沒有名牌,一開始和 df 共用同一塊資料。
  2. .fillna(…, inplace=True) 的 inplace 意思是「改點前面那個物件自己」,也就是改這個 Series,不是改 df。
  3. pandas 3(Copy-on-Write,寫入時才複製):這個 Series 一要被修改,pandas 先替它複製一份自己的資料再改。100 格確實補好了,但補在複製品上;df 原封不動,還有 100 個 NaN。這個補好的 Series 又沒有名牌,一行跑完就被回收。實測修改後它和 df 已經不再共用資料。
  4. pandas 2.2:沒有寫入時複製,直接改那塊共用的資料,所以 df 也「碰巧」跟著變了。pandas 先跳 FutureWarning 提醒:這種寫法到 3.0 就不會再有效。

兩種一定有效的寫法(兩版都實測:補完 0 個 NaN、沒有任何警告):

# 寫法 1:算出補好的新欄位,再用等號放回 df(最推薦,最好懂)
df['daily_earnings'] = df['daily_earnings'].fillna(df['daily_earnings'].median())

# 寫法 2:直接叫 df 自己補,用字典指定「哪一欄補什麼」
df.fillna({'daily_earnings': df['daily_earnings'].median()}, inplace=True)

寫法 1 的等號會把 df 裡 daily_earnings 那一欄換成補好的新 Series;寫法 2 的 inplace 改的是 df 本身(點前面就是 df),所以一定改得到。寫法 2 的回傳值:2.2 是 None,3.0 是 df 本身。

考試作答時不必管這個陷阱:題目問的是「用哪個值補最合理」,答案是 B。但自己寫程式時,請改用上面兩種寫法。

記一張表就夠:四種處理一句話

處理右偏資料上會發生什麼結論
平均數補補值被極端值拉高,中位數被推高 7.6%資料大致對稱、沒有極端值時才適合
中位數補中位數不動,平均只變 −2.1%右偏、有極端值時的首選
最大值補平均翻倍、標準差變 3 倍幾乎不會用
整列刪除其他欄位一起消失;遺失不隨機時會帶進偏差遺失很少、且確定隨機時才考慮
進階:實務上還可以再細一點(考試不考)

中位數補值還能再細緻化,方向和答案 B 一致:① 分組中位數:不同地區的收入水準可能不同,可以依 region 分組,各組用自己的中位數補。② 加一欄「這格原本是空的」記號:讓模型知道哪些值是補出來的。③ 用其他欄位預測遺失值(迴歸補值、多重插補)。這些都是在「不要被極端值拉走」的基礎上,再盡量保留資料原本的樣子。

§6

動手跑跑看:下載模擬資料,兩個 pandas 版本都跑一次

先下載本頁的模擬資料 driver_daily_stats.csv(2000 列 × 5 欄,約 62 KB),和下面的程式放在同一個資料夾,在那個資料夾開終端機執行 python 檔名.py。用 Google Colab 的話,先從左側「檔案」面板把 CSV 上傳到工作階段。不確定自己裝哪一版,先跑 import pandas as pd; print(pd.__version__)。

程式 1:題目的程式,再把第 4 行拆開看

import pandas as pd

df = pd.read_csv('driver_daily_stats.csv')
print(df['daily_earnings'].describe()[['mean', '50%', 'max']])

# ---- 加碼:把第 4 行拆開,一步一步看 ----
print('pandas 版本:', pd.__version__)
print('表格大小(列, 欄):', df.shape)
print(df.head())                         # 前 5 列
print(df.dtypes)                         # 每一欄的資料型別
col = df['daily_earnings']               # ① 取出一欄
print('這一欄有幾格:', len(col), '其中空格:', col.isna().sum())
desc = col.describe()                    # ② 算出 8 個統計量
print(desc)
print(type(col))
print(type(desc))
print(type(desc['mean']))
實際跑出來的結果(兩版相同的部分)
mean     223.411306
50%      128.552462
max     4500.000000
Name: daily_earnings, dtype: float64
pandas 版本: 2.2.3                     ← pandas 3 這行是 3.0.6
表格大小(列, 欄): (2000, 5)
  driver_id  daily_earnings region app_version  gps_ping_rate
0     D0001             NaN      A       5.3.1          1.000
1     D0002       21.438655      C       5.4.0          0.943
2     D0003      255.924079      B       5.3.1          1.017
3     D0004      133.313945      C       5.2.0          0.948
4     D0005      116.975976      B       5.3.1          0.827

前 4 行就是題目的輸出,三個數字和考卷一模一樣。接下來 df.dtypes 和三個 type(...) 兩版不同:

pandas 2.2.3 後半段

driver_id          object
daily_earnings    float64
region             object
app_version        object
gps_ping_rate     float64
dtype: object
這一欄有幾格: 2000 其中空格: 100
count    1900.000000
mean      223.411306
std       314.383784
min         2.714220
25%        63.244931
50%       128.552462
75%       268.723376
max      4500.000000
Name: daily_earnings, dtype: float64
<class 'pandas.core.series.Series'>
<class 'numpy.float64'>

pandas 3.0.6 後半段

driver_id             str
daily_earnings    float64
region                str
app_version           str
gps_ping_rate     float64
dtype: object
這一欄有幾格: 2000 其中空格: 100
count    1900.000000
mean      223.411306
std       314.383784
min         2.714220
25%        63.244931
50%       128.552462
75%       268.723376
max      4500.000000
Name: daily_earnings, dtype: float64
<class 'pandas.Series'>
<class 'numpy.float64'>

「← pandas 3 這行是 3.0.6」是本頁加的註解,程式不會印出來。

程式 2:四種處理,做成一張比較表

import pandas as pd

df = pd.read_csv('driver_daily_stats.csv')
col = df['daily_earnings']

# 四種處理,各做出一個「處理後的欄位」(都不會改到 df)
versions = {
    'original': col,                          # 原始:統計時自動跳過 NaN
    'A_mean':   col.fillna(col.mean()),       # A:用平均數補
    'B_median': col.fillna(col.median()),     # B:用中位數補
    'C_max':    col.fillna(col.max()),        # C:用最大值補
    'D_drop':   df.dropna()['daily_earnings'],  # D:整列刪掉
}

rows = []
for name, s in versions.items():
    rows.append({'name': name, 'count': s.count(), 'mean': s.mean(),
                 'median': s.median(), 'std': s.std(),
                 'q25': s.quantile(0.25), 'q75': s.quantile(0.75)})

table = pd.DataFrame(rows).set_index('name')   # 用 DataFrame 設計圖做一張新表格
print(table.round(2))
print('D 刪除後剩', len(df.dropna()), '列,原本', len(df), '列')
實際跑出來的結果(兩版完全相同)
          count    mean  median     std    q25     q75
name
original   1900  223.41  128.55  314.38  63.24  268.72
A_mean     2000  223.41  138.34  306.42  65.21  253.03
B_median   2000  218.67  128.55  307.12  65.21  253.03
C_max      2000  437.24  138.34  981.36  65.21  302.32
D_drop     1900  223.41  128.55  314.38  63.24  268.72
D 刪除後剩 1900 列,原本 2000 列

注意這裡的 col.fillna(…) 都沒有 inplace:每一次都做一個新的 Series 交出來,col 和 df 完全不受影響(實測:新 Series 是 0 個 NaN,col 和 df 還是 100 個),所以四種處理可以從同一份原始資料各算各的。

程式 3:選項的 inplace 寫法 vs 兩種安全寫法

import pandas as pd
print('pandas 版本:', pd.__version__)

# 選項 B 的原文寫法:df[...] 先交出一欄,再叫那一欄 inplace 補值
df = pd.read_csv('driver_daily_stats.csv')
print('補值前 NaN:', df['daily_earnings'].isna().sum())
result = df['daily_earnings'].fillna(df['daily_earnings'].median(), inplace=True)
print('選項寫法之後 NaN:', df['daily_earnings'].isna().sum())
print('fillna 回傳的東西:', type(result))

# 安全寫法 1:算出補好的新欄位,再用等號放回 df
df = pd.read_csv('driver_daily_stats.csv')
df['daily_earnings'] = df['daily_earnings'].fillna(df['daily_earnings'].median())
print('安全寫法 1 之後 NaN:', df['daily_earnings'].isna().sum())

# 安全寫法 2:直接叫 df 自己補,用字典指定「哪一欄補什麼」
df = pd.read_csv('driver_daily_stats.csv')
df.fillna({'daily_earnings': df['daily_earnings'].median()}, inplace=True)
print('安全寫法 2 之後 NaN:', df['daily_earnings'].isna().sum())
實際跑出來的結果:兩版不一樣

警告訊息開頭會印出程式檔的完整路徑,每台電腦不同,下面用 …\ 代替;警告後面還會再印一次出問題的那一行程式。

pandas 2.2.3:有補上,但有 FutureWarning

pandas 版本: 2.2.3
補值前 NaN: 100
…\demo3.py:7: FutureWarning: A value is trying to be set on a copy of a DataFrame or Series through chained assignment using an inplace method.
The behavior will change in pandas 3.0. This inplace method will never work because the intermediate object on which we are setting values always behaves as a copy.

For example, when doing 'df[col].method(value, inplace=True)', try using 'df.method({col: value}, inplace=True)' or df[col] = df[col].method(value) instead, to perform the operation inplace on the original object.


  result = df['daily_earnings'].fillna(df['daily_earnings'].median(), inplace=True)
選項寫法之後 NaN: 0
fillna 回傳的東西: <class 'NoneType'>
安全寫法 1 之後 NaN: 0
安全寫法 2 之後 NaN: 0

pandas 3.0.6:選項寫法沒有補到 df

pandas 版本: 3.0.6
補值前 NaN: 100
…\demo3.py:7: ChainedAssignmentError: A value is being set on a copy of a DataFrame or Series through chained assignment using an inplace method.
Such inplace method never works to update the original DataFrame or Series, because the intermediate object on which we are setting values always behaves as a copy (due to Copy-on-Write).

For example, when doing 'df[col].method(value, inplace=True)', try using 'df.method({col: value}, inplace=True)' instead, to perform the operation inplace on the original object, or try to avoid an inplace operation using 'df[col] = df[col].method(value)'.

See the documentation for a more detailed explanation: https://pandas.pydata.org/pandas-docs/stable/user_guide/copy_on_write.html
  result = df['daily_earnings'].fillna(df['daily_earnings'].median(), inplace=True)
選項寫法之後 NaN: 100
fillna 回傳的東西: <class 'pandas.Series'>
安全寫法 1 之後 NaN: 0
安全寫法 2 之後 NaN: 0
  • pandas 3 的 fillna 確實把 100 格補好了,回傳的就是那個補好的 Series;只是它是 df['daily_earnings'] 交出來的「另一個物件」,而且寫入時已經複製過,和 df 無關。
  • 兩種安全寫法在兩版都是 0 個 NaN,而且完全沒有警告。
  • 本頁把這支程式存成 demo3.py 執行,所以警告寫的是 demo3.py:7:第 7 行就是選項寫法那一行。
新出現的語法是什麼白話
{'original': col, …}字典 dict大括號裡一對一對的「鑰匙: 值」,用鑰匙找值
for name, s in versions.items():for 迴圈把字典裡的每一對拿出來,鑰匙暫時叫 name、值暫時叫 s,各跑一次縮排裡的程式
rows.append({...})list 的方法在清單尾巴加一個東西(這裡加的是一列的資料)
pd.DataFrame(rows)類別 → 物件拿 DataFrame 設計圖,把「一列一個字典」的清單做成一張表格
.set_index('name')DataFrame 的方法把 name 那一欄拿去當列標籤,交出一張新表格
table.round(2)DataFrame 的方法每個數字四捨五入到小數點後 2 位,交出新表格
s.quantile(0.25)Series 的方法第 25 百分位數,線性內插,和 describe 的 25% 一樣
df.dropna()['daily_earnings']方法串接+取欄位先整列刪掉有 NaN 的列,交出新表格,再從新表格取一欄
type(result)內建函式看 fillna 交回來的是哪一種東西
§7

一頁總結+自我檢測

這題要帶走的 5 件事
  1. pd 是工具箱(模組物件)的名牌;read_csv 是機器(函式),DataFrame、Series 是設計圖(類別)。read_csv 在裡面用 DataFrame(…) 做出表格,最後才貼上名牌 df。
  2. 第 4 行從裡往外:① df['daily_earnings'] 取一欄 → ② .describe() 8 個統計量 → ③ [['mean', '50%', 'max']] 挑 3 個 → ④ print 印出、回傳 None。①②③ 都是新的 Series,沒有名牌。
  3. 單層方括號拿一個(desc['mean'] 是一個數字),雙層方括號拿好幾個(交出新的 Series);中位數在 describe 裡的標籤是 '50%'。
  4. describe、mean、median 預設跳過 NaN,所以 count 是 1900;但跳過不等於補好。右偏資料(平均 223 > 中位數 128、max 4500)用中位數補最不會被極端值拉走,答案是 B。
  5. df[col].fillna(…, inplace=True) 改的是交出來的那個 Series,不是 df;pandas 3 因為 Copy-on-Write 完全補不到 df。請寫 df[col] = df[col].fillna(值) 或 df.fillna({col: 值}, inplace=True)。
pd.read_csv 和 pd.DataFrame,哪個是類別?df 是誰做出來的?
pd.DataFrame 是類別(設計圖,type 是 type);pd.read_csv 是函式(機器,type 是 function)。df 是 read_csv 在裡面執行 df = DataFrame(…) 做出來的,所以 df 是 DataFrame 的實例。
第 4 行一共做出幾個新的 Series?跑完之後它們還在嗎?
3 個:df['daily_earnings']、.describe() 的結果、[['mean', '50%', 'max']] 的結果。它們都沒有名牌,pandas 3 實測三個都被回收;pandas 2.2 的第一個被 df 暫存著,另外兩個被回收。
desc['mean'] 和 desc[['mean']] 有什麼不同?desc['median'] 會怎樣?
單層拿到一個數字 np.float64(223.41130600000002);雙層拿到只有一格的 Series。describe 的標籤裡沒有 'median',實測 KeyError: 'median';中位數的標籤是 '50%'。
daily_earnings 有 2000 格,為什麼 describe 的 count 是 1900?
其中 100 格是 NaN(CSV 裡的空格,read_csv 依預設的缺值名單把空字串讀成 NaN)。count 只算有數字的格子;mean、std、百分位數也都預設 skipna=True,只用 1900 個數字算。
中位數 128.552462 是怎麼算出來的?
1900 個數字排好隊,位置 0.5 × 1899 = 949.5,落在第 950 位(128.386711)和第 951 位(128.718213)正中間,取平均就是 128.552462。
9 位司機 40、70、95、110、128、150、190、260、4500,平均和中位數各是多少?最後一位改成 300 呢?
4500 時:中位數 128、平均 5543 ÷ 9 = 615.89。改成 300:中位數還是 128、平均 1343 ÷ 9 = 149.22。一個人就能把平均拉走 4 倍多,中位數不動。
在 pandas 3 執行 df['daily_earnings'].fillna(df['daily_earnings'].median(), inplace=True),df 還剩幾個 NaN?怎麼改?
還是 100 個,並跳出 ChainedAssignmentError 警告。df['daily_earnings'] 交出另一個 Series,inplace 改的是它(而且寫入時先複製),不是 df。改成 df['daily_earnings'] = df['daily_earnings'].fillna(df['daily_earnings'].median()),或 df.fillna({'daily_earnings': df['daily_earnings'].median()}, inplace=True)。