A.I. TRUTH · 容量為何差很多這件事

為什麼不同模型的
Context Window,差這麼多?

有的塞得下幾本書,有的兩章就滿——差別,藏在成本和設計裡。

往下捲,聽我唸給你聽
🎤

先講在前面:同樣叫「大模型」,有的視窗塞得下一整套小說,有的貼兩章就爆了。
這不是誰偷工減料——那個「上限」背後,是一筆算力、記憶體、和訓練成本一起決定的硬帳。
不信?我唸四個給你聽。

PART 01

這種差距,長這樣

同一份長文件交給 A 模型時被完整吃下並能回指開頭,交給 B 模型時只吃到一半便被長度限制擋住,形成大胃王與小鳥胃的對照。
差距是——

同樣一份長文件,你貼進 A 模型,它從容地全吃下、還能回頭引用開頭,
換到 B 模型,才貼一半就跳出「超過長度上限」——同樣是大模型,一個像大胃王,一個像小鳥胃。
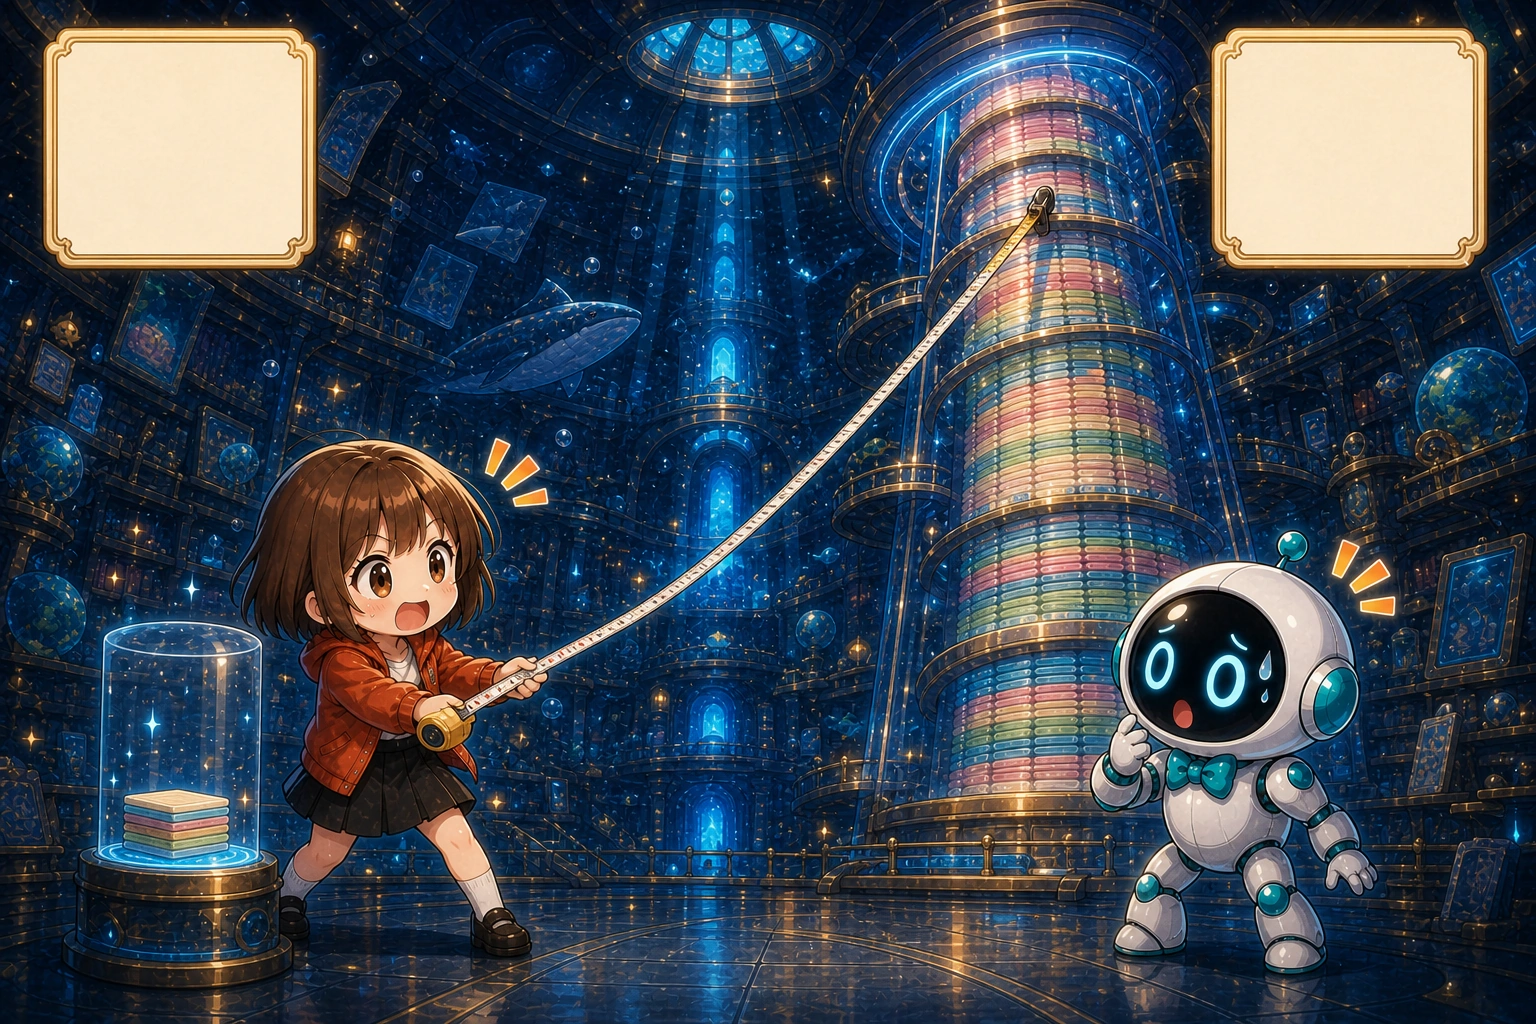
女孩從只能容納幾千字的小型文件筒拉出量尺,量向高聳到天花板、可容納上百萬字的巨大文件塔,AI 對相差好幾個零的規模感到震驚。
差距是——

有的模型號稱能吃「幾十萬、上百萬個字」,
有的還停在「幾千、幾萬」,數字差了好幾個零——不是後者偷懶,是把視窗撐那麼大,是一件又貴又難、不是誰都做得起的事。
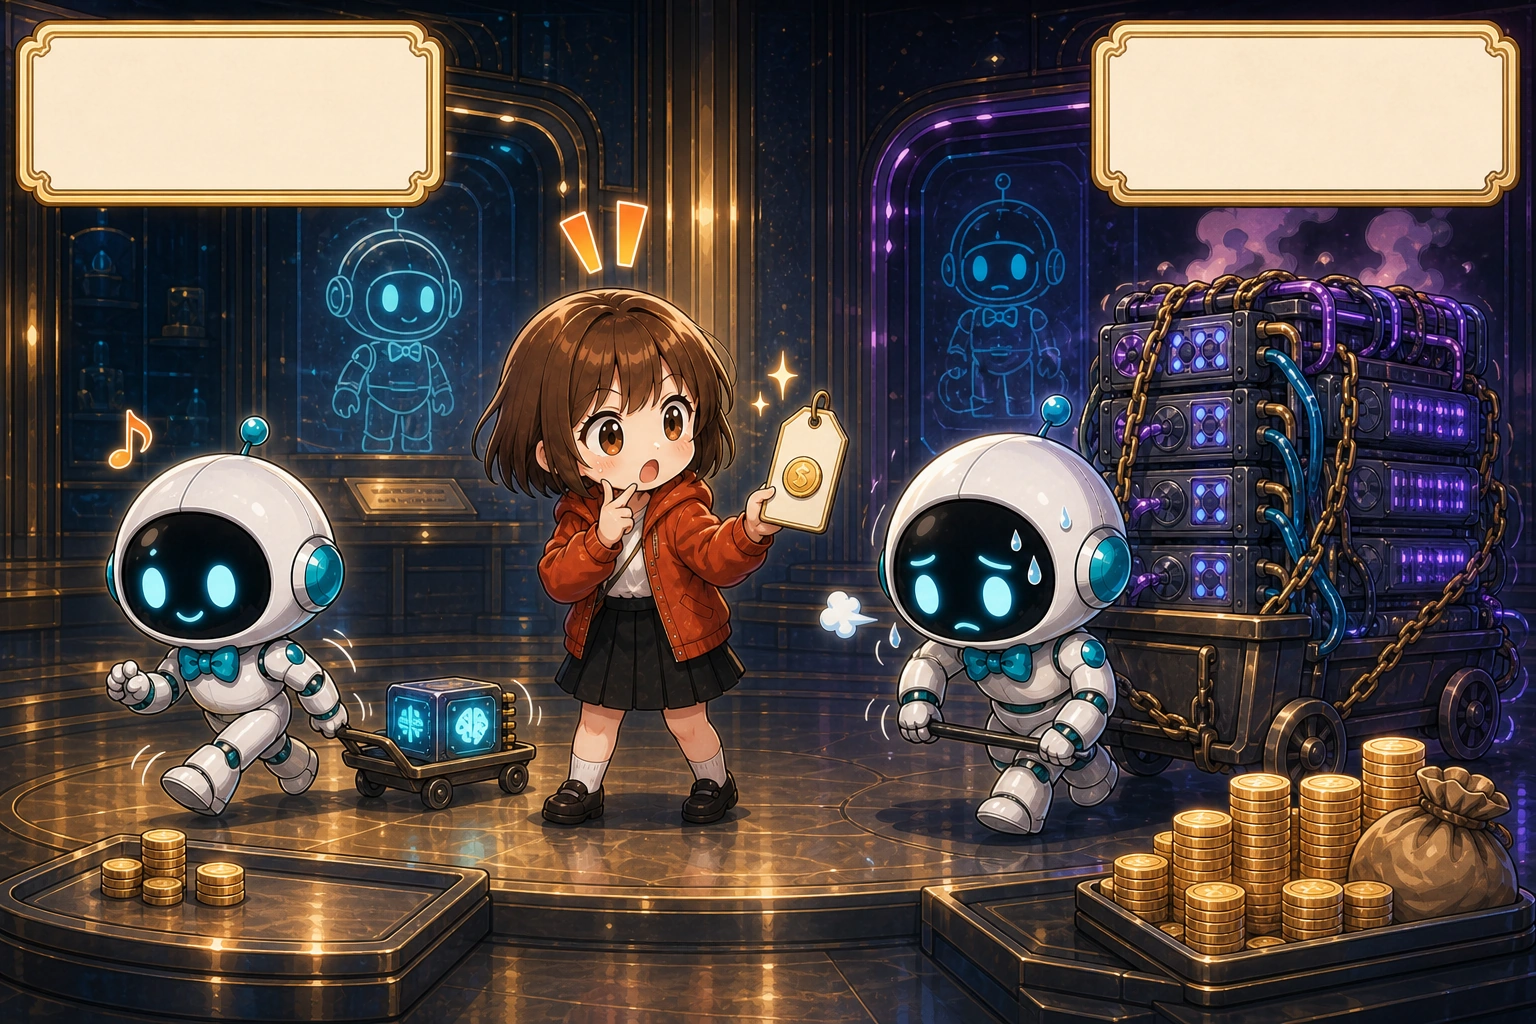
標準版 AI 輕鬆拉著小型記憶體模組,長文版 AI 則吃力拖著整車伺服器與大量金幣,顯示更大的視窗需要更多算力、記憶體、時間與費用。
差距是——

同一個模型,還分「標準版」跟「長文版」,
長文版往往要多付錢、或跑得更慢,那個更大的視窗不是免費附贈的,是它拿更多算力、更多記憶體,實打實換來的一項高級配備。
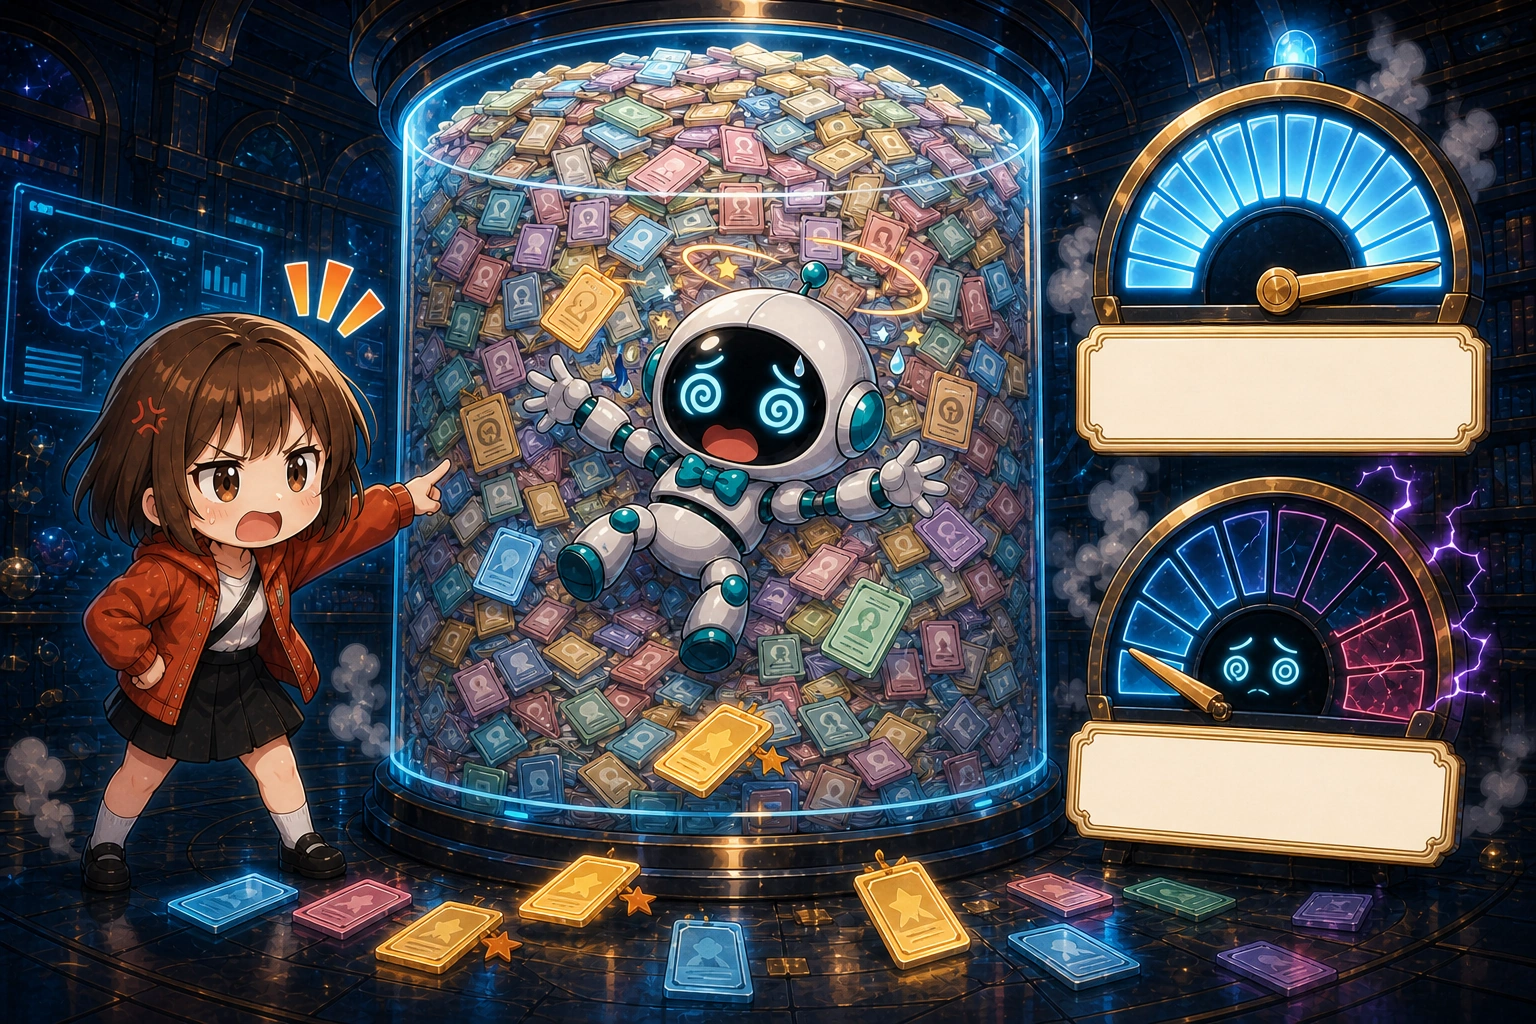
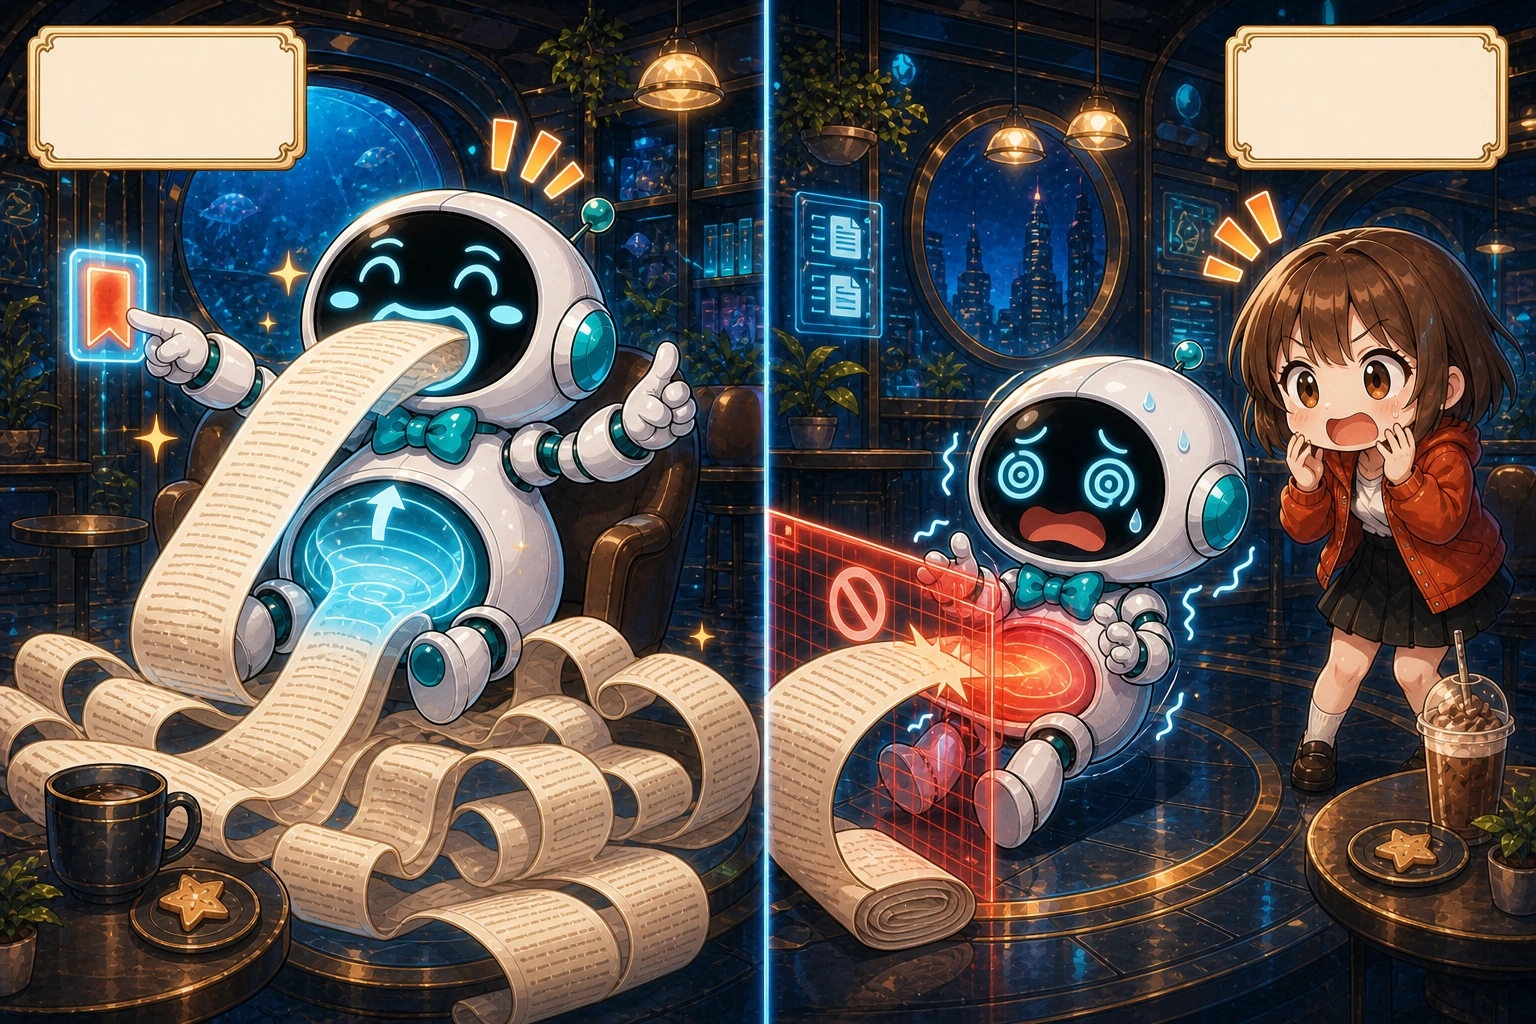
巨大視窗槽雖已塞滿文件並達到最大容量,AI 卻在其中暈眩漏掉重點;右側最大容量錶仍亮著,另一個好用品質錶卻已明顯下降。
差距是——

你以為視窗越大就一定越好,結果貼滿了發現它變慢、變貴、還開始恍神,
那個漂亮的「最大容量」,常常是個極限數字——能裝那麼多是真的,裝滿還好用,又是另一回事。
💬

看到這裡你可能會問:不就是「讓它多讀一點字」嗎?怎麼會有的做得到、有的做不到?
關鍵就在——視窗每拉大一倍,它背後要付的代價,不是加一倍,而是可能翻好幾倍地暴增。
來看原理,這段有點料。

PART 02

為什麼上限差這麼多?

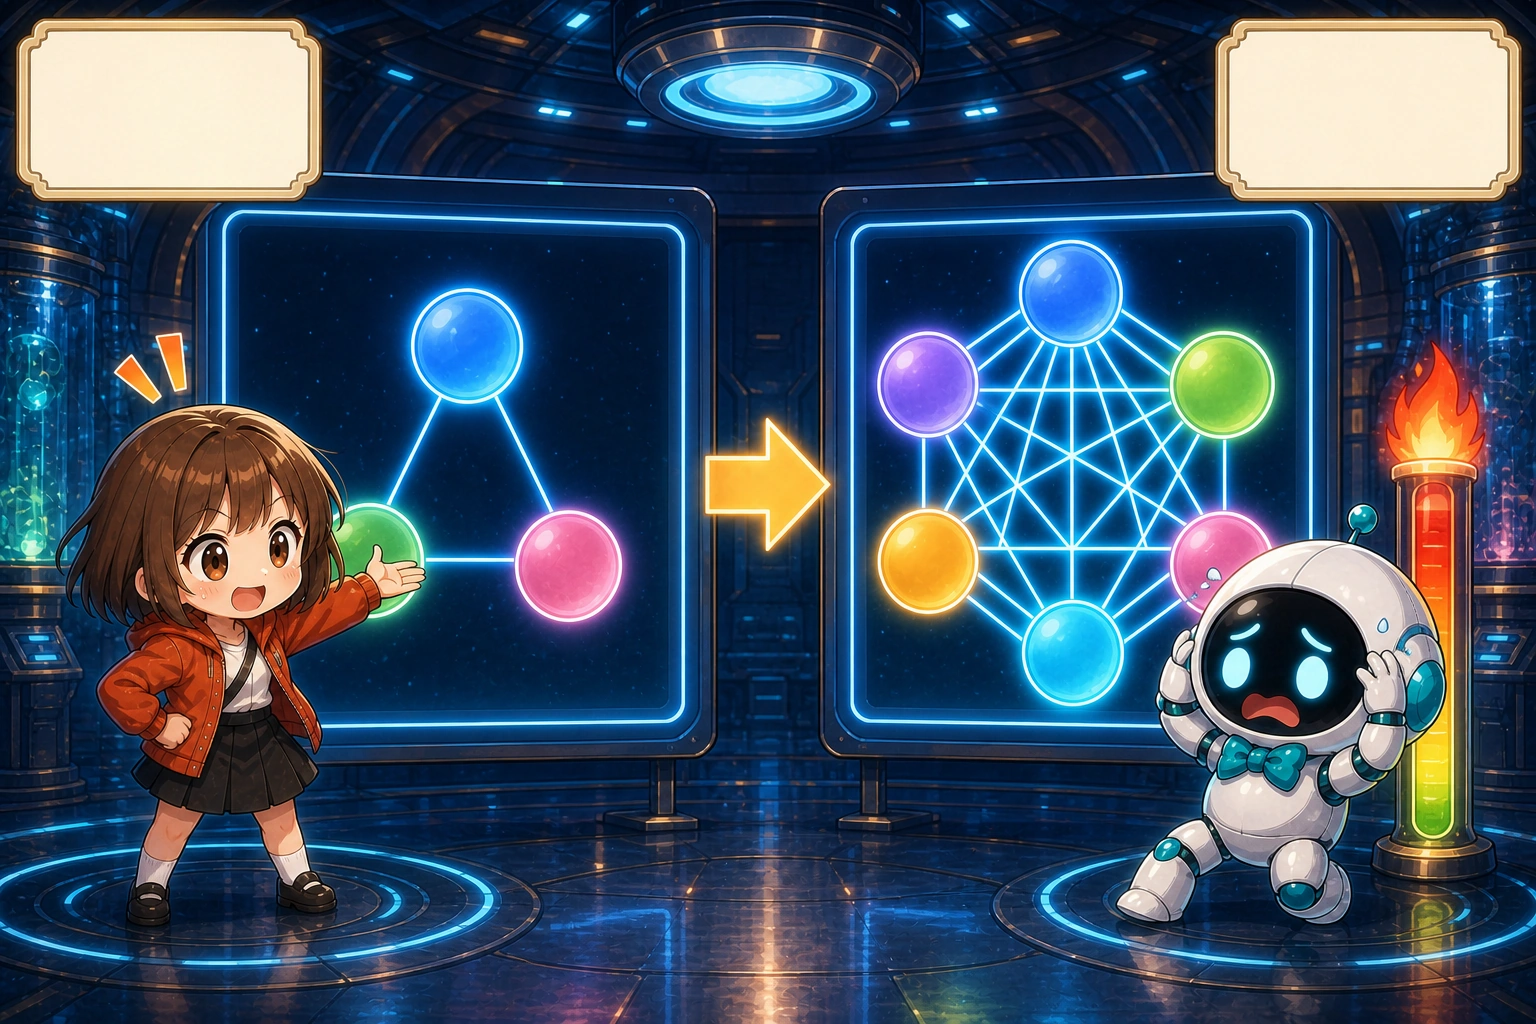
左側只有三顆字詞節點與少量連線,右側字數翻倍成六顆後,每顆都要互相連接,形成密集網路並讓 AI 過熱,表示 2 倍字數可能帶來約 4 倍計算。
原因是——

模型讀長文時,靠的是「每個字都要跟其他所有字互看一遍」的注意力機制,
字一多,這個「兩兩互看」的計算量,是照著平方在暴漲的——字數翻一倍,計算量可能翻四倍,越長越吃力、越燒錢。
所以視窗不是想開多大就多大,
每拉長一截,算力的帳單就狠狠地往上翻一輪——這個平方成長的詛咒,正是所有模型都想突破、卻很難便宜突破的坎。

長文件讀過的每個字都化成一顆 KV cache 狀態晶體,AI 必須持續塞進有限的顯存箱,最後箱子爆滿溢出,女孩指著不斷增長的上下文提醒它。
原因是——

讀越長,還要佔越多的高速記憶體(顯存)來記住整段上下文,
它得把讀過的每個字的「狀態」都暫存起來(這叫 KV cache),視窗越大,這筆記憶體開銷就越沉重、越吃硬體、越貴。
顯存是有限又昂貴的資源,
一張卡就那麼大——想撐超長視窗,要嘛砸更貴的硬體、要嘛用巧妙的技術省著用,這都是實打實的成本和門檻。

AI 在訓練範圍內的明亮文件跑道上跑得穩定,一跨過邊界進入超出範圍的破碎黑暗路段便暈眩讀錯,女孩在安全區急忙警告。
原因是——

更關鍵的是——「能讀多長」得在訓練的時候就練過、或用特殊技巧擴出來,
模型不是天生就會讀超長文,它在訓練時見過多長的文字,大致就決定了它「舒適的視窗」有多大——硬要它讀超出範圍的,它容易讀糊、讀崩。
各家練的長度不同、用的擴展技巧不同,
於是上限自然就落在不同的地方——那個數字,是每家在「訓練成本」和「想支援多長」之間,各自算過帳、做過取捨的結果。

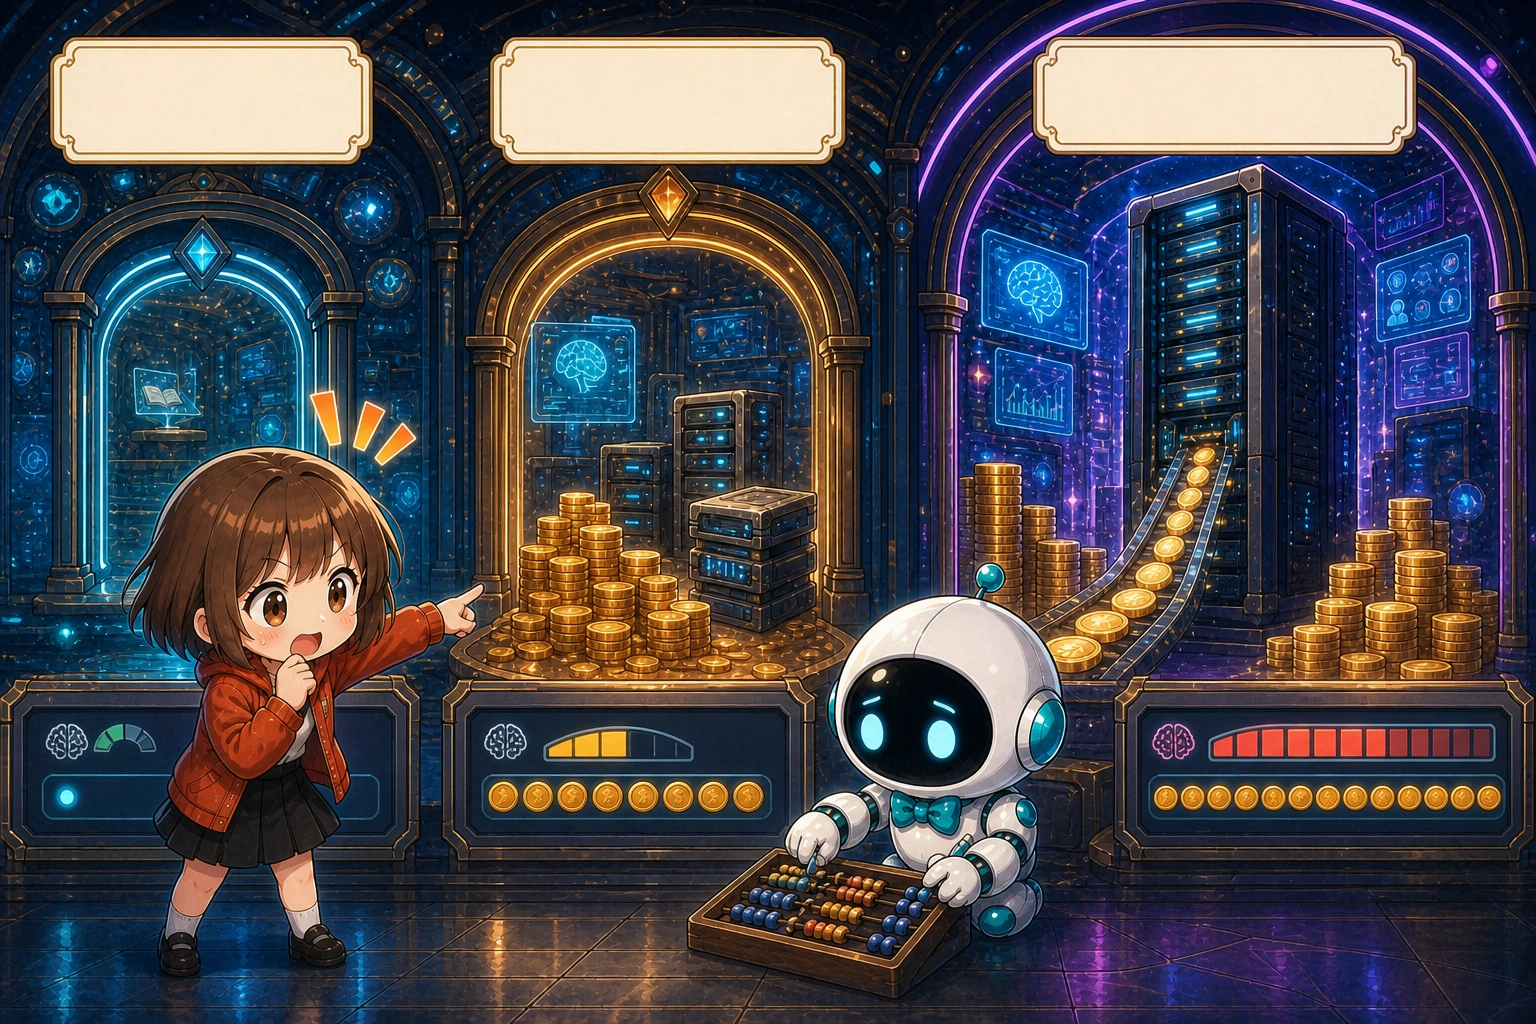
免費版、付費版與企業版三道服務閘門依序配置更大的硬體和更多金幣成本,女孩比較三種方案,AI 用算盤計算視窗大小與營運成本的取捨。
原因是——

最後還有一筆帳,是「商業上的取捨」,
視窗開越大,每次呼叫要處理的東西越多,廠商的運算成本越高——所以他們得決定:這個上限,訂在哪裡,才能兼顧「好用」和「不虧本」。
免費版給你小視窗,是幫你(也幫它自己)省成本,
付費版、企業版才給你大視窗——那個上限,從來不只是技術問題,也是一道精打細算過的、關於錢的商業選擇題。

💬

好,原理你懂了:視窗上限,是算力平方暴漲、顯存吃緊、訓練長度、和商業成本一起決定的一個數字。
那很多人會問——「那我是不是就該無腦選那個視窗最大的模型準沒錯?」
嗯……不一定,往下看。

PART 03

那我該怎麼挑、怎麼用?

女孩被像豪華獎盃般閃耀的超巨大 Context Window 吸引,手上真正的小任務卡卻幾乎被忽略;AI 拉住她並指向巨型視窗內大量用不到的空間。
答案是——

你可能想說,那還考慮什麼,直接挑視窗最大的那個,
反正容量越大越保險、越不會不夠用,一步到位、多多益善,不就對了嗎?

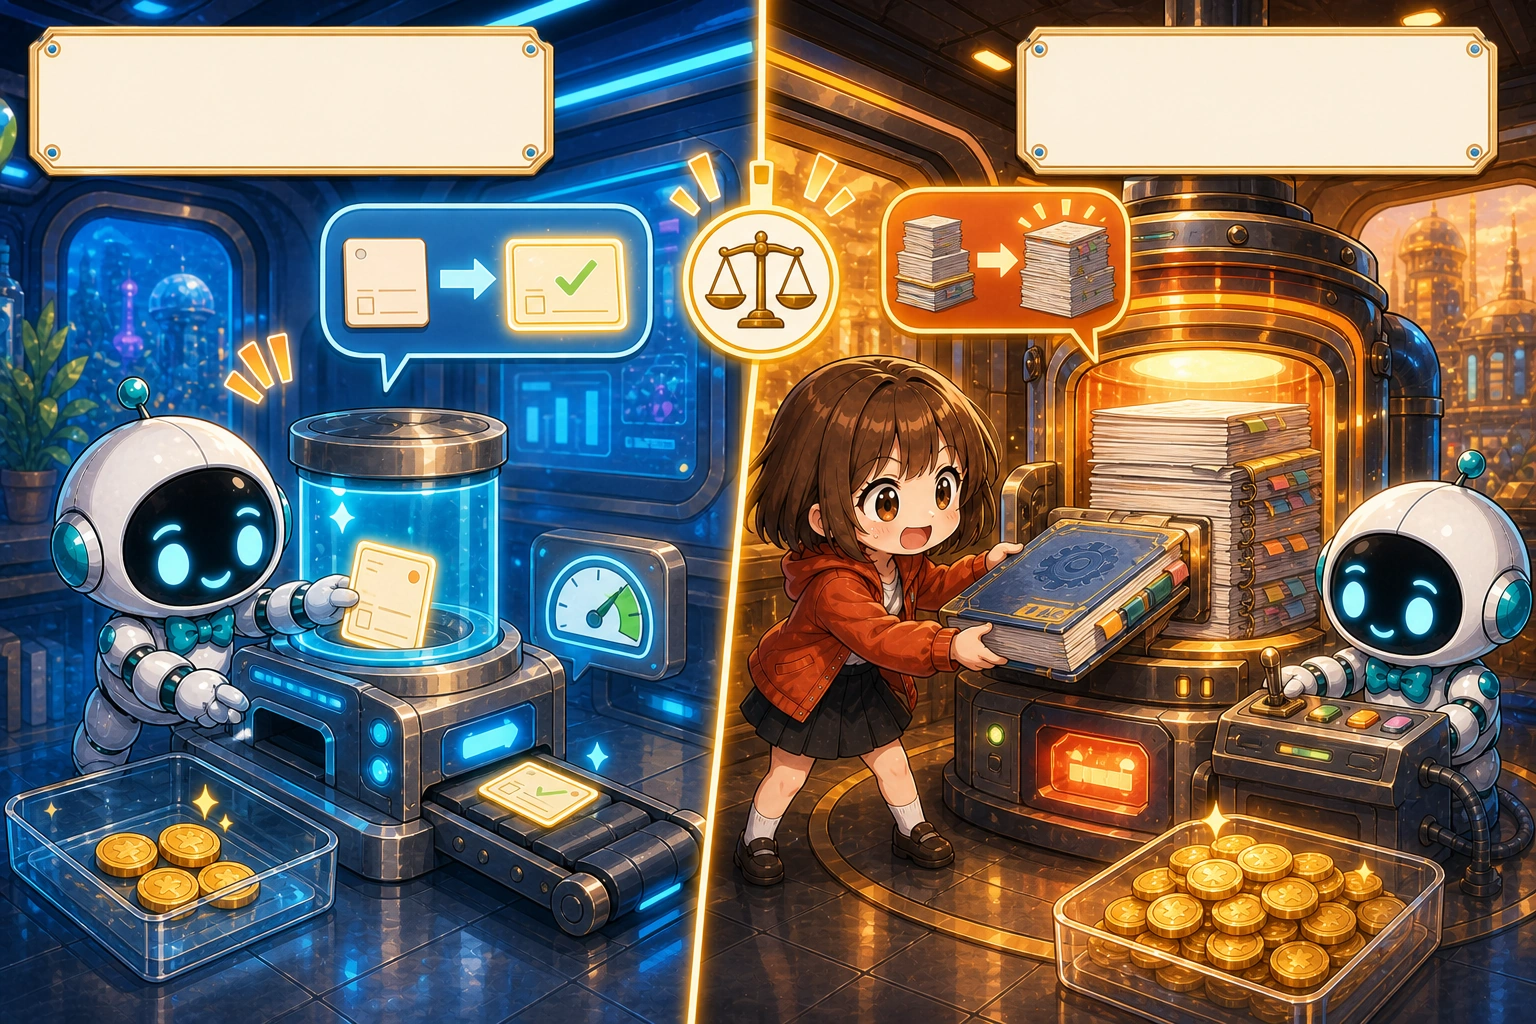
短任務使用小型視窗機器便快速完成且只需少量費用;長文件則交給大型視窗設備吞下整本手冊與厚報告,顯示容量要配合真正的任務長度。
答案是——

先別衝——大視窗通常更貴、更慢,而且你未必用得到,
如果你的東西根本塞不滿,那個超大視窗對你就是一項付了錢卻閒置的高級配備——按你「真正要處理多長」去挑,才划算、才聰明。
短任務用小視窗又快又省,
真的要吞整本手冊、整份長報告,才需要出動大視窗——工具要對上任務,不是一味追那個最大的數字。

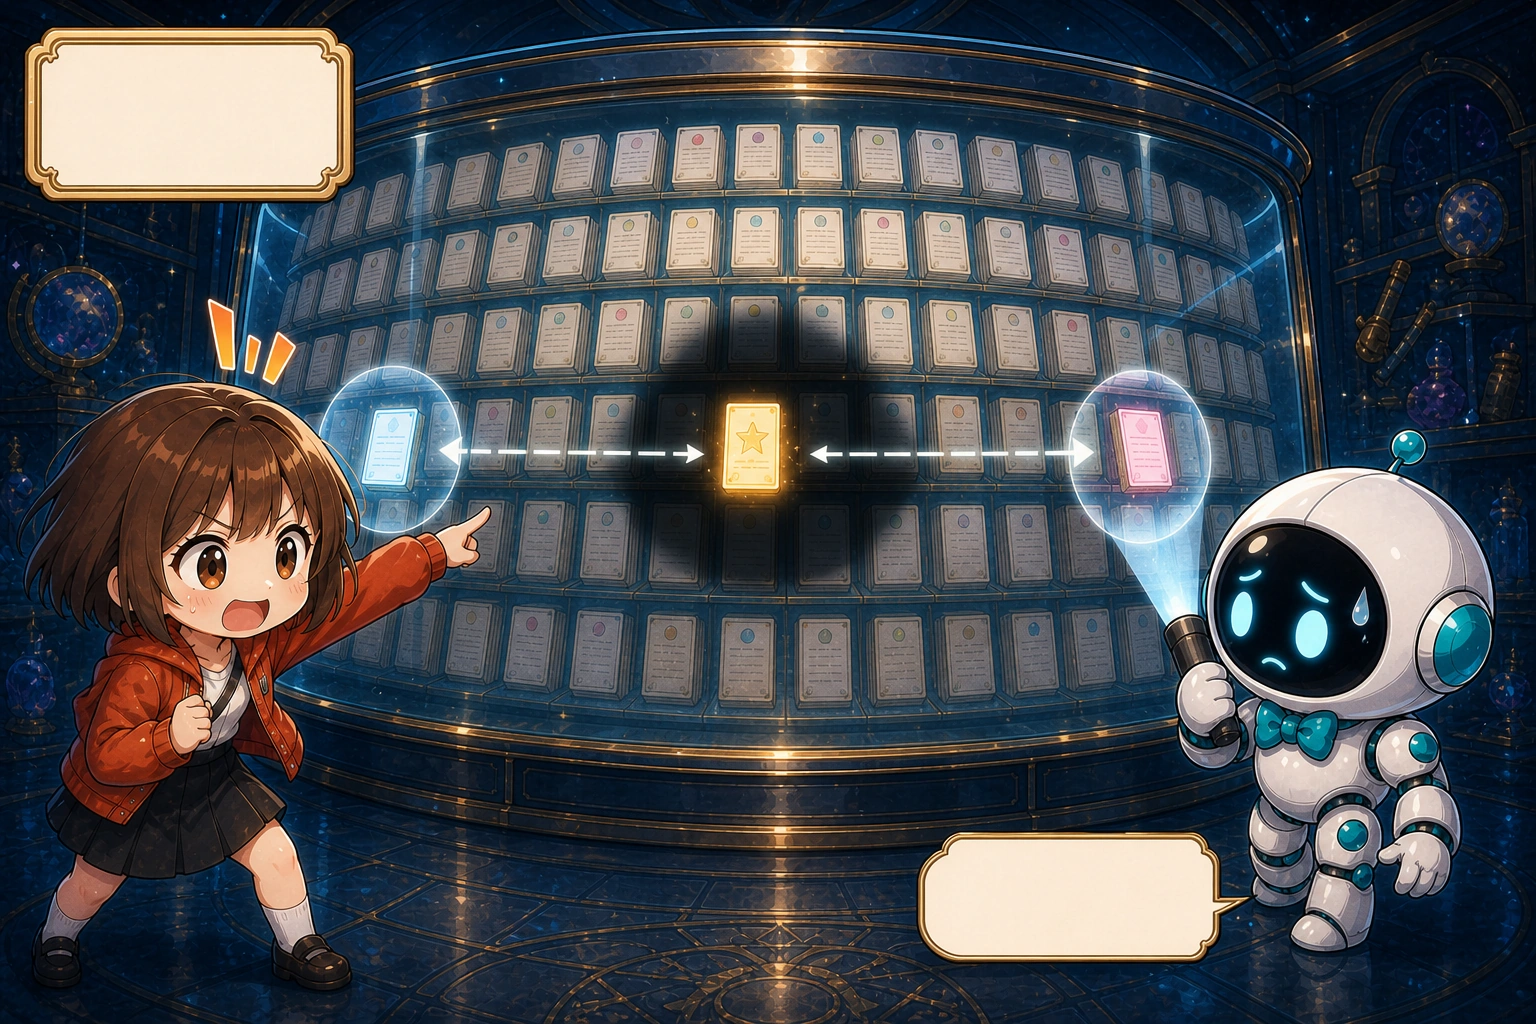
巨大的透明視窗已裝下全部文件卡,但 AI 的注意力手電筒只照到兩側,關鍵的中間卡仍在黑暗中,女孩急指漏掉的重點,說明裝得下不等於顧得到。
答案是——

而且別忘了前面說過的——「裝得下」不等於「顧得到」,
視窗撐再大,它的注意力照樣會在超長內容裡渙散、在中間漏重點——大視窗解決的是「塞不塞得下」,可沒保證「它顧不顧得好」。
所以與其把東西一股腦全倒進去,
不如先篩過、只餵它真正需要的那幾段——餵得精,常常比視窗開得大,更能讓它答得準、答得穩。

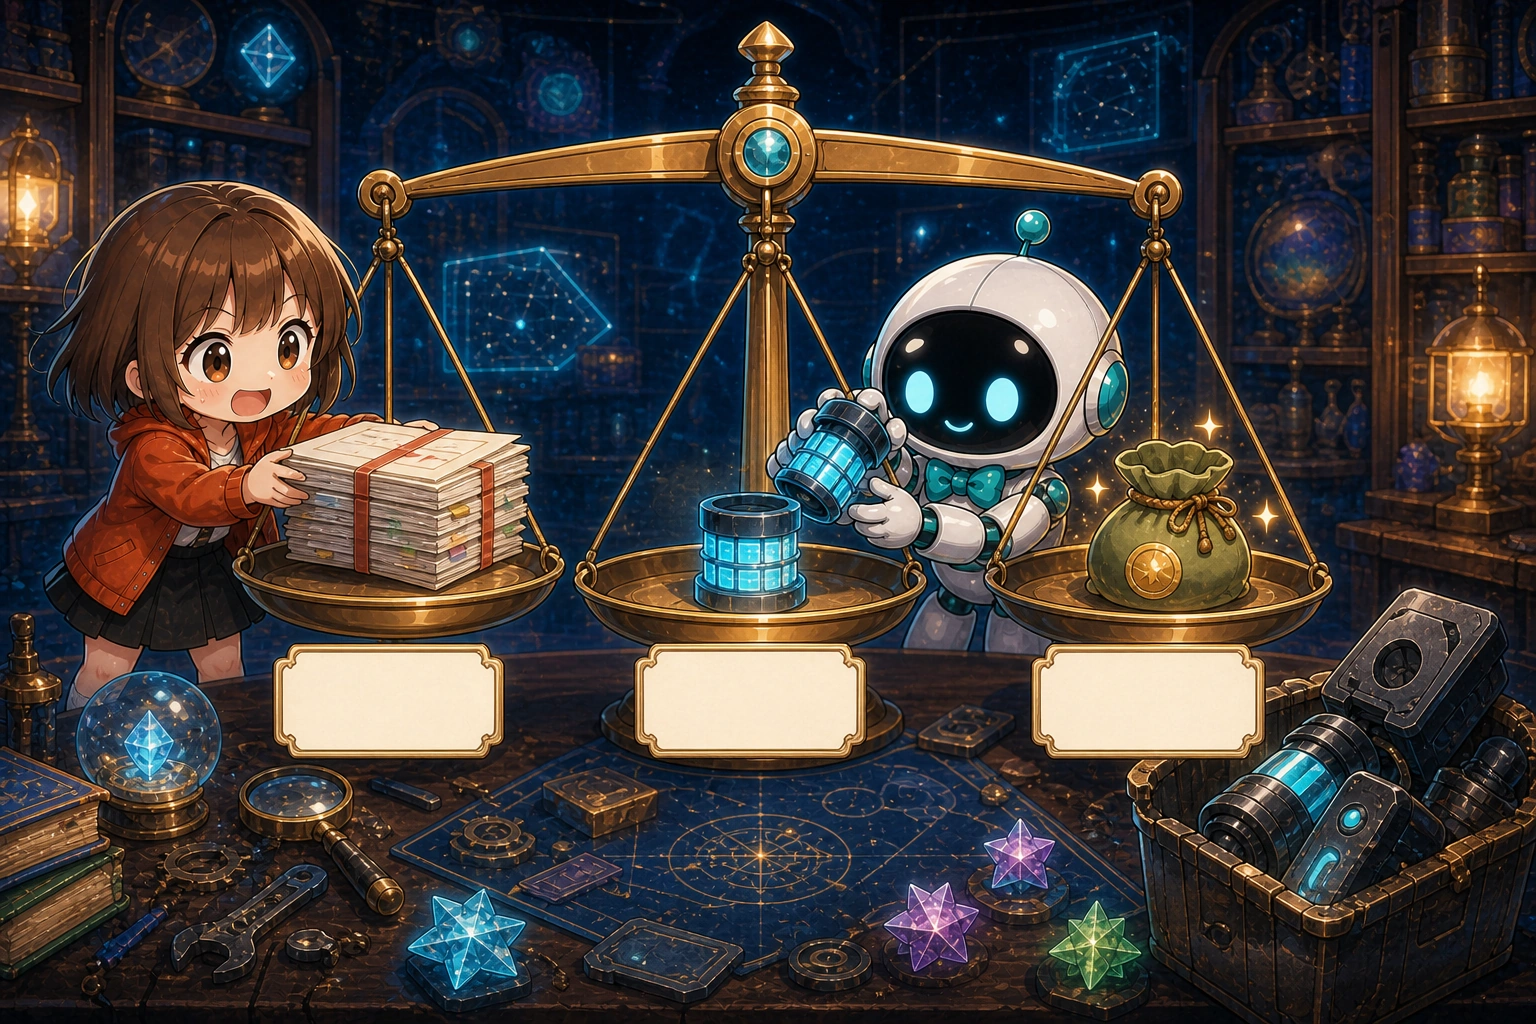
女孩與 AI 在三方天秤上同時衡量任務長度、視窗容量和價格,三者剛好平衡;過大的多餘模組被丟在旁邊,表示選夠用而不浪費的版本。
答案是——

所以聰明的做法,是「看任務挑容量、看需求算成本」,
問清楚你要處理的東西多長、多常用,再去對應那個「夠用、又不浪費」的視窗和版本——而不是被行銷話術裡那個最大的數字牽著走。
那個上限是給機器看的規格,
你真正要顧的,是「這個容量、這個價格,配不配得上我的任務」——想清楚這件事,你就不會為了用不到的容量,白白多付了冤枉錢。

🎤

所以下次你看到兩個模型的視窗上限差了好幾個零,先別急著覺得誰比較「弱」。
那個數字背後,是算力、記憶體、訓練、和成本一起算過的一筆硬帳——大,有大的代價;小,也有小的道理。
真正該記住的,其實只有一件事——

視窗每拉大一截,算力和記憶體的帳就翻好幾倍;
那個上限,是技術和成本一起算過的取捨,不是誰偷工減料;
別追最大的數字,挑對你任務的——餵得精,勝過裝得多。

🎯