🗺️ AI 學習與考證地圖
Mochi 教學手帳 · Semi-Supervised

只有少數答案,怎麼教會整批資料?

真實世界裡「標註」很貴:少量資料有標籤、大量沒有。半監督式學習用少量種子標籤 + 大量未標籤資料一起訓練,讓標籤從已知點「傳播」到相似的未知點。
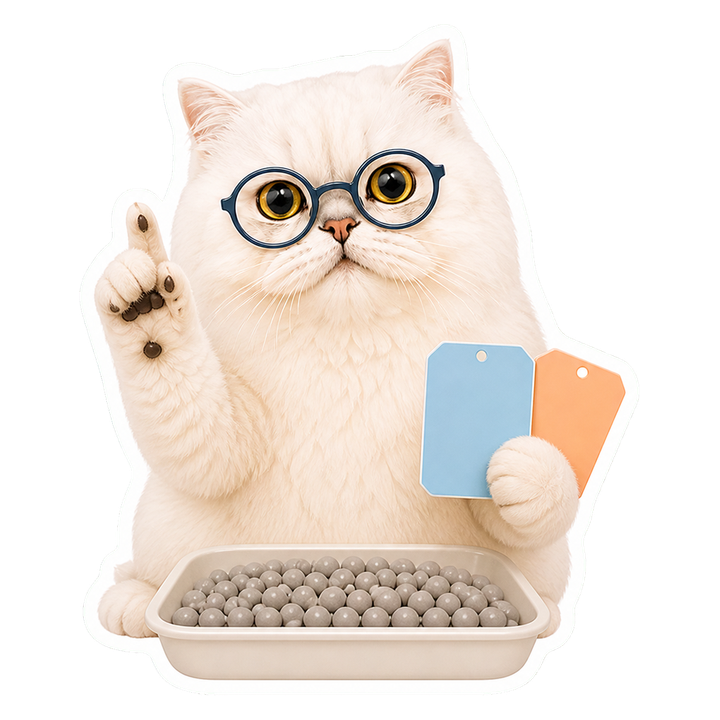
貓老師 Mochi 拿著兩張彩色種子標籤,面前有大量灰色未標籤資料點
答案不必每一筆都有!先用少量種子,帶著相似資料一起學。
互動實驗室 · Label Propagation

互動動畫:標籤從 2 個種子點傳播出去

一開始每群只有「1 個」帶顏色的種子(外圈標記),其餘都是灰色未標籤。每按一次「傳播一步」,離已標籤點最近、最有把握的未標籤點就會被貼上偽標籤——像漣漪一樣往外擴散。

2→?先觀察兩個彩色種子,如何把標籤沿著相似資料一圈圈傳出去。
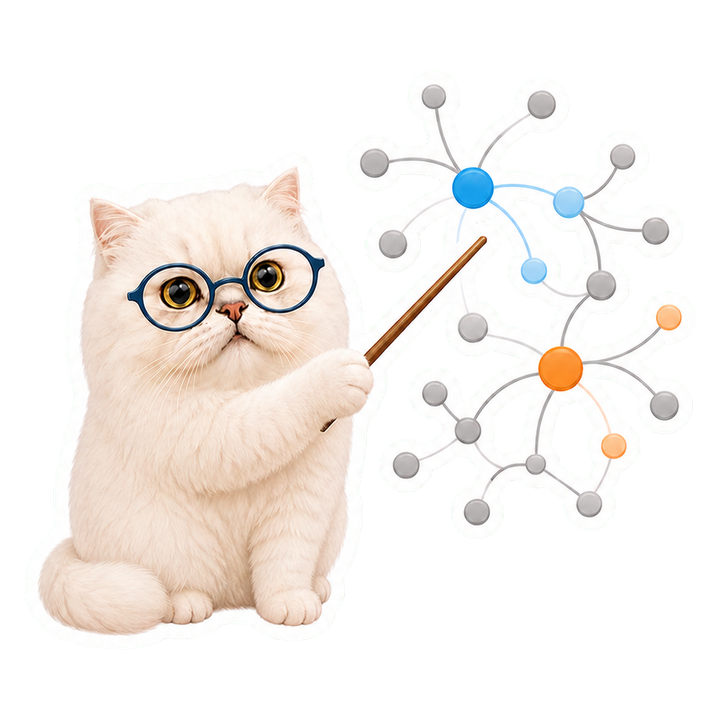
貓老師 Mochi 引導標籤從兩個彩色種子點向鄰近資料傳播
看仔細:最靠近彩色點、最有把握的鄰居,會先接到標籤。
你的瀏覽器不支援 Canvas,請改用新版瀏覽器觀看標籤傳播動畫。
Mochi:目前已標籤 2 / 120
未標籤 類別 A 類別 B ⭕ 外圈 = 原始種子標籤
生活裡的線索

什麼時候用?

當人工標註昂貴、但手上累積了大量未標籤資料,就讓少數可靠答案帶路。

標註成本高(醫療影像、法律文件) 未標籤資料很多 文本 / 影像分類 語意分割 跨語言分類
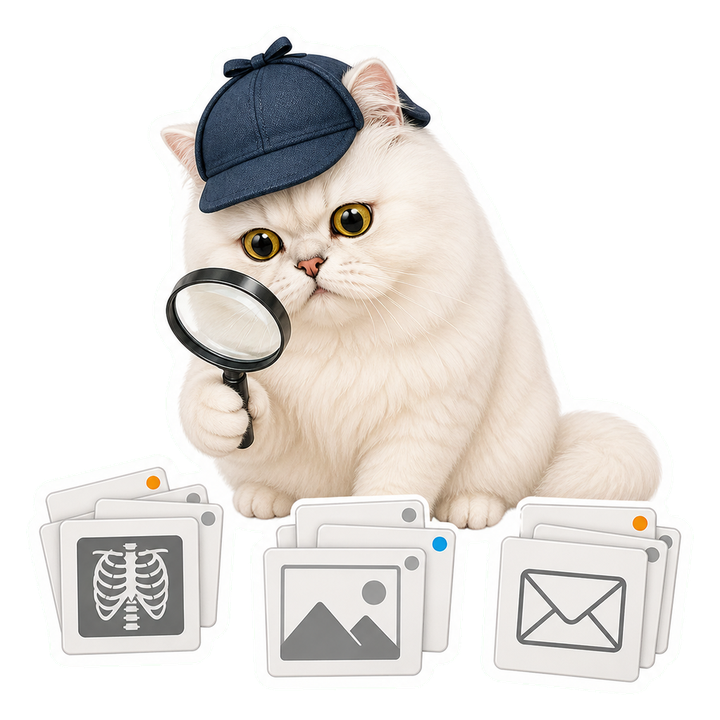
偵探 Mochi 檢視只有少數樣本帶標籤的醫療影像、照片與郵件資料
專家只標一小部分也沒關係;其餘資料仍然能提供重要線索。
考前便利貼

iPAS 考點提醒

情境題:只有少部分影像有專家標註,其餘大量未標註,結合兩者一起建模——屬於哪一種學習?
關鍵字:少量標籤 + 大量未標籤、一起訓練 → 半監督式。
常見陷阱

別把它當成「監督式」(那需要全標註),也不是「非監督式」(那完全沒標籤)。半監督式的精神是用未標籤資料補強少量標籤。自訓練的偽標籤若品質差,錯誤會被放大——信心閾值很重要。
貓老師 Mochi 拿著考卷,提醒少量標籤加大量未標籤的考試關鍵字
看到「少量有標籤、大量沒標籤、一起訓練」,先圈起來!
Mochi 的本課小結

讓少量答案,帶著大量資料一起學

半監督式學習站在監督式與非監督式之間:保留少量可靠標籤,也把大量未標籤資料的結構用起來。

資料組合:少量標籤 + 大量未標籤,一起參與訓練。

傳播直覺:相似、鄰近而且高信心的資料,先接到偽標籤。

答題關鍵:不要誤認成全有標籤的監督式,或完全沒標籤的非監督式。
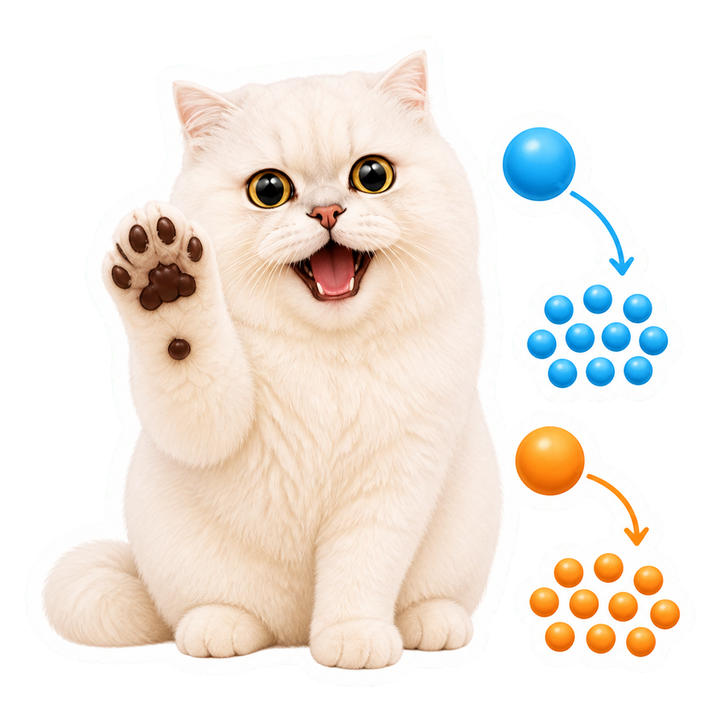
貓老師 Mochi 稱讚學生,兩個種子點已帶動整群資料完成標籤傳播
兩個種子帶動整群資料,你已經抓到半監督式學習的核心囉!

📝 iPAS 考點提醒

半監督式學習是 iPAS 初級科目一與科目二「學習類型」的常考判斷題,中級科目三會再深入方法。常見考法:描述「少量有標籤+大量無標籤一起訓練」問屬於哪種學習;問五種方法的核心——自訓練(用自己的高信心預測當標籤)、偽標籤(把預測結果當假標籤加入訓練)、協同訓練(兩個不同視角的模型互相標註)、標籤傳播(在相似度圖上讓標籤往鄰居擴散)、一致性正則化(同一筆資料加擾動後預測應一致)。易混點:它不是監督式(需全標註)也不是非監督式(完全無標籤);偽標籤品質差會把錯誤放大。情境題長相:「醫療影像僅 5% 有專家標註,想利用其餘 95% 提升模型,應採?」答半監督式學習。

想練情境題與詳解 → AI 學習與考證地圖

❓ 常見問題

半監督、監督、非監督怎麼一眼分?

看標籤比例:全部有標籤→監督式;完全沒標籤→非監督式;少量有標籤加大量無標籤一起用→半監督式。

自訓練和偽標籤是同一件事嗎?

很接近。自訓練是「用模型高信心的預測替無標籤資料貼標、再重訓」的迭代流程;偽標籤強調把預測結果當成假標籤加入訓練集。考題多視為同一思路。

協同訓練的前提是什麼?

資料要有兩個相對獨立的「視角」(如網頁的文字與連結),各訓一個模型,互相把高信心預測標給對方,彼此補強。

標籤傳播怎麼運作?

把所有樣本建成相似度圖,有標籤的節點像種子,標籤沿著邊往相似的鄰居擴散,直到整張圖穩定;適合「相似的點應該同類」的資料。

一致性正則化在做什麼?

對同一筆無標籤資料加雜訊或增強後,要求模型輸出保持一致,把這個差異當損失來訓練,讓決策邊界避開資料密集區。

半監督學習的風險是什麼?

偽標籤錯了會被當真、錯誤不斷放大(確認偏誤);資料分布假設不成立時反而更差。實務上要設信心門檻,並用有標籤的驗證集監控。

🧭 相關主題

← 返回 AI 學習與考證地圖