蒙地卡羅:與其猜一次未來,不如探索一千個平行宇宙
有些數值很難直接算,例如未來會怎樣、一個怪形狀的面積。貓老師 Mochi 的方法是:大量隨機取樣、跑很多很多次,再統計結果。樣本越多,估計越準;不求唯一答案,而是掌握整個機率分布與風險。
先用白話講蒙地卡羅在做什麼
蒙地卡羅是用大量隨機取樣去估計難以直接計算的數值,例如期望值、積分、機率。依大數法則,樣本越多,估計通常越準。
它以摩納哥的蒙地卡羅賭場命名,因為核心就是靠隨機擲骰子,讓大量偶然逐漸顯露穩定規律。
不規則池塘怎麼量?
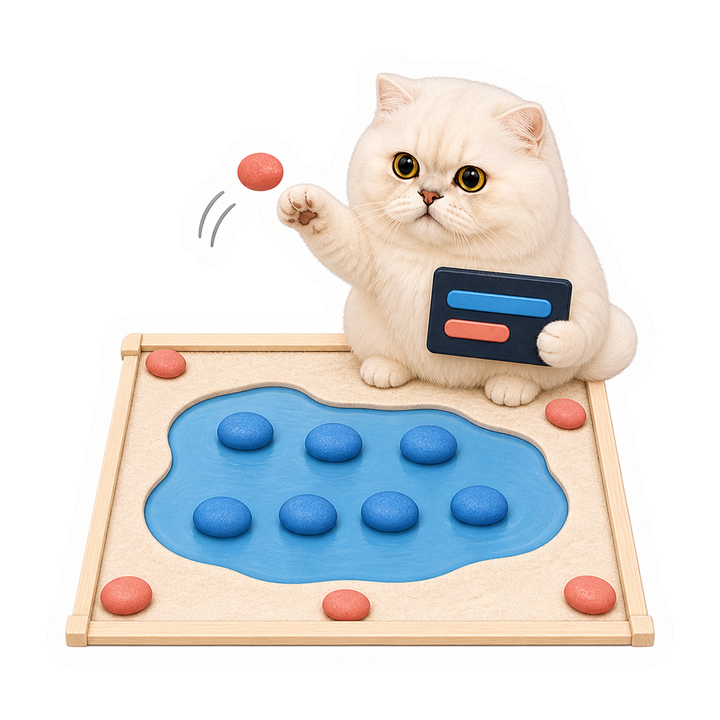
想知道一個不規則池塘的面積,與其精算彎曲邊界,不如往整塊地隨機丟一千顆小石頭。落在池塘裡的比例 × 總面積,就能估出池塘面積。這就是用隨機取樣換掉困難的計算。
經典例子:用灑點估圓周率 π
在正方形裡隨機灑點
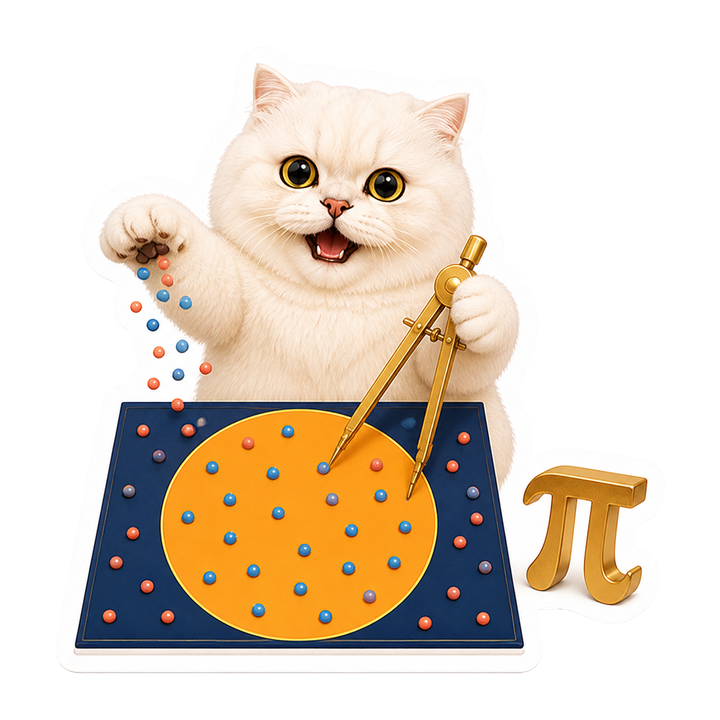
在一個正方形內畫出內接圓,然後隨機灑很多點。落在圓內的點數 ÷ 總點數,約等於圓與正方形的面積比=π/4。
π ≈ 4 × 圓內點數 / 總點數點灑得越多,估出來的 π 越接近 3.14159。這就是蒙地卡羅「越多樣本越準」的直觀示範。
動手玩:模擬一千個平行宇宙
情境:預測一座太陽能電廠未來 90 天的累積發電量。天氣是隨機的,依序切換三種模式,看只猜一次到模擬一千次的差別。
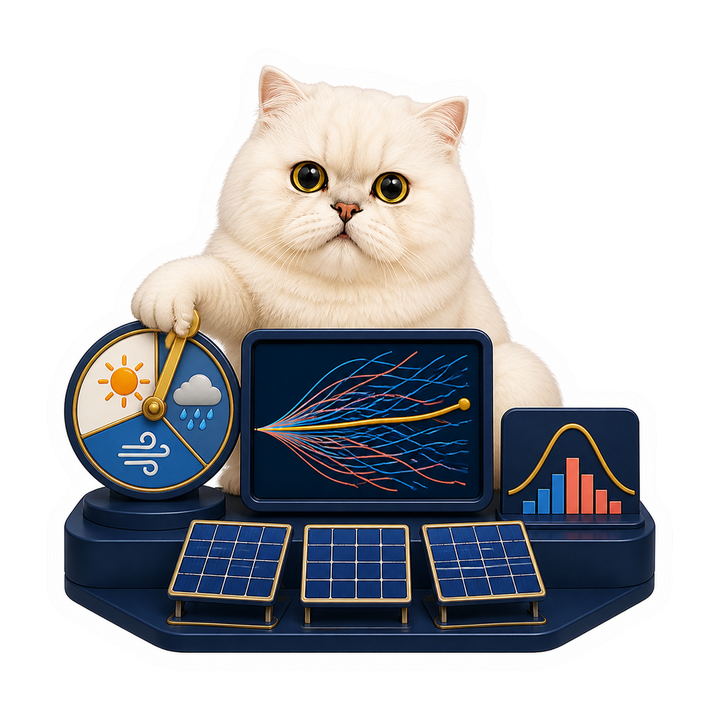
應對氣候隨機性:不要只猜一次未來,讓我們模擬一千個平行宇宙!
怎麼看這張圖?
一條線=一個單一預測,幾乎必錯的豪賭。十條線散開=看見不確定性。上千條隨機軌跡交疊,最終結果統計起來長出一條漂亮的鐘形常態分布。
重點不是猜中絕對數字,而是掌握風險區間與機率,例如「有 95% 信心發電量不低於某區間」。
核心精神:不求單一答案,求分布
面對隨機性,單一預測幾乎一定錯
蒙地卡羅的核心精神是不求單一答案,求分布。與其執著明天剛好是多少,不如跑很多次,看結果怎麼分布,同時得到期望值和風險區間。
模擬次數越多,樣本平均越逼近真值。誤差大約以 1/√N 的速度縮小;想準 10 倍,樣本要多 100 倍。這是大數法則的實際代價。
蒙地卡羅在強化學習裡怎麼用?
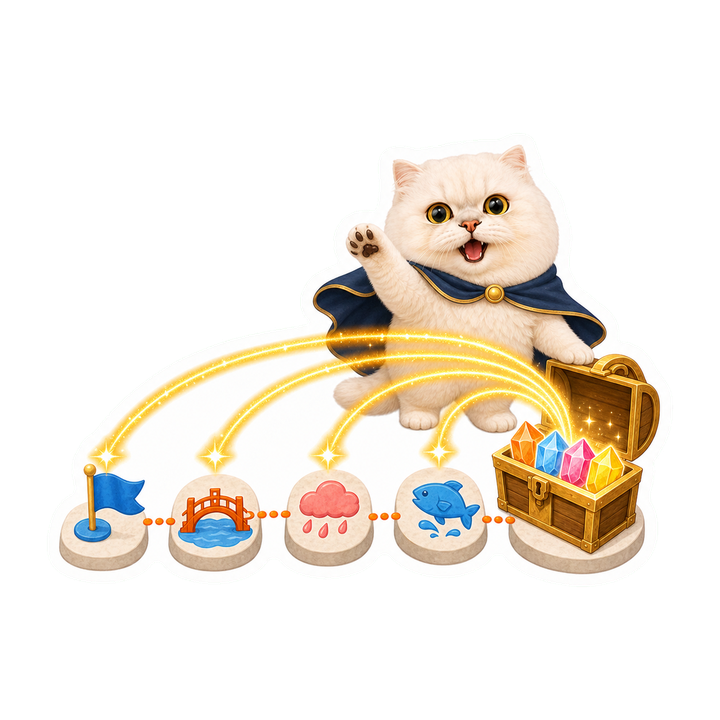
用完整一回合的實際回報估價值
RL 要估某狀態/動作有多好。蒙地卡羅法會把一整局 episode 玩到底,再用實際拿到的累積回報來更新估計,多玩幾局取平均。
它不需要環境模型(model-free),用的是真實回報;代價是要等整回合結束才能更新。
蒙地卡羅 vs 時序差分 TD:必考對比
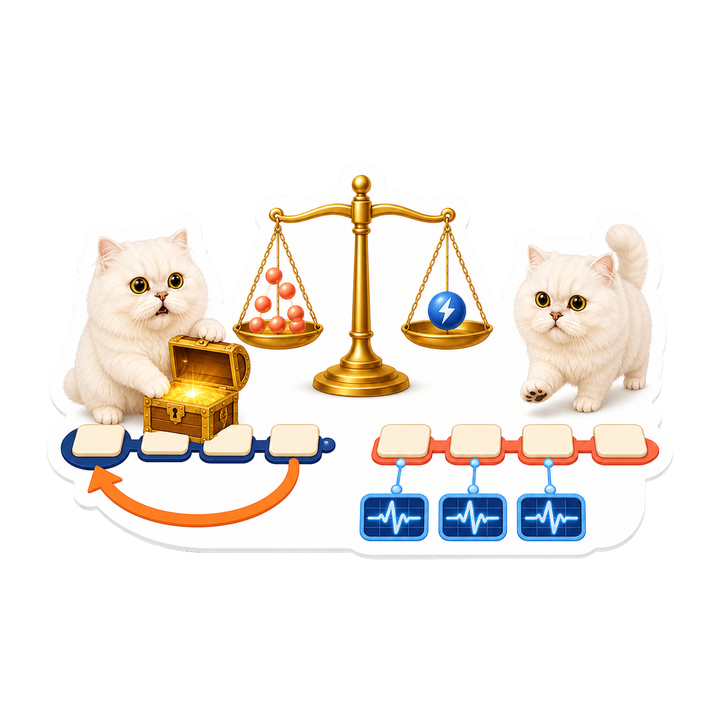
| 比較 | 蒙地卡羅(MC) | 時序差分(TD) |
|---|---|---|
| 何時更新 | 等整回合結束,用實際回報 | 每一步就用估計值更新 |
| 學習目標 | 真實累積回報 | r+γ×下一步的估計值(bootstrapping) |
| 偏差/變異 | 無偏但變異大 | 有偏但變異小 |
| 線上學習 | 否,要完整回合 | 可以,每步都能學 |
| 代表方法 | MC 價值估計 | Q-Learning、SARSA |
一句話記憶
MC=等答案揭曉再學,準但要等、抖。TD=邊走邊用猜的更新,快、可線上、較穩但有偏。這兩者的取捨是 RL 常考題。
優點與缺點
蒙地卡羅實務都用在哪?
解析解難算,就讓樣本上場
風險模擬(金融投組、氣候、工程可靠度);積分/期望估計(高維難算的積分);也能做 RL 價值估計。
蒙地卡羅樹搜尋 MCTS會用隨機模擬評估棋步,AlphaGo 就結合了 MCTS 與神經網路。凡是解析解難算但能重複隨機取樣的問題,蒙地卡羅都能上場。
觀念自我檢測
先想再點開;也可以先把答案收起來,逐題口述給貓老師聽。
Q1. 蒙地卡羅方法在做什麼?
用大量隨機取樣估計難以直接計算的數值;依大數法則,樣本越多越準。
Q2. 怎麼用灑點估 π?
正方形內灑點,圓內比例 × 4 ≈ π;點越多越準。
Q3. 為什麼不只做一次模擬?
隨機性下單次幾乎必錯;要看結果分布、風險區間而非單一數字。
Q4. 蒙地卡羅在 RL 怎麼估價值?
用完整回合的實際累積回報更新估計,多局取平均(model-free)。
Q5. MC 和 TD 差在哪?
MC:等整回合、用實際回報、無偏但變異大;TD:每步用估計值更新、有偏但變異小、可線上學。
30 秒重點整理
iPAS 考點提醒
蒙地卡羅方法用大量隨機取樣估計數值,是 iPAS 機率與 RL 考點(中級科目二與三)。當解析解難算時,靠重複隨機模擬取平均逼近期望或機率;樣本越多越準(大數法則)。
易混點:蒙地卡羅用完整回合的實際回報估值,時序差分 TD 用估計值逐步更新。誤差隨樣本數平方根下降,收斂較慢。常見情境是風險模擬、積分估計、RL 價值估計。想練情境題與詳解 → AI 學習與考證地圖
常見問題
蒙地卡羅方法是什麼?
用大量隨機取樣來估計難以直接計算的數值(如期望值、積分、機率);依大數法則,樣本越多估計通常越準。
能舉個直觀例子嗎?
估計圓周率 π:在正方形內隨機灑點,落在內接圓內的比例約等於圓與正方形的面積比,反推即可估 π,點越多越準。
在強化學習中怎麼用?
用完整一回合(episode)的實際累積回報來估計狀態或動作的價值,等回合結束才更新;不需環境模型,但要等回合走完。
蒙地卡羅和時序差分(TD)差在哪?
蒙地卡羅等整回合結束、用實際回報更新(無偏但變異大);TD 每步就用估計值更新(有偏但變異小、可線上學),Q-learning 即屬 TD。
蒙地卡羅的優缺點?
優點:概念簡單、無偏、不需轉移機率模型。缺點:變異大、需要完整回合(不適合持續性任務)、收斂可能較慢。