一個無聊到爆的規則,怎麼會統治整個世界?
大部分人第一次看到矩陣乘法,反應都一樣:「為什麼是這樣乘?」
橫的乘直的、對應位置相乘再相加、還不能交換順序⋯⋯看起來像某個數學家喝多了隨便定的規矩。更氣人的是,課本通常花三頁教你怎麼算,卻花零頁告訴你這在幹嘛。
但真相是這樣的:矩陣乘法不是被「定義」出來的,是被「發現」出來的。它是一個一旦你要「同時處理很多件事」就必然會長出來的形狀。你今天用的每一項技術,幾乎都躺在這個形狀上面:
你轉動遊戲鏡頭
每一幀、每一個頂點,都被四個 4×4 矩陣連乘一次。一個場景一秒鐘算幾千萬次。
ChatGPT 回你一個字
Transformer 從頭到尾就是矩陣乘法接矩陣乘法。所謂「參數量 700 億」,講的就是矩陣裡的格子數。
你套一個濾鏡
灰階、懷舊、增豔——每個像素的 RGB 被一個 3×3 矩陣乘一下,就變了一個世界。
Google 排搜尋結果
PageRank 的核心就是拿一個巨大的矩陣,對著網頁向量一直乘、一直乘,乘到它不再變。
喵。所以你手上那張 GPU,本質上是一台非常擅長矩陣乘法的機器——它別的都不太行,就這件事一秒能做幾十兆次。整個 AI 產業的硬體基礎,是建立在「橫的乘直的加起來」這個動作上的。
現在你懂為什麼值得花一小時把它搞清楚了吧?跟我來。
矩陣不是「一堆數字」,它有三種身份
矩陣長這樣,一個 2×3 的矩陣(2 列 3 行,先說列數再說行數,永遠是這個順序):
但重點不是它長怎樣,而是你把它想成什麼。同一個矩陣,換一種讀法,用途就完全不同。這三種身份你都要會,因為後面每個應用都在偷偷切換它們。
身份一:它是一張表(資料容器)
最直觀的用法。列代表「誰」,行代表「什麼屬性」。
| 牛奶(份) | 咖啡豆(份) | 糖漿(份) | |
|---|---|---|---|
| 拿鐵 | 2 | 1 | 0 |
| 摩卡 | 2 | 1 | 1 |
| 美式 | 0 | 1 | 0 |
這就是一個 3×3 的矩陣,一張再普通不過的 Excel 表。excel 表能做的事,矩陣都能做——而且做得更快。
身份二:它是一台機器(線性變換)
這是最重要的一種身份,也是課本最不會講的。把矩陣想成一個函數:你餵它一個向量,它吐一個向量給你。
輸入向量 ➜ 〔 矩陣 A 〕 ➜ 輸出向量
「旋轉 30 度」是一台機器。「放大兩倍」是一台機器。「把 3D 座標壓成 2D 螢幕座標」也是一台機器。而這些機器,全部都可以寫成一個矩陣。第四節我們會親眼看到它。
身份三:它是一疊向量(每一行都是一個東西)
把矩陣豎著切,每一行(column)都是一個獨立的向量。一個 768×10000 的矩陣,可以是「一萬個詞,每個詞用 768 個數字描述」——這正是語言模型裡的 embedding 表長的樣子。
身份一是 DataFrame,身份二是 function,身份三是 List[Vector]。矩陣乘法之所以強大,正是因為它讓這三件事變成同一個運算:一次函數呼叫,套用在一整批資料上。
記一個貓咪口訣:「列先行後、橫列直行」。列(row)是躺著的、橫的;行(column)是站著的、直的。中文的「行」很容易搞混,你就想「銀行的行員站成一直排」。搞錯這個,後面全部會爆炸喵。
矩陣 × 向量:一切的起點
先講清楚最小的情況。搞懂「矩陣乘向量」,「矩陣乘矩陣」就只是把它重複做很多次而已,真的沒別的了。
用一杯咖啡的成本來理解
回到剛剛那張配方表。現在給你今天的原料單價:牛奶一份 18 元、咖啡豆一份 25 元、糖漿一份 8 元。
問題:三種飲料各自的成本是多少?
算法就是你想的那樣,一列一列來:
- 拿鐵 =
2×18 + 1×25 + 0×8 = 36 + 25 + 0 = 61 - 摩卡 =
2×18 + 1×25 + 1×8 = 36 + 25 + 8 = 69 - 美式 =
0×18 + 1×25 + 0×8 = 0 + 25 + 0 = 25
看到沒?矩陣的每一「列」,去對上向量這一「直排」,對應位置乘一乘、加起來,就得到答案的一格。這個動作有個名字叫內積(dot product),它是整個線性代數的原子。
為什麼一定是「列 × 直排」?因為意義要對得上。配方表的第一行是「牛奶用量」,單價向量的第一格是「牛奶單價」——它們講的是同一件事,所以才配得起來。矩陣乘法的規則不是隨便定的,它只是在確保你乘的東西是同一個維度的東西。單位錯了就不能乘,跟你不能拿公斤加公里是一樣的道理喵。
另一種讀法:把答案看成「配方的加權混合」
上面是「橫著讀」。現在豎著讀一次,這個視角會讓你在第四節突然開竅。
把矩陣 R 拆成三個直行,分別是「牛奶欄」、「咖啡豆欄」、「糖漿欄」:
一模一樣的答案,但故事變了:輸入向量的每個數字,變成了矩陣每一直行的「權重」。18 是牛奶欄的權重、25 是豆子欄的權重、8 是糖漿欄的權重,三個欄位加權混合,就是輸出。
橫著讀(列的觀點):輸出的第 i 格 = 第 i 列跟輸入做內積。→ 適合算。
豎著讀(行的觀點):輸出 = 矩陣各直行的加權和,權重就是輸入。→ 適合懂。
兩種都要會。考試用第一種,想通用第二種。
新手最常見的災難:把兩個矩陣「對應格子相乘」(左上乘左上、右下乘右下)。那個叫 element-wise 乘法(Hadamard product),在 NumPy 裡是 A * B,跟矩陣乘法 A @ B 是完全不同的兩件事。寫 PyTorch 時搞混這個,模型不會報錯,只會安靜地學不起來——然後你 debug 三天。真的。
矩陣 × 矩陣:其實只是「一次算很多欄」
咖啡店開了第二家分店。台北店的原料比較貴,台中店比較便宜:
| 台北店單價 | 台中店單價 | |
|---|---|---|
| 牛奶 | 20 | 18 |
| 咖啡豆 | 28 | 25 |
| 糖漿 | 9 | 8 |
現在你不想算一次、再算一次。你想一次算出「三種飲料 × 兩間店」共六個成本。這時候,第二個東西就從「一個向量」長成「一個矩陣」了:
結果矩陣的左上角 68 是怎麼來的?拿左邊矩陣的第 1 列,去乘右邊矩陣的第 1 行:
2×20 + 1×28 + 0×9 = 40 + 28 + 0 = 68 (拿鐵在台北的成本)
右下角的 25?左邊第 3 列 × 右邊第 2 行:0×18 + 1×25 + 0×8 = 25(美式在台中的成本)。
結果矩陣第 i 列第 j 行的那一格 = 左邊矩陣的第 i 列 和 右邊矩陣的第 j 行 的內積。
講白話就是:「你在哪一格,就用哪一列配哪一行。」
寫成公式長這樣(看不懂沒關係,它講的就是上面那句話):
Cij = n Σ k=1 AikBkj
(Σ 的意思就是「把後面那串東西,從 k=1 一路加到 k=n」)
尺寸規則:中間要對得上,外面決定大小
- 中間兩個數字必須相同(金色的 3 和 3)。不一樣就不能乘,直接報錯。物理意義是:左邊矩陣「一列有幾格」,必須等於右邊矩陣「一行有幾格」,不然內積配不起來。
- 外面兩個數字,就是答案的尺寸(紅色的 3 和 2)。中間那個維度被吃掉了。
這個規則你會用一輩子。在 PyTorch 裡看到 RuntimeError: mat1 and mat2 shapes cannot be multiplied (32x768 and 512x256),翻譯成人話就是:中間對不上,768 ≠ 512。90% 的深度學習報錯,都是這句話的變體喵。
那到底誰乘誰?
用「機器」的觀點就很清楚了:A × B 的意思是 「先做 B,再做 A」。因為當它作用在向量 x 上時,寫出來是 A(Bx)——括號裡的 B 先碰到 x。
對,順序是由右往左讀的。這反直覺到讓無數人栽跟頭,但它是從「函數合成 f(g(x))」直接繼承來的。第五節有一整節專門修理這件事。
紙上看永遠隔一層。點下面結果矩陣的任何一格,看它是從哪一列、哪一行來的,以及完整的算式。左右兩個矩陣的數字都可以直接改,結果會即時重算。
提示:把左邊矩陣改成「對角線全是 1,其他都是 0」的樣子,看看結果會發生什麼事——那個叫單位矩陣,是矩陣界的數字 1。
順便說:為什麼工程師這麼愛它
假設你要處理 10000 筆資料,每筆都要做同一個線性變換。你可以寫一個迴圈跑一萬次⋯⋯或者,你把一萬筆資料疊成一個矩陣,做一次矩陣乘法。
結果完全一樣,但速度可能差 100 倍以上。因為矩陣乘法是幾十年來被最徹底優化的運算:CPU 有 SIMD、GPU 有 Tensor Core、還有 BLAS 這種被榨到極限的函式庫。「把迴圈改寫成矩陣乘法」是資料科學最基本的加速手法,行話叫 vectorization。
看得見的矩陣:它其實在對空間動手腳
好,計算部分你已經會了。現在來講那個讓一切「啊——原來如此」的部分。
把一個 2×2 矩陣乘上平面上的每一個點,會發生什麼事?答案是:整個平面被扭了一下。旋轉、拉伸、傾斜、翻面——全部都是。
只要看兩個向量,你就知道矩陣在幹嘛
這是本節的魔法。任何 2×2 矩陣,你只要問兩個問題:
- 原本指向右邊的單位向量 (1, 0),跑去哪了? → 答案就是矩陣的第一行。
- 原本指向上面的單位向量 (0, 1),跑去哪了? → 答案就是矩陣的第二行。
不用算,用看的。因為 (1,0) 乘進去,等於「第一行 ×1 + 第二行 ×0」,就是第一行本身(記得第二節「豎著讀」那招嗎?就是這裡用上的)。
金色這行 = 上向量 (0,1) 的新家
所以矩陣根本不是一堆數字。它是一份「搬家通知」:它只告訴你基本方向搬去哪,剩下所有點就跟著等比例搬過去。
拉動 a b c d 四個滑桿,看那隻貓被怎麼對待。紅色箭頭是 (1,0) 的去向、金色箭頭是 (0,1) 的去向——注意它們永遠等於矩陣的兩行。
玩玩看「壓成一條線」:此時 ad−bc = 0,整個平面被壓扁成一條直線,資訊回不來了——這就是行列式為 0 = 沒有反矩陣的真正意思。
行列式:面積被放大了幾倍
剛剛畫面上那個 ad − bc 有個名字叫行列式(determinant)。它的幾何意義非常單純:
det = 3→ 圖形面積變成 3 倍det = 1→ 面積不變(旋轉就是這種,它只轉不脹)det = −1→ 面積不變,但整個翻面了(照鏡子)det = 0→ 面積歸零,被壓扁成一條線甚至一個點,再也回不去
「回不去」這件事在工程上很要命。det ≈ 0 的矩陣叫病態矩陣,你去解它會得到爆炸的數字。這也是為什麼做機器學習時,大家要對權重做正規化、要加一點點 εI 在對角線上——都是在拜託矩陣不要被壓扁喵。
AB ≠ BA:矩陣界最重要的一條潛規則
數字乘法裡 3 × 5 = 5 × 3,天經地義。矩陣不是這樣。而且這不是什麼數學怪癖,它反映的是一件生活常識:
「動作」本來就有順序。矩陣是動作,所以矩陣有順序。會交換的才是特例,不會交換是常態。
來個具體的:先把一個東西旋轉 90 度,再水平拉寬 2 倍;跟先拉寬再旋轉——結果完全不同。下面自己選兩個動作試試看。
選兩個動作,左右兩邊會用不同順序執行同樣的兩件事。如果矩陣可以交換,兩邊應該長得一樣——看看是不是。
試試看:什麼時候兩邊會一樣?(提示:兩個都是旋轉的時候⋯⋯或其中一個是「等比例放大」的時候。這種特例叫可交換。)
三個你一定會踩到的實務地雷
3D 裡的旋轉與位移
「先轉再移」跟「先移再轉」差非常多。前者角色原地轉身,後者角色繞著世界原點公轉。很多人的第一個 3D 專案,角色都會莫名其妙飛出去。
寫成 xW 還是 Wx
數學課本習慣把向量寫成直的(Wx),深度學習框架習慣把一批資料寫成橫的(XW)。兩邊的矩陣互為轉置。看別人的公式時先確認這件事。
反矩陣要反過來脫
(AB)⁻¹ = B⁻¹A⁻¹,順序顛倒。就像脫衣服:先穿的後脫。這條公式的證明其實只是把這句話寫成數學。
不過矩陣還是很守規矩的:結合律成立,(AB)C = A(BC)。這條看似無聊的性質是效能金礦——如果 A 是 1000×1000、B 是 1000×1、C 是 1×1000,先算 (AB)C 跟先算 A(BC) 的計算量可以差上千倍。編譯器和深度學習框架就靠這個在偷偷幫你加速喵。
應用現場:它到底躲在哪裡?
這一節是本篇的重點。我保證你看完之後,會開始在生活裡到處看到矩陣乘法——有點像學會一個新單字之後突然每天都遇到它。
🎮 現場一:你正在玩的那款遊戲
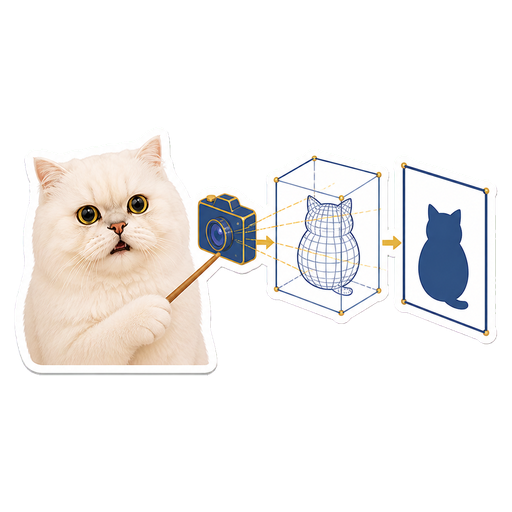
3D 遊戲裡的每一個物體,都是幾萬個「頂點座標」。要把它畫到你的螢幕上,這些座標得經過一連串加工:
| 階段 | 矩陣 | 它在做什麼 |
|---|---|---|
| Model | M | 把模型從「自己的座標」擺到世界裡:位置、朝向、大小 |
| View | V | 換成「攝影機看出去」的角度——其實是把整個世界反向搬到鏡頭前 |
| Projection | P | 把 3D 壓成 2D,並製造近大遠小的透視感 |
然後 GPU 每一幀對每個頂點做的事,就是這一行:
螢幕座標 = P × V × M × 頂點座標
而且因為結合律,引擎會先把 P·V·M 三個矩陣乘成一個,再拿去乘幾萬個頂點——一次算好,而不是每個頂點算三次。這是每個 3D 引擎都會做的第一號優化。
為什麼是 4×4 而不是 3×3?
因為平移(把東西整個搬走)不是線性變換。線性變換一定會把原點留在原地——你回頭看第四節那個實驗,不管怎麼拉滑桿,原點永遠不動。
那怎麼辦?數學家用了一招非常聰明的作弊:多加一個維度。把 3D 點 (x,y,z) 寫成 (x,y,z,1),然後用 4×4 矩陣的最後一行塞平移量:
那個多出來的 1 叫齊次座標。加一個假維度,就讓「平移」也變成了矩陣乘法,於是旋轉、縮放、平移可以全部串成一長串連乘。這個 hack 撐起了整個電腦圖學。
一個讓人有感覺的數字:一個角色模型大約 5 萬個頂點,遊戲跑 60 fps,畫面上有 20 個角色——光是頂點變換就是每秒 6000 萬次 矩陣乘法。而這還只是暖身,之後每個像素還要再跑一輪光照計算。你的顯示卡真的很努力喵。
🧠 現場二:AI 從頭到尾都是矩陣乘法
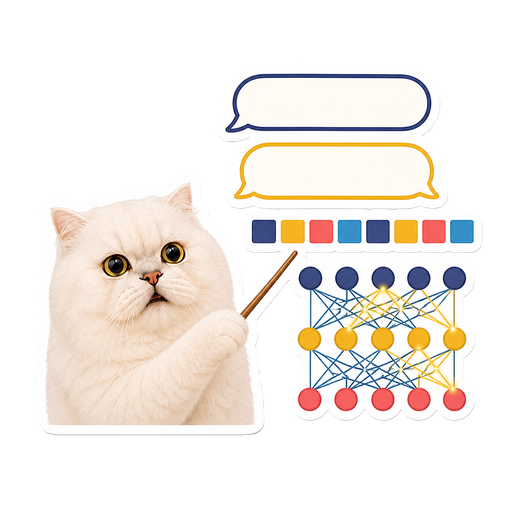
這句話不是比喻,是字面意思。神經網路的「一層」,數學上就是:
輸出 = 啟動函數( W × 輸入 + b )
把括號裡的東西拆開看:W 是權重矩陣,輸入是向量,中間那個 × 就是矩陣乘法。所謂「訓練模型」,就是在調整 W 裡面每一格數字。所謂「這個模型有 700 億參數」,講的就是所有 W 加起來一共有 700 億格。
批次處理:向量長成矩陣的那一刻
實務上沒有人一次只餵一筆資料。你會一次餵 32 筆(一個 batch),於是輸入從一個向量變成一個矩陣:
X (32×768) @ W (768×512) → 輸出 (32×512)
看那個中間對上的 768——第三節那條尺寸規則,你每天寫模型都在用它。而 32 這個維度就這樣被「免費」處理掉了:GPU 算 32 筆跟算 1 筆,花的時間幾乎一樣。這就是為什麼 batch size 是深度學習的第一個超參數。
Transformer 的注意力機制
ChatGPT 背後的核心公式,剝掉外殼之後是這樣:
Attention = softmax( Q Kᵀ / √d ) V
裡面有兩次矩陣乘法。Q Kᵀ 在做的事情非常直觀:Q 的每一列是「一個字在問什麼」,K 的每一列是「一個字能提供什麼」,兩兩做內積,就得到「第 i 個字該多注意第 j 個字」的分數表。
沒錯——內積在這裡被當成「相似度」在用。兩個向量方向越接近,內積越大。整個語意搜尋、向量資料庫、RAG,全都建立在這個小小的觀察上。
LoRA 微調:與其改動巨大的 W(比如 4096×4096,一千六百萬格),不如學兩個瘦瘦的矩陣 B (4096×8) 和 A (8×4096),用 W + BA 代替。參數量瞬間降到 1/250,效果卻幾乎一樣。這叫低秩分解。
量化:把矩陣裡的數字從 32 位元浮點數壓成 4 位元整數,模型體積縮成 1/8,還是能跑。因為矩陣乘法本身對一點點誤差意外地寬容。
📷 現場三:一個 3×3 矩陣就是一個濾鏡
照片裡每個像素就是一個三維向量 (R, G, B)。你想改變照片的色調?拿一個 3×3 矩陣去乘每一個像素就好了。
例如灰階:人眼對綠色最敏感、藍色最遲鈍,所以標準做法是用 0.299R + 0.587G + 0.114B 當亮度,然後三個通道都填這個值——寫成矩陣就是三列一模一樣。
下面 9 個格子就是色彩矩陣。直接改數字(或按預設鈕),右邊的圖會即時重算。每一列決定「新的 R / G / B 各自要用多少舊的 R、G、B 調配出來」。
發現了嗎:「調亮」做不到。因為變亮需要「加上一個常數」,而矩陣乘法只會做加權混合,永遠碰不到原點——這就是為什麼繪圖軟體的色彩矩陣其實是 3×4,多出來的那一欄就是第六節開頭講的齊次座標把戲。
順便說:卷積其實也是矩陣乘法
CNN 裡的卷積看起來是「小方框在圖片上滑來滑去」,跟矩陣乘法八竿子打不著。但實作上,GPU 會用一招叫 im2col 的技巧,把所有滑窗攤平重排成一個大矩陣,然後——你猜對了——做一次矩陣乘法。
因為業界花了半世紀把矩陣乘法優化到極致,把任何問題轉換成矩陣乘法,通常就是最快的解法。這在計算領域是個反覆出現的主題。
📊 現場四:預測明年會發生什麼事
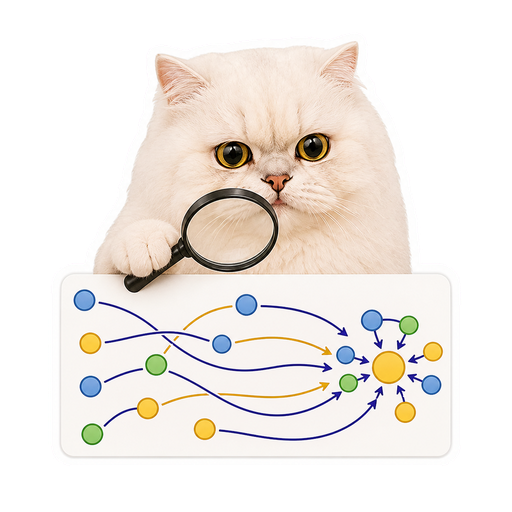
假設有一份人口流動統計:住台北的人,每年有 85% 留下、8% 搬去台中、7% 搬去高雄⋯⋯把這些機率排成一個矩陣,然後拿它乘上今年的人口分布,就得到明年的分布。
再乘一次,得到後年。再乘一次⋯⋯這就叫馬可夫鏈,而「一直乘下去」的結果會很有趣。
兩個城市從完全不同的起點出發:左邊所有人都住台北,右邊所有人都住高雄。按下「過一年」,看它們各自演化——然後注意一件驚人的事。
兩邊收斂到同一個分布了對吧?這個最終不動的分布叫穩態,也就是矩陣的「特徵向量」。無論起點是什麼,一直乘同一個矩陣,系統都會忘記自己從哪裡來。
這正是 Google PageRank 的原理。把「使用者隨機點連結」的行為寫成一個超巨大的矩陣(幾十億 × 幾十億),拿一個初始向量一直乘、一直乘,收斂後每個網頁的分數就是它的重要性。Google 靠一個線性代數習題起家,這件事永遠不會不好笑喵。
🧩 現場五:其他你想不到的地方
推薦系統
「使用者 × 電影」的評分表有 99% 是空的。把它拆成兩個瘦矩陣相乘(矩陣分解),空格就被自動補上了——這就是 Netflix 猜你喜歡什麼的方法。
統計迴歸
最小平方法的解是 (XᵀX)⁻¹Xᵀy。你在 Excel 拉一條趨勢線,背後跑的就是這個矩陣式子。
密碼學
Hill 密碼把文字轉成數字向量,乘一個秘密矩陣就加密了;解密就是乘反矩陣。現代加密更複雜,但精神一樣。
機器手臂
每一個關節是一個 4×4 變換矩陣,全部連乘起來,就知道手掌末端在空間中的位置。這叫正向運動學。
產業關聯分析
鋼鐵業要用電、電力業要用鋼⋯⋯這種互相依賴寫成矩陣,可以算出「終端需求增加一億,各產業各要生產多少」。政府做經濟評估在用。
量子計算
量子閘就是矩陣,量子態就是向量。一段量子程式,數學上完全等同於一串矩陣連乘。
地圖與 GPS
不同座標系之間的轉換(WGS84、TWD97⋯⋯)靠的是旋轉加平移矩陣。你的定位跑掉幾百公尺,通常是矩陣用錯了。
音訊處理
傅立葉轉換寫成矩陣形式就是一次矩陣乘向量。MP3 壓縮、降噪、Shazam 聽歌辨曲,起點都在這。
動手練:不算過三次,永遠不算會
理解跟熟練是兩回事。矩陣乘法是那種你必須用手算過幾次,指尖才會記得的東西。下面這台出題機會一直出題,答錯不會扣分,只會給你完整解析。
填入結果矩陣的每一格,按「對答案」。算錯的格子會標紅並附上算式。建議至少做到連續兩題全對再往下走。
速查表與常見誤區
你一定要記得的六件事
| # | 規則 | 白話 |
|---|---|---|
| 1 | (m×n)(n×p) = (m×p) | 中間要一樣,外面決定答案大小 |
| 2 | Cᵢⱼ = 第 i 列 · 第 j 行 | 你在哪一格,就用哪一列配哪一行 |
| 3 | AB ≠ BA | 先穿襪子再穿鞋,順序不能亂 |
| 4 | (AB)C = A(BC) | 括號可以搬,順序不能換(效能關鍵) |
| 5 | AI = IA = A | 單位矩陣是矩陣界的 1 |
| 6 | (AB)ᵀ = BᵀAᵀ | 轉置和反矩陣都會把順序倒過來 |
五個新手最常翻車的地方
- 把矩陣乘法當成對應格子相乘。
A @ B和A * B是兩種東西,NumPy/PyTorch 都不會提醒你。 - 以為可以交換。 化簡式子時手滑把
AB寫成BA,整題就毀了。 - 行列搞混。 「列」是橫的、「行」是直的。英文 row/column 反而比較不會錯。
- 以為 AB = 0 就代表 A 或 B 是零矩陣。 不對!兩個非零矩陣相乘可以是零矩陣,因為它們可能把彼此壓扁到不同的維度去。
- 忘記檢查維度就開始算。 先看尺寸能不能對上,可以省下很多眼淚。
接下來可以往哪走
如果今天這些你都吃下去了,你已經站在整個線性代數的入口。往前走的順序建議是:單位矩陣與反矩陣 → 行列式 → 線性方程組(高斯消去)→ 特徵值與特徵向量 → 奇異值分解(SVD)。
其中特徵值會回答一個你今天已經偷偷遇過的問題:「一直乘同一個矩陣,系統會跑去哪裡?」——就是實驗室五那個穩態。而 SVD 則是推薦系統、資料壓縮、PCA 降維的共同引擎。
🐾 貓老師 Mochi的最後幾句話
矩陣乘法之所以看起來奇怪,是因為課本先給了你規則,卻沒給你故事。但你現在知道故事了:它是「一次對很多東西做同一件事」的最精簡寫法。咖啡成本表是這樣、遊戲裡的鏡頭是這樣、幾百億參數的語言模型也是這樣。
而且它最迷人的地方在於——同一個運算,在不同的領域裡穿不同的衣服。在美術系那邊它叫濾鏡,在遊戲引擎那邊它叫變換,在機器學習那邊它叫一層網路。你今天學會的是同一件事的所有版本。
如果一時之間覺得資訊量有點大,那是正常的,不是你的問題。真正的建議只有一個:回到實驗室六,用手算五題。手算過的東西才會變成直覺,看過的只會變成印象。
然後,記得起來走動一下、喝點水。腦袋跟貓一樣,關在同一個姿勢太久會變得很難用喵。