偏差–變異權衡:模型的兩種錯誤,此消彼長
模型犯錯有兩種來源:偏差(太簡單、老是猜偏)和變異(太敏感、換批資料就變)。麻煩的是——壓低一個常會讓另一個變大。學會在兩者間找平衡,就是調模型的核心功夫。這是 過擬合/欠擬合 背後的理論。
🏹 一、先用白話講:像在射箭
靶心=正確答案。射很多箭,看它們落在哪,就能分辨兩種錯誤:
📌 考試重點
模型太簡單 → 高偏差(欠擬合);模型太複雜 → 高變異(過擬合)。兩者此消彼長,要找平衡點!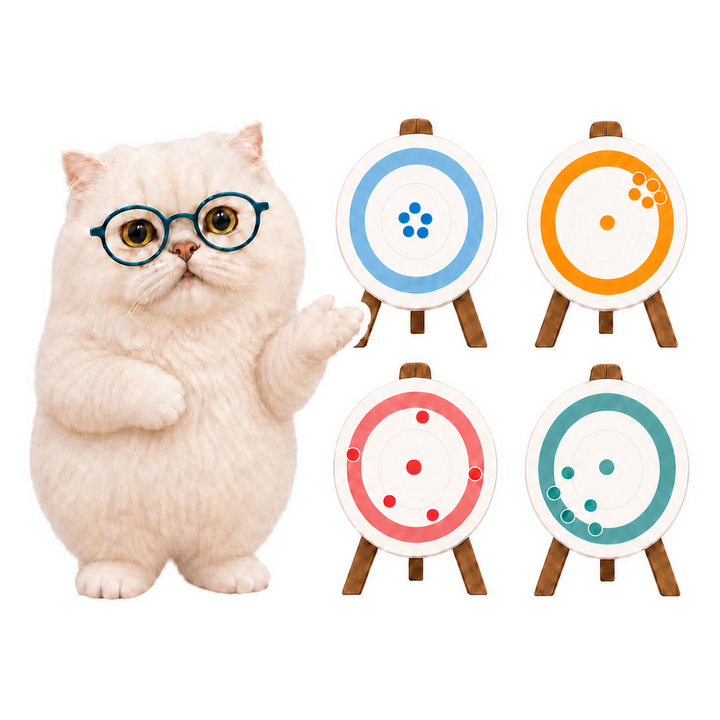
🎯 二、四種射箭結果對照
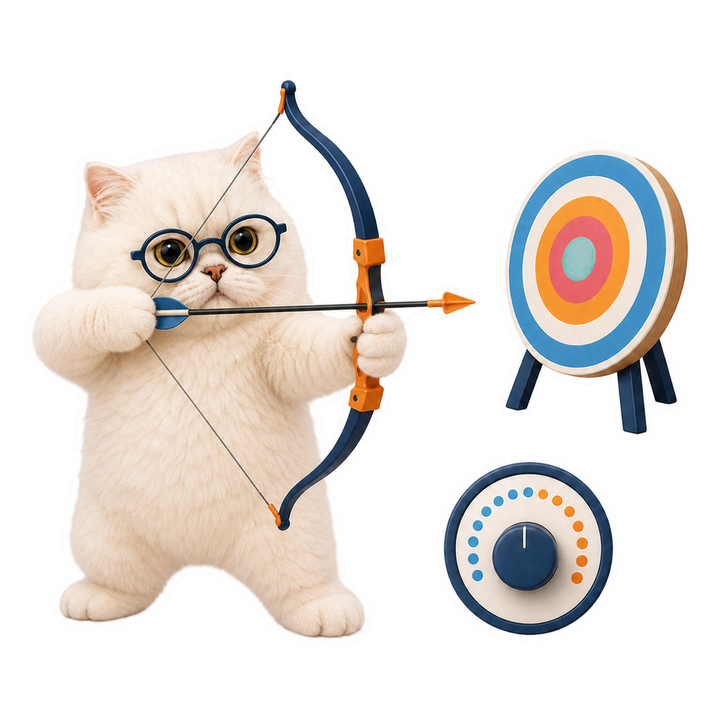
🎮 三、動手玩:射靶 + 誤差分解圖
拖「模型複雜度」滑桿,看上排靶心的箭如何從「集中射偏」變「分散命中」;下方誤差分解圖同步顯示 Bias²、Variance、Total 三條線與甜蜜點。按「射 10 箭」重射。
可用方向鍵微調模型複雜度;圖表會同步更新偏差、變異、總誤差與最佳點。
📊 誤差分解圖(拖動滑桿觀察變化)
🗺️ 怎麼看
複雜度低(左):靶上的箭集中射偏一角(高偏差、低變異)。複雜度高(右):箭散開、平均在靶心附近但很亂(低偏差、高變異)。下方圖:Bias² 一路下降、Variance 一路上升,兩者相加的 Total 呈 U 形——U 形的谷底就是甜蜜點。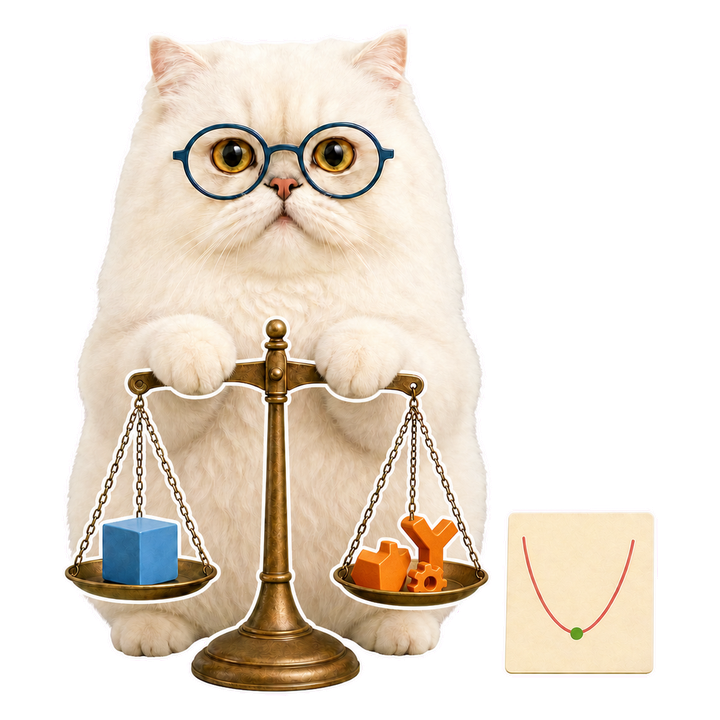
⚖️ 四、為什麼「此消彼長」?
🧮 五、誤差分解公式
總泛化誤差 ≈ 偏差² + 變異 + 不可消除誤差
模型的預期誤差可拆成三塊:• 偏差²(Bias²):系統性偏離,隨複雜度下降。
• 變異(Variance):對資料的敏感度,隨複雜度上升。
• 不可消除誤差(Irreducible Error):資料本身的雜訊,怎麼調都消不掉(圖中那條水平虛線)。
我們能控制的只有前兩項,目標是讓偏差²+變異之和最小,而不是單獨壓低某一個。
🩺 六、怎麼判斷「現在是偏差還是變異問題」?
💊 七、降偏差 vs 降變異,藥方不同
| 問題 | 高偏差(欠擬合) | 高變異(過擬合) |
|---|---|---|
| 核心 | 模型太簡單 | 模型太複雜/太敏感 |
| 對策 | 加複雜度、加特徵、減正則化、訓練更久 | 增資料/資料增強、加正則化(L1/L2/Dropout)、簡化、early stopping |
| 增加資料有用嗎 | 幫助有限 | 很有用 |
🌲 八、集成學習怎麼幫忙?
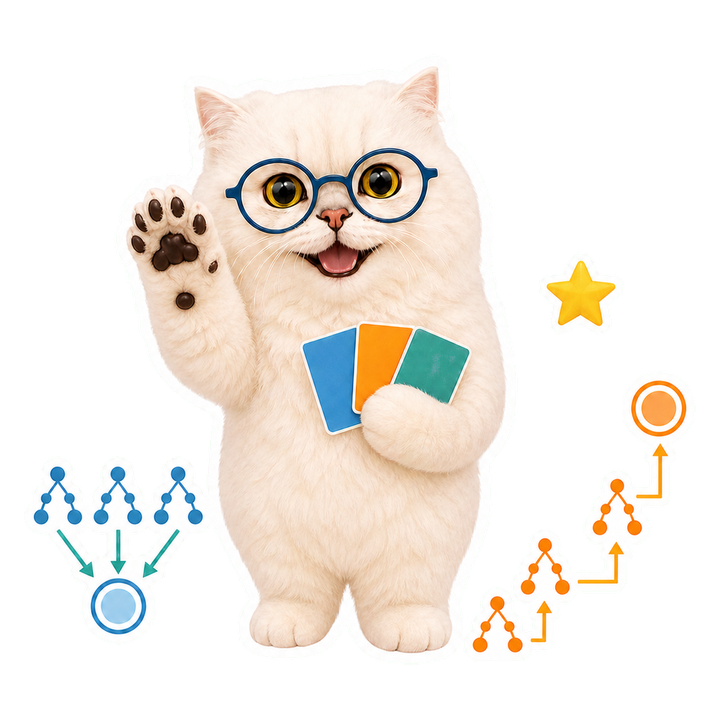
📌 Bagging 降變異、Boosting 降偏差
Bagging(如隨機森林):訓練多棵樹再平均,主要降低變異(把不穩定的結果平均掉)。Boosting(如 GBDT/XGBoost):一步步修正前面的錯,主要降低偏差。所以集成是調控偏差-變異的利器,詳見 集成學習。🧪 九、觀念自我檢測
先想再點開。
Q1. 偏差和變異各是什麼?
偏差=模型太簡單、系統性偏離真實(欠擬合);變異=對訓練資料太敏感、換批資料就大變(過擬合)。
Q2. 為什麼有「權衡」?
複雜度↑ 會讓偏差↓ 但變異↑(反之亦然),被同一旋鈕反向牽動,只能找總和最小。
Q3. 總誤差的三個組成?
偏差² + 變異 + 不可消除誤差;最後一項是資料雜訊,消不掉。
Q4. 訓練誤差就很高,是偏差還變異問題?
高偏差(欠擬合)。若訓練低、驗證高且差距大,才是高變異。
Q5. 隨機森林主要降哪一個?
主要降變異(多樹平均);Boosting 則主要降偏差。
✅ 十、30 秒重點整理
📝 iPAS 考點提醒
偏差-變異權衡是 iPAS 模型評估的核心觀念(中級科目三)。重點:模型太簡單會高偏差(欠擬合)、太複雜會高變異(過擬合),目標是兩者平衡使總誤差(泛化誤差)最小。易混點:增加複雜度降偏差但升變異、反之亦然;正則化、增資料、集成都是調控手段。情境:診斷模型是欠擬合還是過擬合、決定下一步(加特徵還是加正則化)。
想練情境題與詳解 → AI 學習與考證地圖
❓ 常見問題
偏差和變異各代表什麼?
偏差(bias)是模型假設太簡單、系統性偏離真實規律(欠擬合);變異(variance)是模型對訓練資料太敏感、換一批資料結果就大變(過擬合)。
為什麼有「權衡(tradeoff)」?
模型變複雜通常偏差下降但變異上升,反之亦然;總泛化誤差約等於偏差平方加變異加不可約誤差,目標是讓兩者之和最小,而非單獨壓低一個。
怎麼判斷是偏差還是變異問題?
訓練誤差就很高代表高偏差(欠擬合);訓練誤差低但驗證誤差高、兩者差距大代表高變異(過擬合)。看學習曲線最直接。
高偏差怎麼改善?
增加模型複雜度、加入更多有意義特徵、減少正則化、訓練更久;對純高偏差,增加資料量幫助有限。
高變異怎麼改善?
增加資料或資料增強、正則化(L1/L2、Dropout)、簡化模型、提早停止、用集成(如 bagging)降變異。