把 NumPy 載入,之後用 np 叫它。第 11 行的 np.random.binomial 就是從這裡拿的。
Question 39 · NumPy · 正則化
隨機把一些輸出變成 0,再除以 p:
這段程式是 Dropout
第 39 題的 6 行程式,用亂數做出一張只有 0 和 1 的「遮罩」,乘到輸入上、再除以 p,而且只在訓練時做。這頁先用「合唱團排練」比喻講清楚為什麼要隨機丟、為什麼要除以 p,再逐行拆開程式,實際執行看每一步做出的物件:抽到哪幾個、10 萬次平均會不會回到原值、預測時交回的是不是同一個物件;最後把 L1、L2、Batch Normalization 和 PyTorch 的 nn.Dropout 擺在一起比。
Python 3.13NumPy 2.4PyTorch 2.6(對照)
def … training=Trueif / elsenp.random.binomialx * mask / p
Dropout正則化零基礎可讀
讀完這頁,你會知道
- 過度擬合是什麼、Dropout 為什麼「隨機丟」就能減少它,以及為什麼留下來的要除以 p(合唱團比喻+實測)
- 預設參數
training=True、if / else兩條路,以及預測時return x交回的是同一個物件 np.random.binomial(1, p, size=x.shape)做出什麼:每格擲一次籤的 0/1 陣列(實測一次抽到哪幾個)- 除以 p 讓平均不變:同一份輸入訓練 10 萬次,平均回到原值;不除以 p,平均只剩 p 倍
- L1、L2、Dropout、Batch Normalization 各在做什麼;題目的
p是「保留」的機率,PyTorch 的nn.Dropout(p)是「丟掉」的機率
§0
題目
附圖程式碼實現的是哪一種正則化技術?
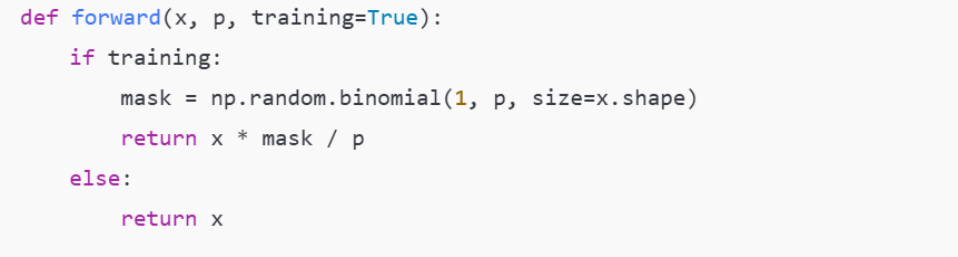
先憑直覺選一個,讀完再回來對照:
先抓程式裡的三個線索
① np.random.binomial(1, p, size=x.shape):每一格擲一次籤,機率 p 得到 1、否則 0,做出和 x 一樣形狀的遮罩。② x * mask / p:遮罩是 0 的位置被歸零(丟掉),留下來的放大 1/p 倍。③ if training: … else: return x:只在訓練時隨機丟,預測時原封不動。三個線索合起來就是 Dropout;先放大、預測時不用調整的寫法,叫反轉 Dropout(inverted dropout)。
這題只有一個函式,這頁拆的是什麼?
原題沒說 x、p 是什麼。§3 補上「前情提要」:x 是某一層 8 個神經元的輸出,p = 0.8(每個輸出有 80% 的機率留下),並固定亂數種子 42,讓你在自己電腦上跑出和這頁一樣的結果。
§1
先補基本功:讀懂這 6 行需要的 6 個觀念
這節先用白話講「過度擬合」和 Dropout 為什麼有效,再講這 6 行用到的 Python 與 NumPy:預設參數、if/else、亂數遮罩、陣列運算和兩種 return。中間有兩支動畫:先用合唱團排練看懂「隨機丟、再放大」,最後打開記憶體看呼叫 forward 時做出了哪些物件;每支動畫前後都有文字說明。
① 過度擬合觀念 1
為什麼要隨機丟
→
為什麼要隨機丟
② 合唱團排練動畫 1
抽籤、放大、正式演出
→
抽籤、放大、正式演出
③ 參數・亂數・陣列觀念 2~6
→
④ 記憶體實況動畫 2
呼叫 forward 的每一步
呼叫 forward 的每一步
第 3 支動畫(四種正則化對照+選項)放在 §4,和抽籤機一起看。
觀念 1|過度擬合,和 Dropout 為什麼要「隨機丟」
神經網路很會「背答案」:訓練資料上幾乎全對,換成沒看過的資料就失準,這叫過度擬合(overfitting)。常見原因是模型太依賴少數幾個神經元、幾個特徵,只要它們出一點差錯,整個答案就跟著錯。
正則化(regularization)是一群「不讓模型背答案」的方法的統稱。Dropout 的做法最直接:每次訓練都隨機把一部分神經元的輸出變成 0。這一次第 2 個沒出聲,下一次換第 4 個,模型沒辦法只靠固定的幾個神經元,只好讓每個神經元都學到有用的東西。
訓練時每次隨機丟掉一部分
留下的放大 1/p 倍
→
留下的放大 1/p 倍
預測時全部留下
不丟、也不放大
不丟、也不放大
為什麼留下的要放大?丟掉 20% 之後,這一層輸出的總量會變小;除以 p(本例 0.8,等於乘 1.25),平均就和全部留下時一樣。這樣預測時什麼都不用改,直接交回原本的輸出。
看動畫 1 之前:這支要回答什麼
觀念 1 用文字講了 Dropout「隨機丟、再放大」。動畫 1 先用 8 個人的合唱團排練來比喻:每次排練每人擲一次籤、沒抽中的休息、上場的唱大聲一點,正式演出時全員上場;接著換回程式,用實測的遮罩一步一步算出 x * mask / p,最後看 10 萬次平均、不除以 p 會怎樣,以及預測時的 return x。
帶著三個問題看:① 上場的人為什麼要唱大聲 1.25 倍?② 同樣的 x,兩次訓練丟掉的位置一樣嗎?③ 不除以 p,平均會變成多少?
看的時候注意:綠色的 1 是留下、粉紅的 0 是丟掉;長條上的紅線是原本的 x。
動畫 1合唱團排練:隨機休息、上場的唱大聲一點2 分 15 秒・有旁白,也有字幕
合唱團只是比喻。程式那段的遮罩(種子 42:[1, 0, 1, 1, 1, 1, 1, 0]、第二次 [1, 1, 1, 0, 0, 1, 1, 1])、10 萬次平均、100 萬個 1 的平均 0.8007/1.0008,都是 NumPy 2.4.3 實際執行的結果。
看完動畫 1,你應該能回答:上場的人為什麼要唱大聲 1.25 倍?
每個人只有 80% 的機會上場,少了人總音量會變小;上場的放大 1 ÷ 0.8 = 1.25 倍,排練很多次平均下來,總音量就和全員到齊時差不多(實測 7.29 對 7.3)。
同樣的 x,兩次訓練丟掉的位置一樣嗎?
不一樣。每呼叫一次就重新抽籤:第一次丟掉第 2、8 個,第二次丟掉第 4、5 個。模型因此不能只靠固定的幾個神經元。
不除以 p,平均會變成多少?
只剩 p 倍:100 萬個 1,不除以 p 的平均是 0.8007;除以 p 之後是 1.0008。
觀念 2|預設參數:training=True
def forward(x, p, training=True):
x、p必填參數呼叫時一定要給,少給會出錯(實測
forward(x):TypeError: forward() missing 1 required positional argument: 'p')。training=True有預設值的參數不給就當成 True;要預測時寫
training=False。預設值存在函式物件身上(實測 forward.__defaults__ 是 (True,))。所以 forward(x, p) 就是訓練模式,forward(x, p, training=False) 是預測模式。第三個參數也可以照位置給:forward(x, p, False),效果一樣,但寫出名字比較好讀。
觀念 3|if / else:兩條路,只會走一條
if training:          # training 是 True → 走這條
    …
else:                 # training 是 False → 走這條
    return x
冒號後面縮排的程式屬於那條路。if training: 不用寫成 if training == True:,直接判斷就好。兩條路裡都有 return,所以不管走哪條,函式都會在那裡結束、交回結果。
觀念 4|np.random.binomial(1, p, size=x.shape):每格擲一次籤
binomial(n, p) 是「擲 n 次、每次成功機率 p,成功了幾次」。n = 1 就是只擲一次:成功得到 1、失敗得到 0。size=x.shape 要它一次做出和 x 一樣形狀的一整排。
>>> np.random.seed(42)
>>> np.random.binomial(1, 0.8, size=(8,))
array([1, 0, 1, 1, 1, 1, 1, 0], dtype=int32)
8 格裡有 6 個 1、2 個 0:第 2 格和第 8 格這次被丟掉。每次呼叫都會重新抽,所以每一輪訓練丟掉的位置都不同。np.random.seed(42) 是固定亂數起點,讓結果可以重現,實際訓練時不會這樣寫。
遮罩的型別在這台 Windows 電腦實測是 int32;在 Linux 或 Google Colab 上通常是 int64。不影響結果。擲 10 次的例子:np.random.binomial(10, 0.8, size=5) 實測得到 array([7, 9, 8, 6, 6]),每格是「10 次裡成功幾次」。
觀念 5|x * mask / p:逐元素相乘,再整排除以 p
| 位置 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
|---|---|---|---|---|---|---|---|---|
| x | 0.5 | 1.2 | 0.0 | 2.0 | 0.8 | 1.5 | 0.3 | 1.0 |
| mask | 1 | 0 | 1 | 1 | 1 | 1 | 1 | 0 |
| x * mask | 0.5 | 0 | 0 | 2.0 | 0.8 | 1.5 | 0.3 | 0 |
| ÷ 0.8 | 0.625 | 0 | 0 | 2.5 | 1.0 | 1.875 | 0.375 | 0 |
由左到右算:先 x * mask(逐元素相乘,做出新陣列),再 / p(每一格除以 0.8,也就是乘 1.25)。第 3 格原本就是 0,乘 1 還是 0。整數遮罩乘上小數陣列,結果自動變成小數(float64)。
觀念 6|兩種 return:一個交回新陣列,一個交回原物件
- 訓練時
return x * mask / p:交回計算做出的新陣列,原本的 x 沒被改。 - 預測時
return x:交回的就是傳進來的那一個陣列(實測forward(x, p, training=False) is x是 True,id 相同),沒有複製、也沒有計算。
這正是反轉 Dropout 的好處:訓練時已經除過 p,預測時不必做任何調整。
把 6 個觀念串起來:本題的「類別 → 物件 → 方法」路線
① 類別(設計圖)
亂數產生器(
function(def 照它做)numpy.ndarray亂數產生器(
np.random 背後的 RandomState)→
② 物件
每次訓練新做出的
forward、x、p每次訓練新做出的
mask、x * mask、x * mask / p→
③ 呼叫函式和方法
forward(x, p) → np.random.binomial(…) → *(__mul__)→ /(__truediv__)把觀念合起來:呼叫 forward 時,記憶體裡發生什麼
看動畫 2 之前:這支要回答什麼
觀念 2~6 講了預設參數、if/else、binomial 遮罩、陣列運算和兩種 return。動畫 2 打開記憶體,把 forward(x, p) 一步一步走完:遮罩、x * mask、/ p 各做出哪個新陣列(id 都是實測),函式結束後誰被回收;再看預測模式交回的是不是同一個物件,最後是兩種寫錯的情況。
帶著三個問題看:① 預設值 training=True 存在哪裡?② 訓練時一共做出幾個新陣列?原本的 x 有沒有被改?③ 預測時交回的陣列,和傳進去的是同一個嗎?
動畫 2打開記憶體:遮罩、新陣列,和原封不動的 x2 分 8 秒・有旁白,也有字幕
id、型別、遮罩都取自同一次實際執行(Python 3.13.7、NumPy 2.4.3,種子 42);id 每次執行都不一樣。遮罩的 int32 是這台 Windows 電腦的結果,Linux/Colab 通常是 int64。
看完動畫 2,你應該能回答:預設值 training=True 存在哪裡?
存在函式物件身上:實測
forward.__defaults__ 是 (True,)。呼叫時沒給 training,就拿這個值。訓練時一共做出幾個新陣列?原本的 x 有沒有被改?
三個:遮罩 mask、
x * mask、x * mask / p。最後一個被 return 交回去,前兩個沒有名牌指著就被回收。原本的 x 沒被改。預測時交回的陣列,和傳進去的是同一個嗎?
是。
return x 交回的就是原本那個陣列,實測 is 是 True、id 相同。§2
認識四個選項:四種正則化各在做什麼
L1 正則化(選項 A)
在 loss 後面加「權重絕對值的總和」當罰金
權重 0.5、−1.2、0.8 的罰金是 0.5 + 1.2 + 0.8 = 2.5。會把不重要的權重壓到剛好 0:實測同一份資料,scikit-learn 的 Lasso(L1)8 個權重有 5 個是 0。
L2 正則化(選項 B)
在 loss 後面加「權重平方的總和」當罰金
同樣的權重,罰金是 0.25 + 1.44 + 0.64 = 2.33。讓權重整體變小但很少剛好是 0:實測 Ridge(L2)8 個權重沒有一個是 0。
Dropout(選項 C,本題)
訓練時隨機把一部分輸出歸零
不碰 loss,直接改「這一層的輸出」:遮罩是 0 的位置變 0,其餘放大 1/p 倍;預測時不做。題目的程式就是這個。
Batch Normalization(選項 D)
把每一批的輸出拉回平均 0、標準差 1
再乘上可學的 gamma、加上 beta。實測把本頁的 x 標準化,8 格裡沒有任何一格變成 0,平均 0、標準差 1。它不隨機,也不歸零。
題目的 p 和 PyTorch 的 p 意思相反
| 寫法 | p(或 rate)代表 | 實測:10 個 1 經過訓練模式 |
|---|---|---|
本題 forward(x, 0.8) | 保留的機率 0.8 | 留下的變成 1.25,丟掉的變成 0 |
PyTorch nn.Dropout(p=0.2) | 丟掉的機率 0.2 | [1.25, 1.25, 0, 1.25, …];.eval() 之後全部是 1 |
Keras layers.Dropout(rate=0.2) | 丟掉的機率 0.2 | 留下的同樣放大 1 ÷ 0.8 = 1.25 倍 |
所以 PyTorch 的 nn.Dropout(0.2) 等於本題的 p = 0.8。PyTorch 是 2.6.0 實測;Keras 的放大倍數和本站 115-01 第 47 題的實測(Dropout(0.25) 留下的變成 1.3333)一致。
§3
逐行解剖
原題只有第 9~14 行。為了讓程式真的能跑,前面補了「前情提要」(8 個神經元的輸出、p = 0.8、固定亂數種子),後面補了三次呼叫。左邊是完整程式(點任一行可以跳到解說),右邊往下捲時,左邊會自動標出目前講到哪一行。手機上會改成上下排列。
q39.py19 行
讓接下來的亂數每次都從同一個起點開始,你在自己電腦上跑,會抽到和這頁一樣的遮罩。
np.random 是 NumPy 的亂數模組,背後有一個全域的亂數產生器;seed(42) 設定它的起點。42 只是慣例,換成任何整數都可以,結果就不同。真正訓練時通常不固定,讓每次抽籤都不一樣。
假想神經網路某一層有 8 個神經元,這是它們這一次的輸出,做成 NumPy 陣列。
執行後:
x → ndarray [0.5, 1.2, 0.0, 2.0, 0.8, 1.5, 0.3, 1.0] shape (8,) dtype float64
第 3 個是 0:ReLU 之類的激活函數常會輸出 0,這裡故意放一個,看 Dropout 對它有沒有影響(沒有,0 怎麼乘都是 0)。
每個神經元這次有 80% 的機率留下、20% 的機率被丟掉。
注意這裡的 p 是「保留」的機率。PyTorch 的 nn.Dropout(p)、Keras 的 Dropout(rate) 都是「丟掉」的機率,剛好相反(§2)。
做好一個叫 forward 的函式:要給它輸入 x 和保留機率 p;第三個參數 training 不給的話就是 True(訓練模式)。
forward函式名稱「往前算」:神經網路裡,資料從前一層往後一層算的那一步。PyTorch 每一層的計算方法也叫 forward。
training=True預設參數實測
forward.__defaults__ 是 (True,)。執行後多了:
forward → function 物件(第 10~14 行還沒跑)
如果現在是訓練模式,就執行下面縮排的兩行(抽籤、乘遮罩)。
呼叫 forward(x, p) 沒給 training,用預設的 True,所以走這條路。
替 8 個神經元各擲一次籤:80% 機率得到 1(留下)、20% 得到 0(丟掉),做成和 x 一樣形狀的陣列,貼上名牌 mask。
逐字拆解
np.random.binomial函式二項分布:擲 n 次、每次成功機率 p,回傳成功次數。
1n每格只擲 1 次,所以結果只有 0 或 1。
p成功機率0.8:得到 1 的機率。
size=x.shape屬性
x.shape 是 x 的形狀 (8,);做出同形狀的陣列,等一下才能逐元素相乘。這一行執行時發生什麼事(第一次呼叫,實測)
執行後:
mask → 新陣列 [1, 0, 1, 1, 1, 1, 1, 0] dtype int32(Windows 實測;Linux/Colab 通常 int64)
↑ 第 2、第 8 個這次被丟掉
新手常踩的坑
- 把 p 當成丟掉的機率:本題 p = 0.8 代表留下 80%;想丟掉 80%,p 要設 0.2。
- p 設成 0:全部丟掉,再除以 0,實測 8 格全變成
nan,並出現RuntimeWarning: invalid value encountered in divide。
輸入乘上遮罩(被丟掉的變 0),再整排除以 p(留下的放大 1.25 倍),把結果交回去。
一步一步(第一次呼叫,實測)
執行順序由左到右:
x * mask → 新陣列 [0.5, 0. , 0. , 2. , 0.8, 1.5, 0.3, 0. ]
( … ) / p → 新陣列 [0.625, 0. , 0. , 2.5, 1. , 1.875, 0.375, 0. ] ← return 交回這個
為什麼要除以 p
每個輸出平均只有 80% 的機會留下,不放大的話,這一層的輸出平均會變成原本的 0.8 倍。實測 100 萬個 1:不除以 p 的平均是 0.8007;除以 p 之後是 1.0008,回到 1。同一份 x 訓練 10 萬次再平均,每一格都回到原值附近(例如 1.2 → 1.1982、2.0 → 1.9989)。
原始論文的做法是訓練時不放大、預測時乘上 p;先在訓練時除以 p 的寫法叫「反轉 Dropout」,好處是預測時什麼都不用改。PyTorch、Keras 都是這種寫法。
新手常踩的坑
- 忘了
/ p:訓練和預測時的輸出大小不一致,模型在預測時會整體偏大。 - 傳 list 進來:list 沒有
.shape,實測AttributeError: 'list' object has no attribute 'shape'。
不是訓練模式(預測、評估時),就直接把 x 交回去,不抽籤、不放大。
實測:
forward(x, p, training=False) is x → True(交回的是同一個物件,id 相同)
因為訓練時已經除過 p,平均已經和全部留下時一樣,預測時用完整的輸出就好。
連續用訓練模式呼叫兩次,再用預測模式呼叫一次,把結果印出來。
印出(實測,種子 42):
[0.625 0. 0. 2.5 1. 1.875 0.375 0. ] ← 第 2、8 個被丟掉
[0.625 1.5 0. 0. 0. 1.875 0.375 1.25 ] ← 這次換第 4、5 個
[0.5 1.2 0. 2. 0.8 1.5 0.3 1. ] ← 預測:原封不動
同一個 x、同一個 p,兩次訓練丟掉的位置不同:每呼叫一次就重新抽籤。這種「每次隨機少幾個」的訓練,就是 Dropout 減少過度擬合的方式。
§4
互動實驗:Dropout 抽籤機
按「訓練一次」就是呼叫一次 forward(x, p):在你的瀏覽器裡為 8 個神經元各抽一次籤,算出 x * mask / p。多按幾次(或一次抽 1,000 次),看右邊的「累計平均」怎麼慢慢回到 x;關掉「除以 p」,平均會停在 x 的 p 倍。
試試看:把 p 拉到 0.5、按「再抽 1,000 次」,留下來的值變成多少?累計平均呢?
留下的放大 1 ÷ 0.5 = 2 倍(例如 1.2 → 2.4),大約一半變 0;累計平均仍會回到 x 附近。
關掉「除以 p」再抽 1,000 次,累計平均會停在哪?
停在 x 的 p 倍附近(p = 0.8 時,2.0 → 約 1.6)。這就是為什麼要除以 p:不除的話,訓練和預測時的輸出大小對不起來。
按「預測一次」,為什麼每一格都和 x 一樣?
training=False 走 else,直接
return x:不抽籤、不放大,交回的就是原本那個陣列。看動畫 3 之前:這支要回答什麼
上面的抽籤機讓你自己看平均怎麼回到 x。動畫 3 把四個選項擺在一起:L1、L2 的罰金怎麼算(Lasso/Ridge 實測權重)、Batch Normalization 實際把 x 變成什麼,再回到 Dropout 的三個線索,看題目的 p 和 PyTorch 的 p 有什麼不同,最後對選項。
帶著三個問題看:① L1、L2 改的是「輸出」還是「loss」?② BN 會不會把輸出變成 0?③ PyTorch 的 nn.Dropout(0.2) 等於題目的 p 多少?
動畫 3四種正則化對照,再對選項2 分 13 秒・有旁白,也有字幕
Lasso/Ridge 的權重是 scikit-learn 1.8.0 在同一份模擬資料(make_regression,8 個特徵、種子 0、alpha=5)上實際訓練的結果;BN 的數值是 NumPy 標準化,和 PyTorch BatchNorm1d 相同到小數第 3 位;nn.Dropout 是 PyTorch 2.6.0 實測。
看完動畫 3,你應該能回答:L1、L2 改的是「輸出」還是「loss」?
loss:在 loss 後面加上權重的罰金(L1 是絕對值總和,L2 是平方和),不會去改每一層的輸出。實測 L1 的 Lasso 讓 8 個權重中 5 個剛好是 0。
BN 會不會把輸出變成 0?
不會。BN 是減平均、除以標準差,再乘 gamma、加 beta;實測把 x 標準化,8 格沒有一格是 0,也沒有亂數。
PyTorch 的 nn.Dropout(0.2) 等於題目的 p 多少?
0.8。PyTorch 的 p 是丟掉的機率,題目的 p 是保留的機率;實測
nn.Dropout(0.2) 訓練時留下的變成 1.25,和題目 p = 0.8 一樣。§5
回到題目:逐項對答案
(A) L1 正則化 錯
L1 是在 loss 後面加上權重絕對值的總和當懲罰,程式裡會看到對權重取 abs 再加總、加到 loss 上。題目的程式沒有碰 loss,也沒有權重,只是把輸出隨機歸零。
(B) L2 正則化 錯
L2 加的是權重平方的總和(也叫 weight decay),讓權重整體變小。同樣要對權重算、加在 loss 上,題目的程式裡都沒有。
(C) Dropout 正解
binomial(1, p) 做 0/1 遮罩 → 乘上輸入(隨機歸零)→ 除以 p(平均不變)→ 只在 training 時做、預測時 return x。這就是 Dropout 的反轉寫法。實測同一份輸入訓練 10 萬次,平均回到原值;預測時交回同一個物件。
(D) Batch Normalization 錯
BN 是把一批資料的輸出減掉平均、除以標準差,再乘 gamma、加 beta,沒有亂數、也不會把輸出歸零(實測標準化本頁的 x,8 格沒有一格是 0)。
記一張表就夠:看程式認正則化
| 程式裡看到 | 是哪一個 |
|---|---|
| loss + λ × 權重絕對值總和 | L1 |
loss + λ × 權重平方總和(或優化器的 weight_decay) | L2 |
| 亂數 0/1 遮罩 × 輸出、除以保留機率、只在訓練時(本題) | Dropout |
| (輸出 − 平均)÷ 標準差,再 × gamma + beta | Batch Normalization |
§6
動手跑跑看:10 萬次平均、100 萬個 1、PyTorch 對照
下面的程式用原題的 forward 做三個實驗:同一份 x 訓練 10 萬次再平均、100 萬個 1 留下多少(以及不除以 p 會怎樣)、預測時是不是同一個物件;最後和 PyTorch 的 nn.Dropout 對照。需要 NumPy 和 PyTorch,複製到 Google Colab 就能執行(幾秒鐘)。
import numpy as np
import torch

def forward(x, p, training=True):          # 原題的程式
    if training:
        mask = np.random.binomial(1, p, size=x.shape)
        return x * mask / p
    else:
        return x

x = np.array([0.5, 1.2, 0.0, 2.0, 0.8, 1.5, 0.3, 1.0])
p = 0.8

# 1. 同一份 x 訓練 10 萬次:每次丟掉的不一樣,但平均會回到 x
np.random.seed(0)
runs = np.stack([forward(x, p) for _ in range(100_000)])
print('10 萬次的平均:', runs.mean(axis=0).round(4))
print('原本的 x     :', x)

# 2. 100 萬個 1:留下多少?平均多少?沒除以 p 會怎樣?
np.random.seed(1)
big = np.ones((1000, 1000))
out = forward(big, p)
print('留下的比例:', (out != 0).mean(), ' 出現的值:', np.unique(out), ' 平均:', out.mean().round(4))
np.random.seed(1)
no_scale = big * np.random.binomial(1, p, size=big.shape)
print('沒除以 p 的平均:', no_scale.mean().round(4))

# 3. 預測時:原封不動交回同一個物件
print('預測時是同一個物件嗎?', forward(x, p, training=False) is x)

# 4. PyTorch 的 nn.Dropout:p 是「丟掉」的機率
torch.manual_seed(0)
drop = torch.nn.Dropout(p=0.2)            # 丟掉 20% = 本題的 p = 0.8
drop.train()
print('PyTorch 訓練模式:', drop(torch.ones(10)))
drop.eval()
print('PyTorch 預測模式:', drop(torch.ones(10)))
實際跑出來的結果
在 Python 3.13.7、NumPy 2.4.3、PyTorch 2.6.0(CPU)實際執行:
10 萬次的平均: [0.5011 1.1982 0.     1.9989 0.7973 1.4975 0.2999 1.0003]
原本的 x     : [0.5 1.2 0.  2.  0.8 1.5 0.3 1. ]
留下的比例: 0.800665  出現的值: [0.   1.25]  平均: 1.0008
沒除以 p 的平均: 0.8007
預測時是同一個物件嗎? True
PyTorch 訓練模式: tensor([1.2500, 1.2500, 0.0000, 1.2500, 1.2500, 1.2500, 1.2500, 1.2500, 1.2500,
        1.2500])
PyTorch 預測模式: tensor([1., 1., 1., 1., 1., 1., 1., 1., 1., 1.])
- 10 萬次平均回到 x:每一格都在原值附近(差不到 0.003),這就是除以 p 的效果。第 3 格原本是 0,永遠是 0。
- 100 萬個 1:留下 80.07%,留下的都變成 1.25;平均 1.0008。不除以 p 的話平均只剩 0.8007。
- PyTorch:
nn.Dropout(p=0.2)丟掉 20%、留下的變 1.25,和本題 p = 0.8 一樣;.eval()之後原封不動。
| 新出現的語法 | 是什麼 | 白話 |
|---|---|---|
[forward(x, p) for _ in range(100_000)] | 串列推導式 | 呼叫 10 萬次,把每次的結果收成一個 list;_ 表示用不到的計數變數,100_000 的底線只是方便閱讀 |
np.stack(…) | NumPy 函式 | 把 10 萬個長度 8 的陣列疊成 10 萬列 × 8 欄 |
runs.mean(axis=0) | 陣列方法 | 沿著第 0 軸(往下)平均:每一欄各平均一次,得到 8 個數 |
(out != 0).mean() | 布林陣列 | 不是 0 的位置是 True(算 1),平均就是「留下的比例」 |
np.unique(out) | NumPy 函式 | 列出出現過哪些不同的值 |
drop.train()/drop.eval() | PyTorch 方法 | 切換訓練/預測模式,等於本題的 training=True/False |
§7
一頁總結+自我檢測
這題要帶走的 6 件事
- Dropout:訓練時隨機把一部分輸出歸零,讓模型不能只靠少數神經元,減少過度擬合。答案 (C)。
np.random.binomial(1, p, size=x.shape):每格擲一次籤,機率 p 得到 1,做出和 x 同形狀的 0/1 遮罩;每次呼叫都重新抽。x * mask / p:丟掉的變 0,留下的放大 1/p 倍,平均不變(實測 10 萬次平均回到 x;不除以 p 只剩 0.8 倍)。- 預設參數
training=True;預測時return x交回同一個物件,不抽籤、不放大。這叫反轉 Dropout。 - 題目的 p 是保留機率;PyTorch
nn.Dropout(p)、KerasDropout(rate)是丟掉機率。 - L1、L2 是加在 loss 上的權重罰金(L1 會讓權重剛好變 0);BN 是標準化,沒有亂數、也不歸零。
p = 0.5 時,留下來的輸出會放大幾倍?
1 ÷ 0.5 = 2 倍。大約一半的輸出變 0,另一半變兩倍,平均不變。
想用 PyTorch 做出和本題 p = 0.8 一樣的效果,要寫什麼?
nn.Dropout(p=0.2):PyTorch 的 p 是丟掉的機率,1 − 0.8 = 0.2。把 / p 拿掉,訓練還能跑嗎?會有什麼問題?
能跑,但訓練時輸出平均只有 p 倍,預測時卻是完整大小,兩邊對不起來。要嘛訓練時除以 p(反轉 Dropout),要嘛預測時乘上 p(原始論文的做法)。
預測時為什麼不能也隨機丟?
預測要的是穩定、可重現的答案;每次丟掉不同的神經元,同一張圖會得到不同的結果。所以預測時全部留下,
return x。Batch Normalization 也有「訓練/預測」兩種模式,它和 Dropout 有什麼不同?
BN 訓練時用這一批的平均、標準差,預測時改用訓練期間累積的平均值;兩種模式都不會把輸出隨機歸零。Dropout 才是隨機歸零。